notnull() मेथड एक बूलियन मान लौटाता है यानी यदि डेटाफ्रेम में नल मान हैं, तो False लौटाया जाता है, अन्यथा True।
मान लीजिए निम्नलिखित हमारी CSV फ़ाइल है जिसमें कुछ NaN यानी नल मान हैं:
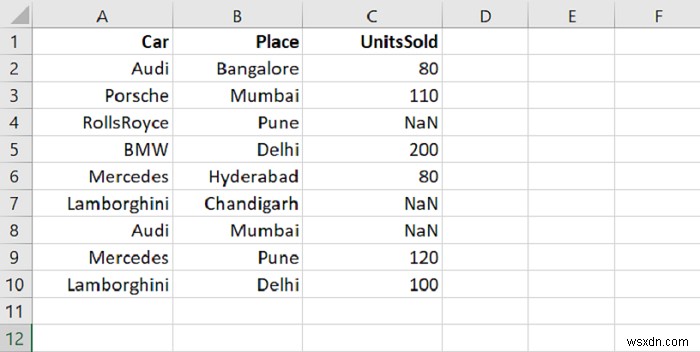
पहले CSV फ़ाइल पढ़ें:
dataFrame = pd.read_csv("C:\\Users\\amit_\\Desktop\\CarRecords.csv")
नल नहीं मानों की जांच करें:
res = dataFrame.notnull()
अब, डेटाफ्रेम प्रदर्शित करने पर, CSV डेटा True और False के रूप में यानी बूलियन मानों में प्रदर्शित होगा क्योंकि notnull() बूलियन लौटाता है। नल मानों के लिए False प्रदर्शित होगा। नल-नहीं मानों के लिए True प्रदर्शित होगा।
उदाहरण
निम्नलिखित पूरा कोड है:
import pandas as pd
# CSV फ़ाइल पढ़ें
dataFrame = pd.read_csv("C:\\Users\\amit_\\Desktop\\CarRecords.csv")
print("DataFrame...\n", dataFrame)
# डेटाफ्रेम में पंक्तियों और कॉलम की गिनती करें
print("\nNumber of rows and column in our DataFrame = ", dataFrame.shape)
res = dataFrame.notnull()
print("\nDataFrame displaying False for Null (NaN) value = \n", res)
dataFrame = dataFrame.dropna()
print("\nDataFrame after removing null values...\n", dataFrame)
print("\n(Updated) Number of rows and column in our DataFrame = ", dataFrame.shape)
आउटपुट
यह निम्नलिखित आउटपुट उत्पन्न करेगा:
DataFrame...
   Car      Place  UnitsSold
0  Audi  Bangalore     80.0
1 Porsche  Mumbai    110.0
2 RollsRoyce Pune      NaN
3  BMW    Delhi      200.0
4 Mercedes Hyderabad   80.0
5 Lamborghini Chandigarh NaN
6  Audi    Mumbai     NaN
7 Mercedes  Pune     120.0
8 Lamborghini Delhi   100.0
Number of rows and column in our DataFrame = (9, 3)
DataFrame displaying False for Null values =
   Car   Place  UnitsSold
0 True  True    True
1 True  True    True
2 True  True    False
3 True  True    True
4 True  True    True
5 True  True    False
6 True  True    False
7 True  True    True
8 True  True    True
DataFrame after removing null values...
   Car      Place  UnitsSold
0  Audi  Bangalore     80.0
1 Porsche  Mumbai    110.0
3  BMW    Delhi      200.0
4 Mercedes Hyderabad   80.0
7 Mercedes  Pune     120.0
8 Lamborghini Delhi   100.0
(Updated)Number of rows and column in our DataFrame = (6, 3)