Computer >> कंप्यूटर ट्यूटोरियल >  >> प्रोग्रामिंग >> Python

पायथन - पैंडास डेटाफ्रेम में अनंत मानों के लिए True प्रदर्शित करें


अनंत मानों के लिए True प्रदर्शित करने के लिए isin() मेथड का उपयोग करें। सबसे पहले, अपने संबंधित उपनामों के साथ आवश्यक लाइब्रेरी इम्पोर्ट करें –

import pandas as pd
import numpy as np

लिस्ट का एक डिक्शनरी बनाएं। हमने Numpy np.inf का उपयोग करके अनंत मान सेट किए हैं –

d = {
    "Reg_Price": [7000.5057, np.inf, 5000, np.inf, 9000.75768, 6000, 900, np.inf]
}

उपरोक्त डिक्शनरी ऑफ लिस्ट से डेटाफ्रेम बनाएं –

dataFrame = pd.DataFrame(d)

अनंत मानों के लिए True प्रदर्शित करें –

res = dataFrame.isin([np.inf, -np.inf])

उदाहरण

निम्न कोड है –

import pandas as pd
import numpy as np
# लिस्ट का डिक्शनरी
d = {
    "Reg_Price": [7000.5057, np.inf, 5000, np.inf, 9000.75768, 6000, 900, np.inf]
}
# उपरोक्त डिक्शनरी ऑफ लिस्ट से डेटाफ्रेम बनाएं
dataFrame = pd.DataFrame(d)
print "DataFrame...\n", dataFrame
# अनंत मानों की जांच और गिनती प्रदर्शित करना
count = np.isinf(dataFrame).values.sum()
print "\nInfinity values count...\n ", count
# अनंत मानों के लिए TRUE प्रदर्शित करना
res = dataFrame.isin([np.inf, -np.inf])
print "\n Updated DataFrame...\n", res

आउटपुट

यह निम्न आउटपुट उत्पन्न करेगा –

DataFrame...   Reg_Price
0  7000.505700
1          inf
2  5000.000000
3          inf
4  9000.757680
5  6000.000000
6   900.000000
7          inf
Infinity values count...   3
Updated DataFrame...   Reg_Price
0  False
1  True
2  False
3  True
4  False
5  False
6  False
7  True
  1. पायथन पैंडास - notnull() का उपयोग करके नल मानों की जांच करें पायथन पैंडास - notnull() का उपयोग करके नल मानों की जांच करें

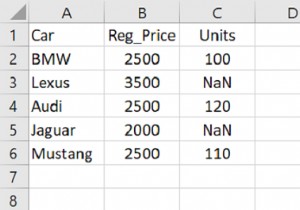
    notnull() मेथड एक बूलियन मान लौटाता है यानी यदि डेटाफ्रेम में नल मान हैं, तो False लौटाया जाता है, अन्यथा True। मान लीजिए निम्नलिखित हमारी CSV फ़ाइल है जिसमें कुछ NaN यानी नल मान हैं: पहले CSV फ़ाइल पढ़ें: dataFrame = pd.read_csv(C:\\Users\\amit_\\Desktop\\CarRecords.csv) नल नहीं मानों की जांच करे

  1. पायथन पैंडास - इंटरपोलेशन मेथड का उपयोग करके NaN मान भरें पायथन पैंडास - इंटरपोलेशन मेथड का उपयोग करके NaN मान भरें

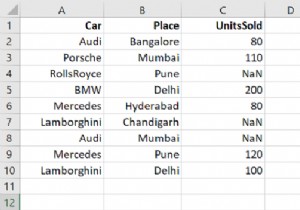
    NaN मान भरने के लिए interpolate() मेथड का उपयोग करें। मान लीजिए निम्नलिखित हमारी CSV फ़ाइल है जिसे माइक्रोसॉफ्ट एक्सेल में कुछ NaN मानों के साथ खोला गया है: CSV फ़ाइल से डेटा लोड करके पैंडास डेटाफ्रेम में डालें: dataFrame = pd.read_csv(C:\\Users\\amit_\\Desktop\\SalesData.csv) interpolate() के साथ

  1. पायथन पैंडास - गैर-नल मानों को पीछे की ओर प्रसारित करें पायथन पैंडास - गैर-नल मानों को पीछे की ओर प्रसारित करें

    fillna() मेथड के method पैरामीटर का उपयोग करें। बैकवर्ड फिल के लिए, मान bfill का उपयोग करें जैसा कि नीचे दिखाया गया है: fillna(method=bfill) मान लीजिए निम्नलिखित हमारी CSV फ़ाइल है जिसे माइक्रोसॉफ्ट एक्सेल में कुछ NaN मानों के साथ खोला गया है: पहले आवश्यक लाइब्रेरी आयात करें: import pandas as pd C