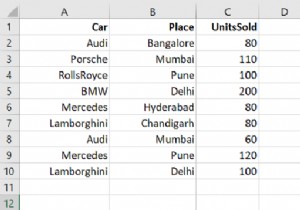
पैंडास डेटाफ्रेम में नल पंक्तियों को हटाने के लिए, dropna() मेथड का उपयोग करें। मान लीजिए निम्नलिखित हमारी CSV फ़ाइल है जिसमें कुछ NaN यानी नल मान हैं:
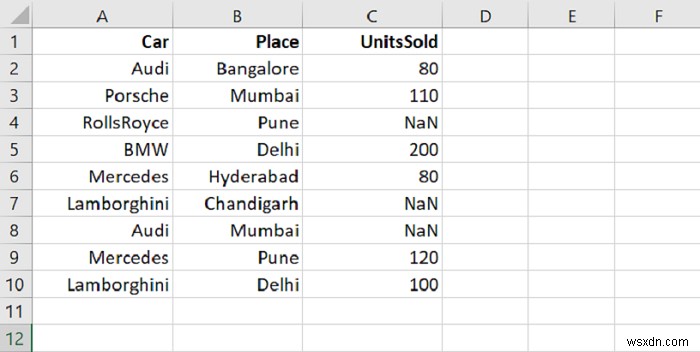
read_csv() का उपयोग करके CSV फ़ाइल पढ़ें। हमारा CSV डेस्कटॉप पर है:
dataFrame = pd.read_csv("C:\\Users\\amit_\\Desktop\\CarRecords.csv")
dropna() का उपयोग करके नल मान हटाएं:
dataFrame = dataFrame.dropna()
उदाहरण
निम्नलिखित पूरा कोड है:
import pandas as pd
# CSV फ़ाइल पढ़ें
dataFrame = pd.read_csv("C:\\Users\\amit_\\Desktop\\CarRecords.csv")
print("DataFrame...\n", dataFrame)
# डेटाफ्रेम में पंक्तियों और कॉलम की गिनती करें
print("\nNumber of rows and column in our DataFrame = ", dataFrame.shape)
dataFrame = dataFrame.dropna()
print("\nDataFrame after removing null values...\n", dataFrame)
print("\n(Updated) Number of rows and column in our DataFrame = ", dataFrame.shape)
आउटपुट
यह निम्नलिखित आउटपुट उत्पन्न करेगा:
DataFrame...
   Car      Place  UnitsSold
0  Audi  Bangalore     80.0
1 Porsche  Mumbai    110.0
2 RollsRoyce Pune      NaN
3  BMW    Delhi      200.0
4 Mercedes Hyderabad   80.0
5 Lamborghini Chandigarh NaN
6  Audi    Mumbai     NaN
7 Mercedes  Pune     120.0
8 Lamborghini Delhi   100.0
Number of rows and column in our DataFrame = (9, 3)
DataFrame after removing null values...
   Car      Place  UnitsSold
0  Audi  Bangalore     80.0
1 Porsche  Mumbai    110.0
3  BMW    Delhi      200.0
4 Mercedes Hyderabad   80.0
7 Mercedes  Pune     120.0
8 Lamborghini Delhi   100.0
(Updated) Number of rows and column in our DataFrame = (6, 3)