पंक्तियों के सबसेट का चयन करने के लिए शर्तों का उपयोग करें और डेटा प्राप्त करें।
मान लीजिए हमारी CSV फ़ाइल की सामग्री Microsoft Excel में निम्नलिखित है:
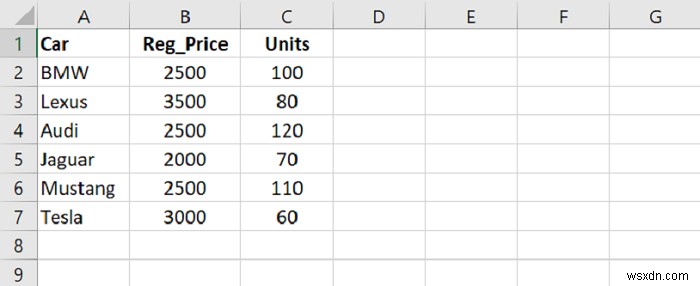
सबसे पहले, CSV फ़ाइल से डेटा पैंडास DataFrame में लोड करें:
dataFrame = pd.read_csv("C:\\Users\\amit_\\Desktop\\SalesData.csv")मान लीजिए हम "Units" 100 से अधिक वाले कार रिकॉर्ड चाहते हैं यानी पंक्तियों का सबसेट। इसके लिए उपयोग करें:
dataFrame[dataFrame["Units"] > 100]
अब, मान लीजिए हम "Reg_Price" 3000 से कम वाले कार रिकॉर्ड चाहते हैं यानी पंक्तियों का सबसेट। इसके लिए उपयोग करें:
dataFrame[dataFrame["Reg_Price"] < 3000]
उदाहरण
कोड निम्नलिखित है:
import pandas as pd
# CSV फ़ाइल से डेटा पैंडास DataFrame में लोड करें
dataFrame = pd.read_csv("C:\\Users\\amit_\\Desktop\\SalesData.csv")
print("\nReading the CSV file...\n", dataFrame)
# दो कॉलम प्रदर्शित करना
res2 = dataFrame[['Reg_Price', 'Units']]
print("\nDisplaying two columns : \n", res2)
# पंक्तियों के सबसेट का चयन करना
print("\nSelect cars with Units more than 100: \n", dataFrame[dataFrame["Units"] > 100])
# पंक्तियों के सबसेट का चयन करना
print("\nSelect cars with Reg_Price less than 3000: \n", dataFrame[dataFrame["Reg_Price"] < 3000])
आउटपुट
यह निम्नलिखित आउटपुट उत्पन्न करेगा:
Reading the CSV file...    Car  Reg_Price  Units
0  BMW  2500  100
1  Lexus  3500  80
2  Audi  2500  120
3  Jaguar  2000  70
4  Mustang  2500  110
Displaying only one column Car:  Reg_Price  Units
0  2500  100
1  3500  80
2  2500  120
3  2000  70
4  2500  110
Name: Car, dtype: object
Select cars with Units more than 100:    Car  Reg_Price  Units
2  Audi  2500  120
4  Mustang  2500  110
Select cars with Reg_Price less than 3000:    Car  Reg_Price  Units
0  BMW  2500  100
2  Audi  2500  120
3  Jaguar  2000  70
4  Mustang  2500  110