Excel में गुणात्मक डेटा का विश्लेषण करने के तरीके खोज रहे हैं? तो यह लेख आपके लिए सही है। जब डेटा को गिना नहीं जा सकता और संख्यात्मक मूल्यों का उपयोग करके समझाना कठिन होता है, तो डेटा गुणात्मक होता है। हम इस गुणात्मक डेटा को फोकस ग्रुप चर्चा, गहन साक्षात्कार, वाक्य पूर्णता, शब्द संघ, आकस्मिक बातचीत आदि से एकत्र कर सकते हैं।
Excel में गुणात्मक डेटा का विश्लेषण करने के 8 चरण
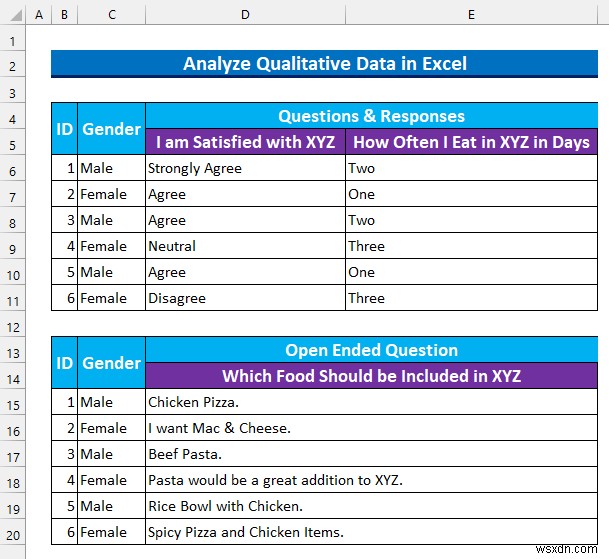
हम अपने दृष्टिकोण प्रदर्शित करने के लिए एक सर्वेक्षण प्रश्नावली से तीन उत्तरों को लेते हैं। यहां, XYZ एक शहर के अंत में एक कैफे है और छात्र कभी-कभी वहां घूमते हैं। तीन प्रश्न इस प्रकार हैं:
- सबसे पहले, एक लिकर्ट स्केल प्रश्न "मैं XYZ से संतुष्ट हूँ"। इस प्रश्न का उत्तर देने के लिए 5 स्तर हैं।
- अगला, एक बहुविकल्पीय प्रश्न "मैं कितने दिन XYZ में खाता हूँ"। प्रतिभागी 3 विकल्पों में से एक चुन सकते हैं।
- अंत में, एक खुला प्रश्न: "XYZ में कौन सा भोजन शामिल किया जाना चाहिए"। यहां किसी भी लंबाई का टेक्स्ट स्वीकार्य था।
आम तौर पर, हमारे डेटासेट में 3 कॉलम हैं: "ID", "Gender", और "Questions & Responses"। इसके अलावा, नीचे दिए गए स्नैपशॉट में, तीन प्रश्न एक कॉम्पैक्ट संरचना में दिखाए गए हैं। हम चर्चा करेंगे कि प्रत्येक प्रकार से जानकारी कैसे प्राप्त करें।
चरण 1: Excel में विश्लेषण के लिए गुणात्मक डेटा को कोड और सॉर्ट करें
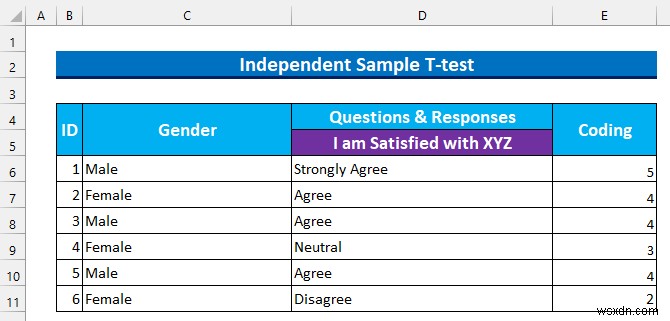
हम कोड का उपयोग करके गुणात्मक डेटा को संख्यात्मक मूल्यों में बदल देंगे। फिर, हम अगले चरण की तैयारी के लिए डेटा को सॉर्ट करेंगे। हमारा लिकर्ट स्केल में 5 स्तर हैं, इसलिए मूल्य इस तरह होंगे:
- Strongly Agree -> 5।
- Agree -> 4।
- Neutral -> 3।
- Disagree -> 2।
- Strongly Disagree -> 1।
- तो, हम इसका उपयोग सेल रेंज E6:E11 में मान इनपुट करने के लिए करते हैं।
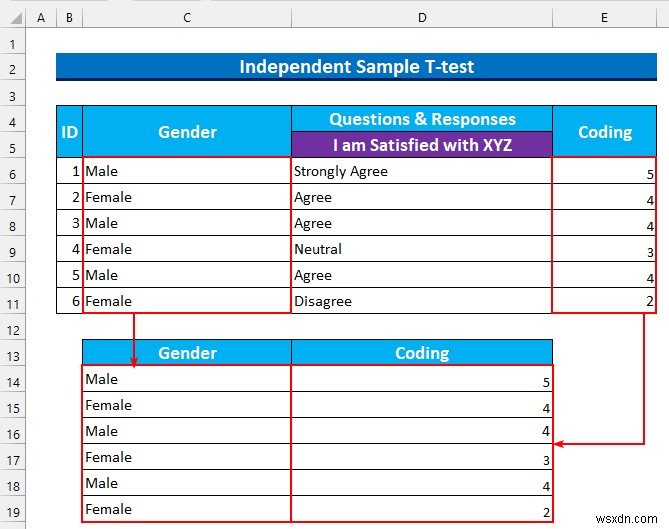
- फिर, हम "Gender" और "Coding" कॉलम को अलग सेल रेंज में अलग करते हैं।
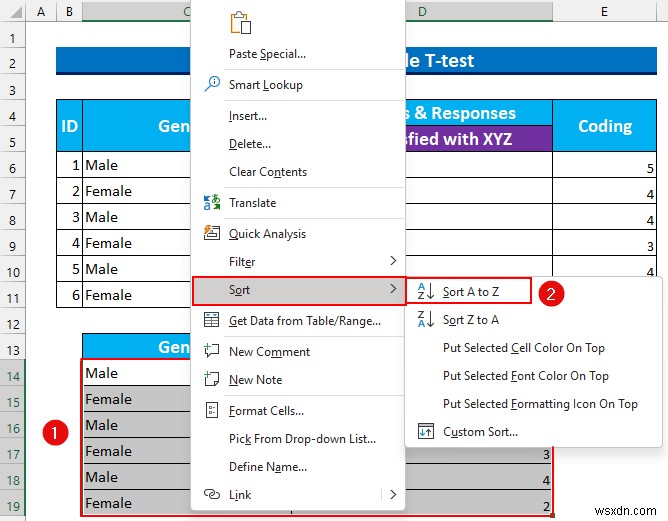
- उसके बाद, सेल रेंज C14:D19 चुनें और Context Menu लाने के लिए राइट-क्लिक करें।
- अगला, Sort >>> से "Sort A to Z" चुनें।
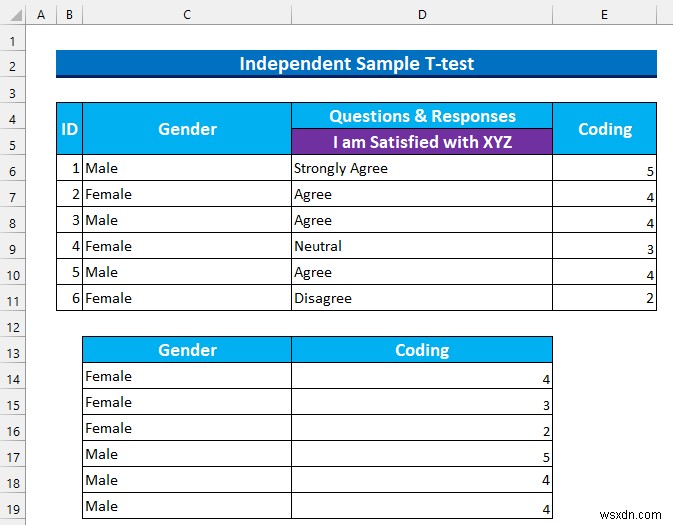
- इसलिए, समान लिंग के लिए हमारे मूल्य एक साथ होंगे।
और पढ़ें: Excel में Analyze Data का उपयोग कैसे करें (5 आसान तरीके)
चरण 2: Analysis ToolPak सक्षम करें
किसी भी सांख्यिकीय परीक्षण करने से पहले हमें Data Analysis सुविधा को Excel में सक्षम करने की आवश्यकता है।
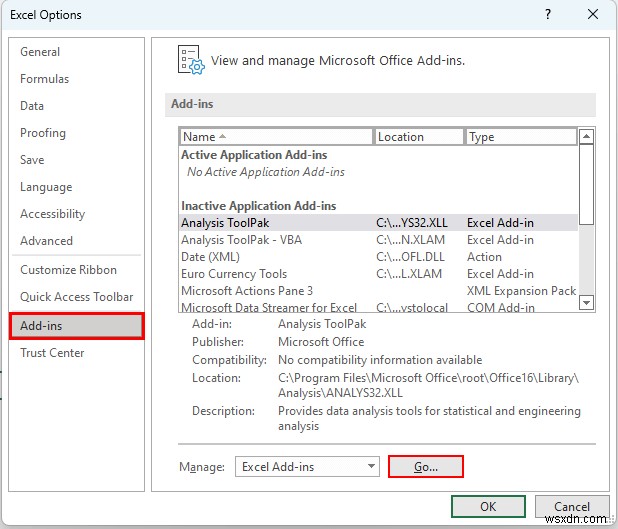
- शुरू करने के लिए, ALT, F, फिर T दबाकर Excel Options विंडो लाएं।
- फिर, Add-ins >>> से "Go…" चुनें।
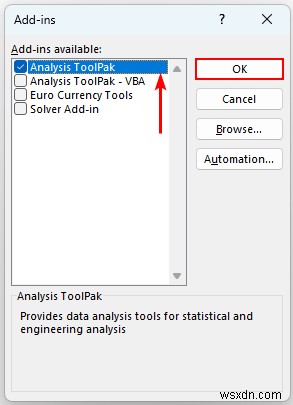
- तो, Add-ins dialog box खुलेगा।
- उसके बाद, "Analysis Toolpak" चुनें और OK दबाएं।
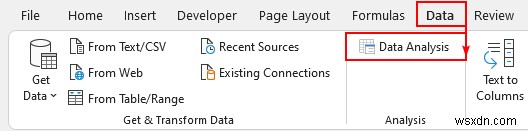
- अंत में, हम Data टैब के अंदर Data Analysis कमांड देखेंगे।
और पढ़ें: [Fixed:] Data Analysis Not Showing in Excel (2 Effective Solutions)
चरण 3: गुणात्मक डेटा के साथ माध्य की तुलना के लिए T-test
हम Two-Sample t-test का उपयोग करेंगे, जिसे Independent Sample t-test के रूप में भी जाना जाता है, गुणात्मक डेटा का विश्लेषण करने के लिए। हमारे दो परिकल्पनाएं या धारणाएं हैं:
नल परिकल्पना H0: "दोनों समूह XYZ से समान रूप से संतुष्ट हैं"।
वैकल्पिक परिकल्पना Ha: "दोनों समूह XYZ से समान रूप से संतुष्ट नहीं हैं"।
यदि हमें हमारा p-value 0.05 से कम मिलता है तो हम नल परिकल्पना को अस्वीकार करने में विफल रहेंगे। अन्यथा, हम नल परिकल्पना को अस्वीकार कर देंगे।
- पिछले चरण में, हमने Analysis Toolpak सक्षम किया। यह Analysis सेक्शन के अंतर्गत दिखाई देगा।
- फिर, "Data Analysis" पर क्लिक करें।
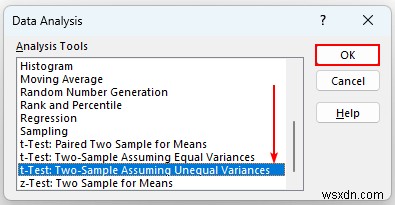
- अगला, "t-test: Two-Sample Assuming Unequal Variances" चुनें और OK दबाएं।
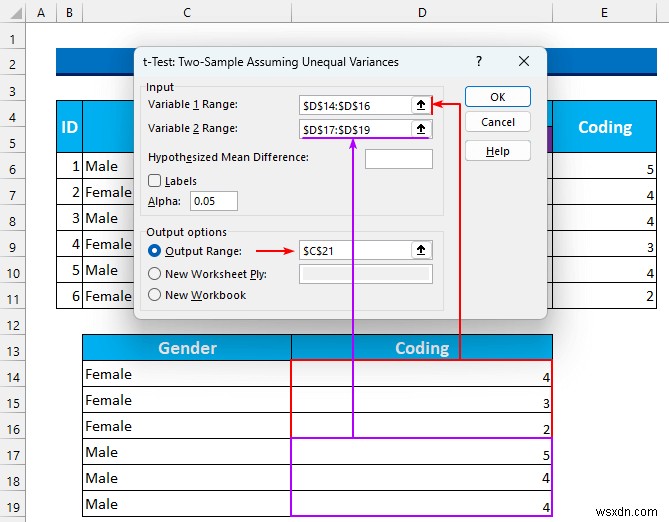
- उसके बाद, एक डायलॉग बॉक्स दिखाई देगा। इन विकल्पों को चुनें:
- Variable 1 Range – D14:D16।
- Variable 2 Range – D17:D19।
- हम इसे स्वैप भी कर सकते हैं, आउटपुट किसी भी तरह समान होगा।
- उसके बाद, "Output Range" चुनें और आउटपुट स्थान के रूप में सेल C21 चुनें।
- फिर, OK दबाएं।
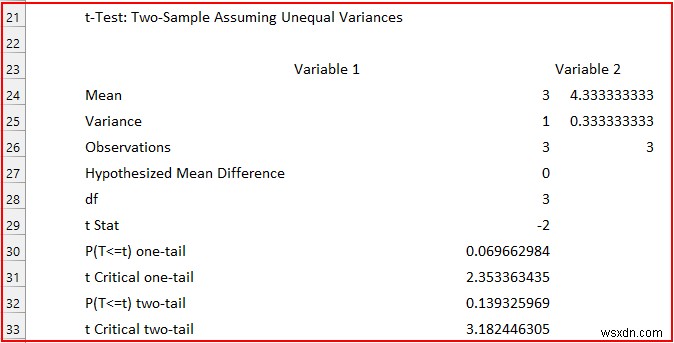
- तो, आउटपुट ऐसा होगा।
- अगला, हम देख सकते हैं कि माध्य 3 और 4.33 है। हम p-value का उपयोग करके जांचेंगे कि क्या यह अंतर महत्वपूर्ण है या नहीं। इसके अलावा, प्रसरण 1 और 0.33 हैं, इसलिए असमान प्रसरण की हमारी धारणा सही थी। यदि यह मान लगभग समान है तो आपको इसे "t-test: Two-Sample Assuming Equal Variances" में बदलना होगा।
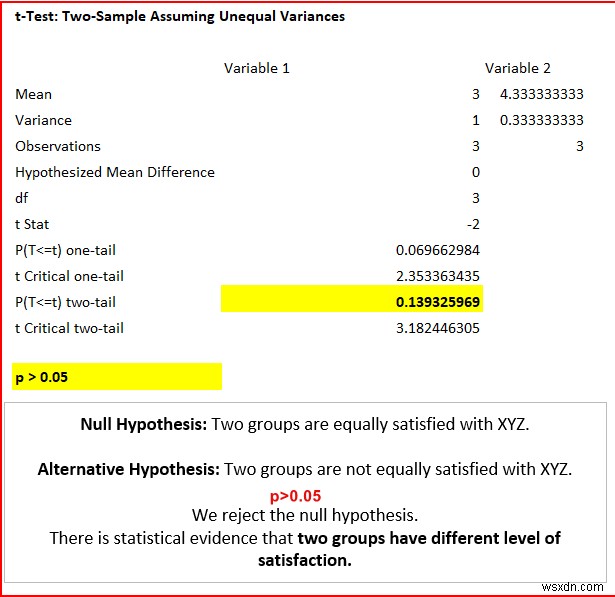
- इसलिए, हमें केवल P(T<=t) two-tail मान पर ध्यान केंद्रित करने की आवश्यकता है। यह महत्वपूर्ण होने के लिए 0.05 से कम होना चाहिए। चूंकि यह (0.14 यदि हम राउंड अप करें) 0.05 से अधिक है, इसलिए, हम नल परिकल्पना को अस्वीकार करते हैं।
- तो, विश्लेषण से, हम कह सकते हैं कि पुरुषों और महिलाओं का कैफे XYZ के साथ संतुष्टि का स्तर अलग है, जो सांख्यिकीय रूप से महत्वपूर्ण है।
चरण 4: ची-स्क्वायर टेस्ट के लिए श्रेणीबद्ध डेटासेट तैयार करें
हम इस चरण में SUM और COUNTIFS फंक्शन का उपयोग करेंगे। अब, हम दूसरे प्रश्न का विश्लेषण करने पर चर्चा करेंगे। हम दो श्रेणीबद्ध डेटा के बीच संबंध का पता लगाने के लिए Chi-Square test का उपयोग करते हैं। इसके अलावा, यह अपेक्षित और देखे गए मूल्यों के बीच अंतर लौटा सकता है। हम यह पता लगाना चाहते हैं कि लिंग और XYZ कैफे में खाने की संख्या के बीच कोई संबंध है या नहीं।
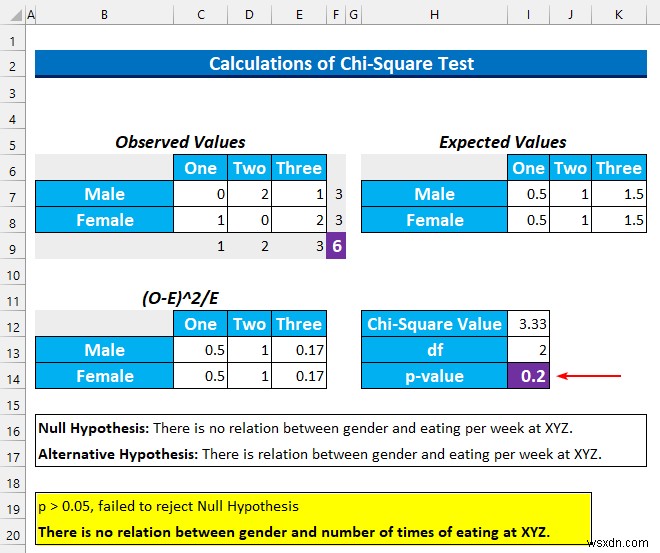
नल परिकल्पना H0: "XYZ पर लिंग और प्रति सप्ताह खाने के बीच कोई संबंध नहीं है"।
वैकल्पिक परिकल्पना Ha: "XYZ पर लिंग और प्रति सप्ताह खाने के बीच संबंध है"।
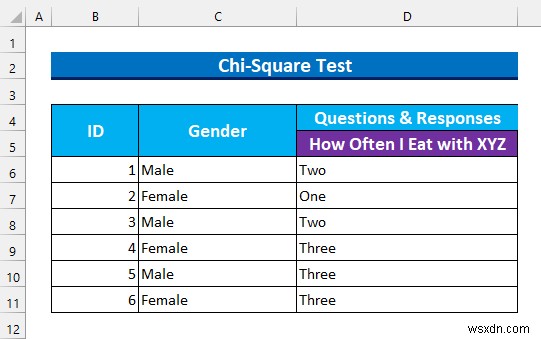
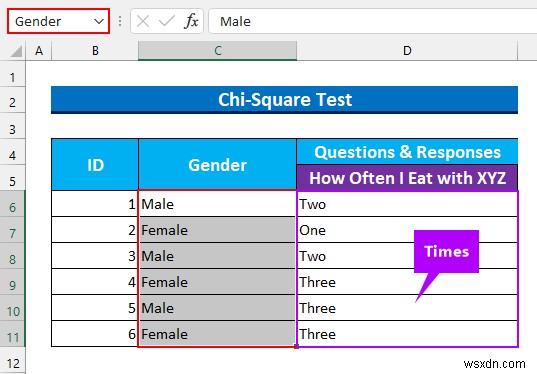
- सबसे पहले, हम रेंज C6:C11 को "Gender" और D6:D11 को "Times" नाम देंगे।
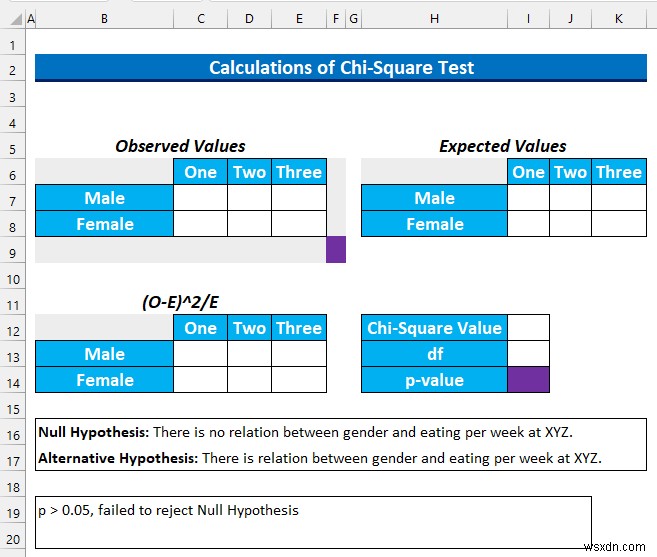
- अगला, हम Chi-Squared मूल्य की गणना के लिए एक टेम्पलेट बनाएंगे।
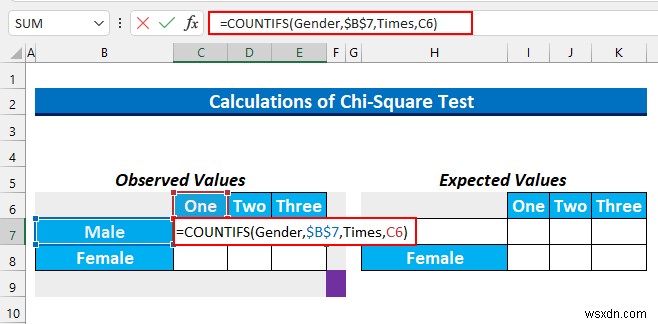
- फिर, हम सेल रेंज C7:E7 चुनेंगे और निम्न सूत्र टाइप करेंगे।
=COUNTIFS(Gender,$B$7,Times,C6)
यह सूत्र कैफे XYZ में पुरुषों और एक बार प्रति सप्ताह खाने वाली सेल की संख्या ढूंढता है।
- अगला, CTRL+ENTER दबाएं। यह सूत्र को ऑटोफिल करेगा।
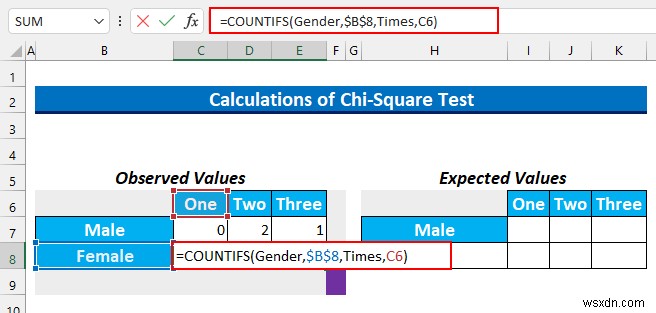
- उसके बाद, हम सेल रेंज C8:E8 चुनेंगे और निम्न सूत्र टाइप करेंगे।
=COUNTIFS(Gender,$B$8,Times,C6)
यह सूत्र कैफे XYZ में महिलाओं और एक बार प्रति सप्ताह खाने वाली सेल की संख्या ढूंढता है।
- फिर, CTRL+ENTER दबाएं।
- उसके बाद, हम पंक्तियों और कॉलम का योग करेंगे।
- सेल रेंज C9:E9 चुनें और यह सूत्र टाइप करें।
=SUM(C7:C8)
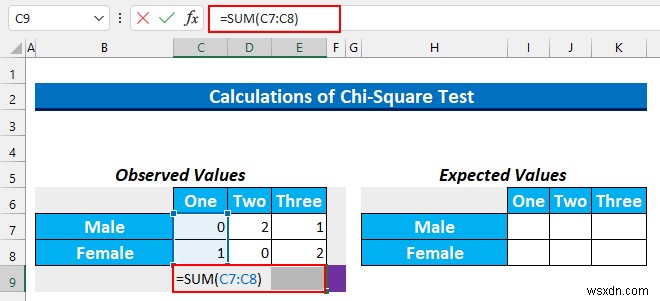
- CTRL+ENTER दबाएं।
- फिर, सेल रेंज F7:F8 चुनें और यह सूत्र टाइप करें।
=SUM(C7:E7)
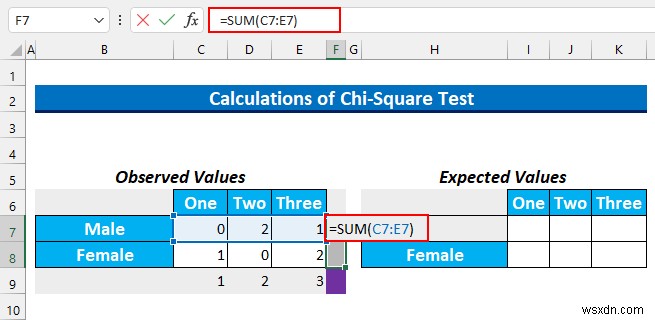
- CTRL+ENTER दबाएं।
- फिर, हम सेल F9 में 6 टाइप करेंगे क्योंकि उत्तरदाताओं की संख्या 6 थी।
- अब, हम अपेक्षित मूल्य ढूंढेंगे। इसे ढूंढने का सूत्र है Row Total * Column Total/Total।
- उसके बाद, सेल रेंज I7:K7 को पहले चुनकर यह सूत्र टाइप करें।
=$F$7*C9/$F$9
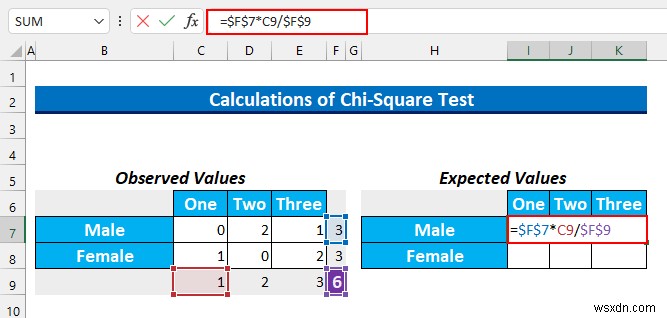
- CTRL+ENTER दबाएं।
- फिर, सेल रेंज I8:K8 चुनें और यह सूत्र टाइप करें।
=$F$8*C9/$F$9
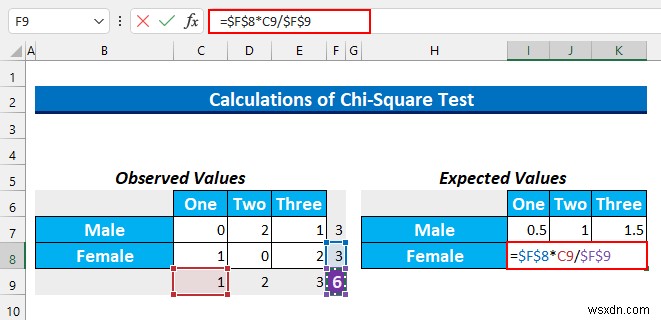
- उसके बाद, CTRL+ENTER दबाएं।
- अब, हम Chi-Squared मूल्य ढूंढेंगे।
- तो, सेल रेंज C13:E14 चुनें और निम्न सूत्र टाइप करें।
=(C7-I7)^2/I7
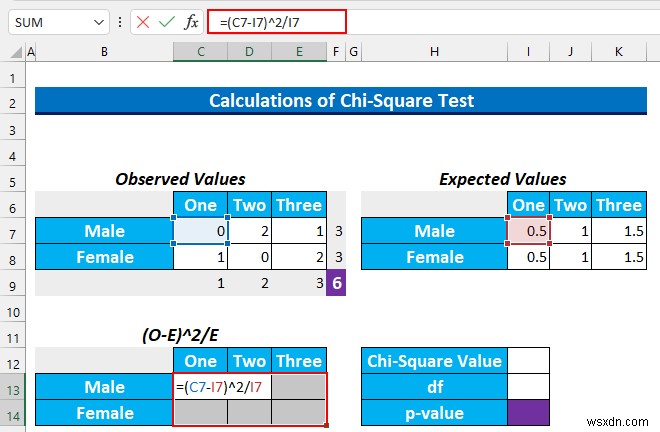
- उसके बाद, CTRL+ENTER दबाएं।
- फिर, हम सेल I12 में ये मान जोड़ेंगे यह सूत्र टाइप करके।
=SUM(C13:E14)
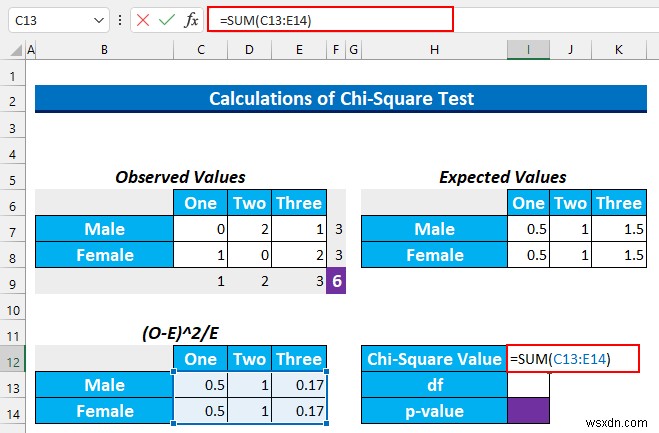
- उसके बाद, ENTER दबाएं।
- अब, df का अर्थ डिग्री ऑफ फ्रीडम है। इसे ढूंढने का सूत्र (कॉलम की संख्या -1) * (पंक्तियों की संख्या -1) का उपयोग करना है। हमारे पास 2 पंक्तियां और 3 कॉलम हैं। इसलिए, हमारा df (3-1)*(2-1) = 2 होगा।
और पढ़ें: Excel में बड़े डेटा सेट का विश्लेषण कैसे करें (6 प्रभावी तरीके)
समान लेख
- Excel में बिक्री डेटा का विश्लेषण कैसे करें (10 आसान तरीके)
- पिवट टेबल का उपयोग करके Excel में डेटा का विश्लेषण करें (9 उपयुक्त उदाहरण)
- Excel में टाइम-स्केल्ड डेटा का विश्लेषण कैसे करें (आसान चरणों के साथ)
चरण 5: ची-स्क्वायर टेस्ट के साथ Excel में श्रेणीबद्ध गुणात्मक डेटा का विश्लेषण करें
हम इस परीक्षण के लिए p-value ढूंढने के लिए CHISQ.DIST.RT का उपयोग करेंगे।
- तो, सेल I14 में यह सूत्र टाइप करें।
=CHISQ.DIST.RT(I12,I13)
यह फंक्शन "काई-स्क्वेयर वितरण की दाईं पूंछ की संभावना" लौटाता है।
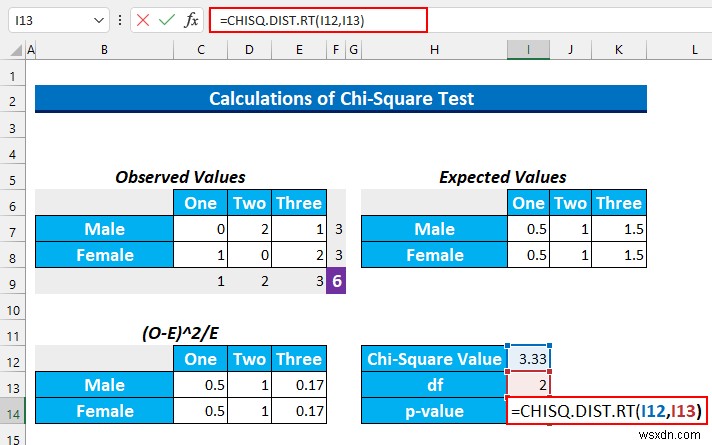
- उसके बाद, ENTER दबाएं। हमें 0.2 का मान मिलेगा जो 0.05 से बड़ा है। तो, हम नल परिकल्पना को अस्वीकार करने में विफल रहेंगे। सरल शब्दों में, हम कह सकते हैं कि दोनों श्रेणियों का कोई संबंध नहीं है।
चरण 6: खुले प्रश्नों वाले गुणात्मक डेटा के लिए भावना विश्लेषण
अब, हम अपने अंतिम प्रश्न और प्रतिक्रियाओं को देखेंगे। हम प्रतिक्रियाओं के विषयों को खोजने की मैन्युअल प्रक्रिया का उपयोग करेंगे। हमने डेटासेट में दो कॉलम जोड़े हैं: "Topic1" और "Topic2"।
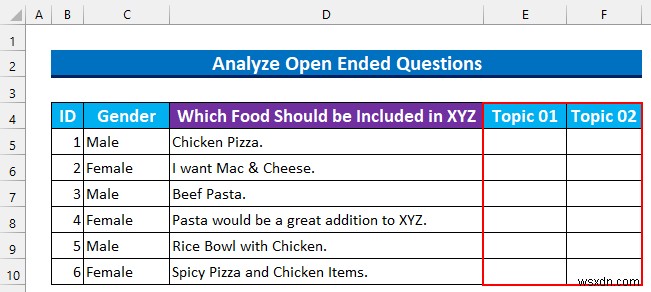
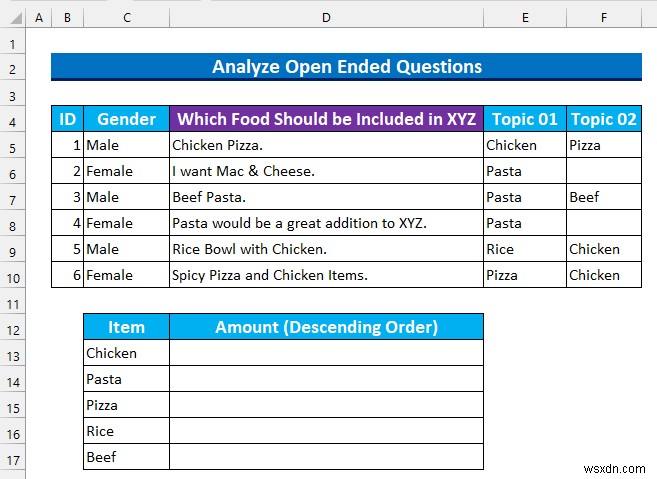
- फिर, हम प्रतिक्रियाओं को पढ़ेंगे और उनसे भोजन विषय जोड़ेंगे। उदाहरण के लिए, "Chicken Pizza" के 2 विषय हैं: "Chicken" और "Pizza" और इसी तरह।
- उसके बाद, हमने केवल अद्वितीय विषयों को एक नई तालिका में जोड़ा।
चरण 7: खुले प्रश्नों वाले गुणात्मक डेटा का विश्लेषण करने के लिए COUNTIF फंक्शन का उपयोग करें
हम आवृत्ति वितरण में अंतर्दृष्टि प्राप्त करने के लिए COUNTIF फंक्शन का उपयोग करेंगे।
- सबसे पहले, सेल रेंज D13:D17 चुनें और निम्न सूत्र टाइप करें।
=COUNTIF($E$5:$F$10,C13)
यह सूत्र रेंज F5:F10 में उन मूल्यों की संख्या गिनता है जिनका मान सेल C13 से मेल खाता है।
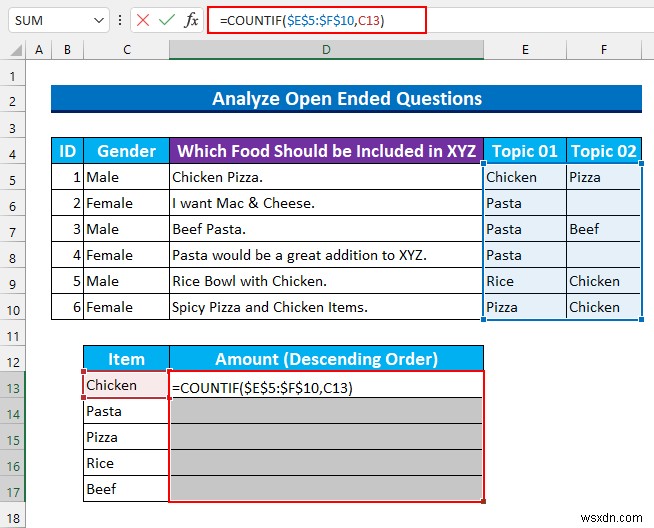
- उसके बाद, सूत्र को ऑटोफिल करने के लिए CTRL+ENTER दबाएं।
- अगला, हम आवृत्ति वितरण को दृश्यमान करने के लिए एक Chart डालेंगे।
चरण 8: खुले प्रश्नों वाले गुणात्मक डेटा को दृश्यमान करने के लिए क्लस्टर्ड कॉलम चार्ट
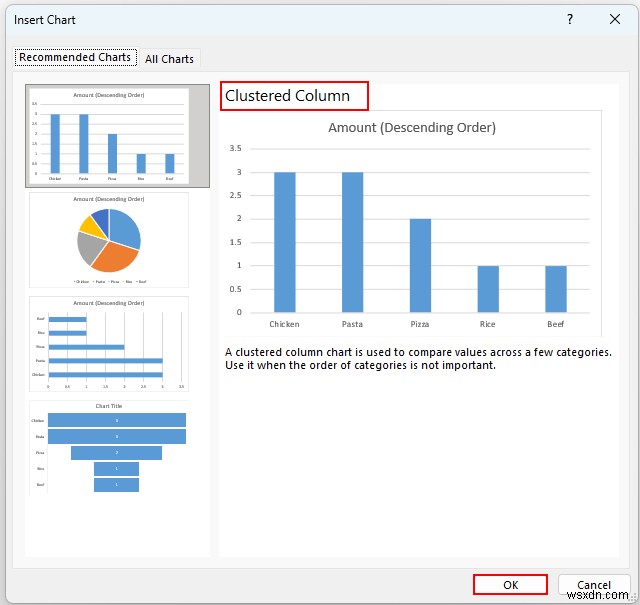
इस चरण में, हम गुणात्मक डेटा को अधिक स्पष्ट रूप से समझने के लिए एक Clustered Column Chart बनाएंगे।
- तो, सेल रेंज C12:D17 चुनें और Insert टैब से, Recommended Charts चुनें।
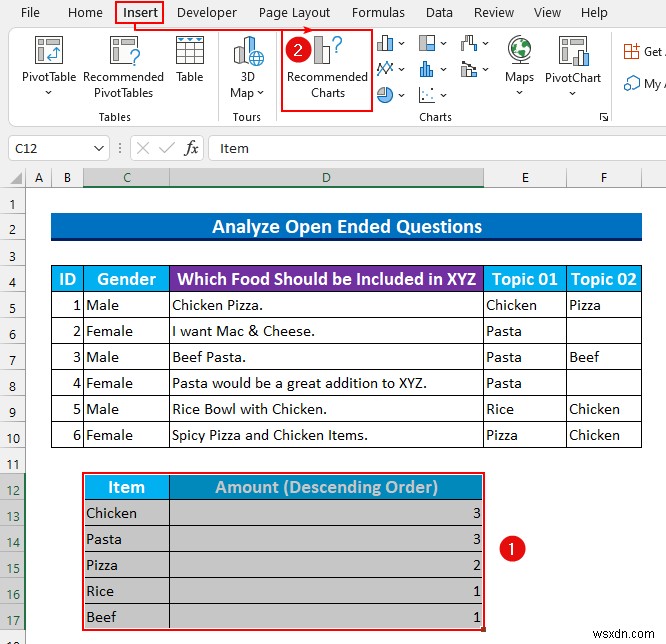
- फिर, Insert Chart dialog box दिखाई देगा और डिफ़ॉल्ट रूप से Clustered Column चुना जाएगा। यदि नहीं तो इसे चुनें।
- उसके बाद, OK दबाएं।
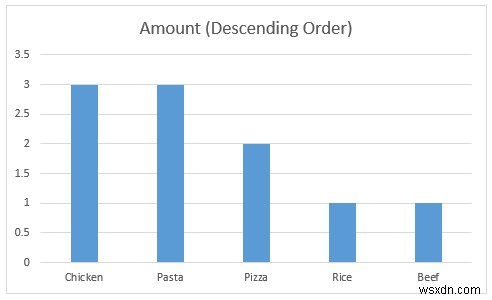
- फिर, हम देख सकते हैं कि ग्राहक XYZ कैफे में शीर्ष 3 खाद्य पदार्थों के रूप में Chicken, Pasta, और Pizza चाहते हैं। XYZ कैफे का प्रबंधन अधिक राजस्व उत्पन्न करने के लिए इन उत्पादों को अधिक पेश करना चुन सकता है।
सारांश
- हम t-test का उपयोग तब करते हैं जब हम दो समूहों के बीच माध्य की तुलना करते हैं और chi-square test का उपयोग तब करते हैं जब हम श्रेणीबद्ध मूल्यों के साथ काम करते हैं।
- हमारे डेटासेट के लिए, हमें सर्वेक्षण प्रश्नावली में तीन प्रश्नों से ये परिणाम मिलते हैं-
- पुरुषों और महिलाओं की कैफे XYZ के साथ संतुष्टि का स्तर अलग है।
- लिंग और कैफे XYZ में खाने की संख्या संबंधित नहीं है।
- छात्र या ग्राहक Cafe XYZ में शामिल करने के लिए शीर्ष तीन आइटम के रूप में Chicken, Pasta, और Pizza चाहते हैं।
अभ्यास अनुभाग
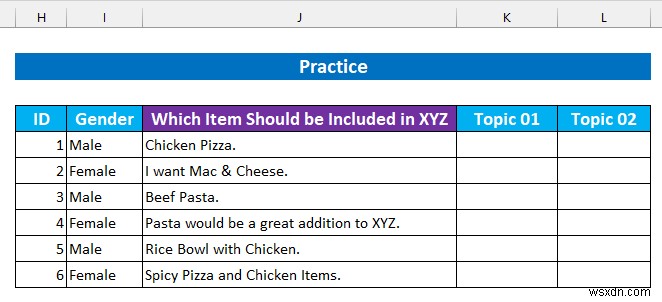
हमने Excel फाइल में प्रत्येक विधि के लिए एक अभ्यास डेटासेट जोड़ा है। इसलिए, आप आसानी से हमारी विधियों का पालन कर सकते हैं।
निष्कर्ष
हमने आपको Excel में गुणात्मक डेटा का विश्लेषण करने के 8 चरण दिखाए हैं। यदि आपको इन विधियों के संबंध में कोई समस्या आती है या मेरे लिए कोई प्रतिक्रिया है, तो नीचे टिप्पणी करने के लिए स्वतंत्र महसूस करें। इसके अलावा, आप अधिक Excel-संबंधी लेखों के लिए हमारी साइट ExcelDemy पर जा सकते हैं। पढ़ने के लिए धन्यवाद, उत्कृष्टता प्राप्त करते रहें!
संबंधित लेख
- Excel में qPCR डेटा का विश्लेषण कैसे करें (2 आसान तरीके)
- Excel डेटा विश्लेषण का उपयोग करके केस स्टडी करें
- Excel में टेक्स्ट डेटा का विश्लेषण कैसे करें (5 उपयुक्त तरीके)