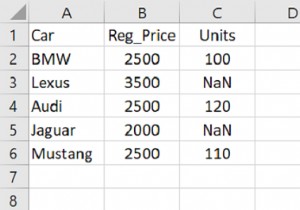
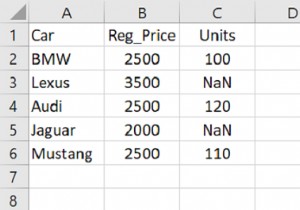
माध्यिका डेटा के उच्च आधे को निचले आधे से अलग करती है। fillna() मेथड का उपयोग करें और माध्यिका सेट करके गायब कॉलम को माध्यिका से भरें। सबसे पहले, अपने संबंधित उपनामों के साथ आवश्यक लाइब्रेरी इम्पोर्ट करें –
import pandas as pd
import numpy as np
2 कॉलम वाला डेटाफ्रेम बनाएं। हमने Numpy np.NaN का उपयोग करके NaN मान सेट किए हैं –
dataFrame = pd.DataFrame(
    {
        "Car": ['Lexus', 'BMW', 'Audi', 'Bentley', 'Mustang', 'Tesla'],
        "Units": [100, 150, np.NaN, 80, np.NaN, np.NaN]
    }
)
NaN वाले कॉलम मानों की माध्यिका खोजें, यानी यहां Units कॉलम के लिए। median() का उपयोग करके NaN को उस कॉलम की माध्यिका से बदलें जहां यह स्थित है –
dataFrame.fillna(dataFrame['Units'].median(), inplace=True)
उदाहरण
निम्न कोड है –
import pandas as pd
import numpy as np
# डेटाफ्रेम बनाएं
dataFrame = pd.DataFrame(
    {
        "Car": ['Lexus', 'BMW', 'Audi', 'Bentley', 'Mustang', 'Tesla'],
        "Units": [100, 150, np.NaN, 80, np.NaN, np.NaN]
    }
)
print "DataFrame ...\n", dataFrame
# NaN वाले कॉलम मानों की माध्यिका खोजें यानी यहां Units कॉलम के लिए
# NaN को उस कॉलम की माध्यिका से बदलें जहां यह स्थित है
dataFrame.fillna(dataFrame['Units'].median(), inplace=True)
print "\nUpdated Dataframe after filling NaN values with median...\n", dataFrame
आउटपुट
यह निम्न आउटपुट उत्पन्न करेगा –
DataFrame ...   Car  Units
0  Lexus   100.0
1   BMW   150.0
2  Audi     NaN
3 Bentley   80.0
4 Mustang    NaN
5  Tesla     NaN
Updated Dataframe after filling NaN values with median...   Car  Units
0  Lexus   100.0
1   BMW   150.0
2  Audi   100.0
3 Bentley   80.0
4 Mustang  100.0
5  Tesla  100.0