पंक्तियों और कॉलम के सबसेट का चयन करने के लिए loc का उपयोग करें। इंडेक्स ऑपरेटर यानी वर्गाकार ब्रैकेट का उपयोग करें और loc में शर्तें सेट करें।
मान लीजिए हमारी CSV फ़ाइल की सामग्री Microsoft Excel में निम्नलिखित है:
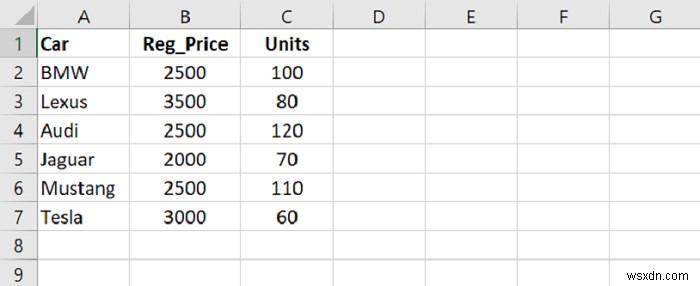
सबसे पहले, CSV फ़ाइल से डेटा पैंडास DataFrame में लोड करें:
dataFrame = pd.read_csv("C:\\Users\\amit_\\Desktop\\SalesData.csv")पंक्तियों और कॉलम के संयुक्त सबसेट का चयन करें। दायां कॉलम वह कॉलम प्रदर्शित करता है जिसे आप प्रदर्शित करना चाहते हैं यानी यहां Cars कॉलम:
dataFrame.loc[dataFrame["Units"] > 100, "Car"]
उदाहरण
कोड निम्नलिखित है:
import pandas as pd
# CSV फ़ाइल से डेटा पैंडास DataFrame में लोड करें:
dataFrame = pd.read_csv("C:\\Users\\amit_\\Desktop\\SalesData.csv")
print("\nReading the CSV file...\n", dataFrame)
# पंक्तियों के सबसेट का चयन करना
print("\nSelect cars with Units more than 100: \n", dataFrame[dataFrame["Units"] > 100])
# केवल दो कॉलम प्रदर्शित करना
res = dataFrame[['Reg_Price', 'Units']]
print("\nDisplaying only two columns : \n", res)
# पंक्तियों और कॉलम के संयुक्त सबसेट का चयन करें
# दायां कॉलम वह कॉलम प्रदर्शित करता है जिसे आप प्रदर्शित करना चाहते हैं यानी Cars कॉलम यहां
res2 = dataFrame.loc[dataFrame["Units"] > 100, "Car"]
# सबसेट प्रदर्शित करें
print("\nSubset...\n", res2)
आउटपुट
यह निम्नलिखित आउटपुट उत्पन्न करेगा:
Reading the CSV file...    Car  Reg_Price  Units
0  BMW  2500  100
1  Lexus  3500  80
2  Audi  2500  120
3  Jaguar  2000  70
4  Mustang  2500  110
Select cars with Units more than 100:    Car  Reg_Price  Units
2  Audi  2500  120
4  Mustang  2500  110
Displaying only two columns :  Reg_Price  Units
0  2500  100
1  3500  80
2  2500  120
3  2000  70
4  2500  110
Subset... 2  Audi
4  Mustang
Name: Car, dtype: object