पायथन डेटा विश्लेषण और विज़ुअलाइज़ेशन के लिए कई लाइब्रेरी प्रदान करता है मुख्य रूप से numpy, pandas, matplotlib, seaborn आदि। इस खंड में, हम डेटा विश्लेषण और विज़ुअलाइज़ेशन के लिए pandas लाइब्रेरी पर चर्चा करने जा रहे हैं जो numpy के ऊपर बनी एक ओपन सोर्स लाइब्रेरी है।
यह हमें तेजी से विश्लेषण और डेटा सफाई और तैयारी करने की अनुमति देता है। Pandas कई अंतर्निहित विज़ुअलाइज़ेशन सुविधाएँ भी प्रदान करता है जिन्हें हम नीचे देखने जा रहे हैं।
इंस्टॉलेशन
pandas इंस्टॉल करने के लिए, अपने टर्मिनल में नीचे कमांड चलाएं -
pip install pandas
या यदि हमारे पास anaconda है, तो आप उपयोग कर सकते हैं
conda install pandas
Pandas - DataFrames
DataFrames मुख्य टूल हैं जब हम pandas के साथ काम कर रहे होते हैं।
कोड -
import numpy as np
import pandas as pd
from numpy.random import randn
np.random.seed(50)
df = pd.DataFrame(randn(6,4), ['a','b','c','d','e','f'],['w','x','y','z'])
df
आउटपुट
| w | x | y | z | |
|---|---|---|---|---|
| a | -1.560352 | -0.030978 | -0.620928 | -1.464580 |
| b | 1.411946 | -0.476732 | -0.780469 | 1.070268 |
| c | -1.282293 | -1.327479 | 0.126338 | 0.862194 |
| d | 0.696737 | -0.334565 | -0.997526 | 1.598908 |
| e | 3.314075 | 0.987770 | 0.123866 | 0.742785 |
| f | -0.393956 | 0.148116 | -0.412234 | -0.160715 |
Pandas - मिसिंग डेटा
हम पायथन में मिसिंग डेटा से निपटने के कुछ सुविधाजनक तरीके देखने जा रहे हैं, जो स्वचालित रूप से शून्य या NaN से भर जाते हैं।
import numpy as np
import pandas as pd
from numpy.random import randn
d = {'A': [1,2,np.nan], 'B': [9, np.nan, np.nan], 'C': [1,4,9]}
df = pd.DataFrame(d)
df
आउटपुट
| A | B | C | |
|---|---|---|---|
| 0 | 1.0 | 9.0 | 1 |
| 1 | 2.0 | NaN | 4 |
| 2 | NaN | NaN | 9 |
तो, उपरोक्त में हमारे पास 3 मिसिंग मान हैं।
df.dropna()
| A | B | C | |
|---|---|---|---|
| 0 | 1.0 | 9.0 | 1 |
df.dropna(axis=1)
| C | |
|---|---|
| 0 | 1 |
| 1 | 4 |
| 2 | 9 |
df.dropna(thresh=2)
| A | B | C | |
|---|---|---|---|
| 0 | 1.0 | 9.0 | 1 |
| 1 | 2.0 | NaN | 4 |
df.fillna(value=df.mean())
| A | B | C | |
|---|---|---|---|
| 0 | 1.0 | 9.0 | 1 |
| 1 | 2.0 | 9.0 | 4 |
| 2 | 1.5 | 9.0 | 9 |
Pandas - डेटा आयात करें
हम CSV फ़ाइल पढ़ने जा रहे हैं जो या तो हमारे लोकल मशीन में संग्रहीत है (मेरे मामले में) या हम सीधे वेब से प्राप्त कर सकते हैं।
# pandas लाइब्रेरी आयात करें
import pandas as pd

# CSV फ़ाइल पढ़ें और इसे डेटाफ्रेम वेरिएबल को असाइन करें
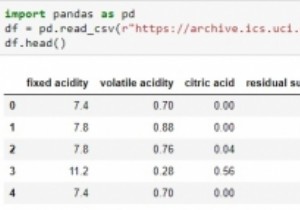
df = pd.read_csv("SYB61_T03_Population Growth Rates in Urban areas and Capital cities.csv", encoding="ISO-8859-1")

# डेटाफ्रेम से पहले पांच तत्व पढ़ें
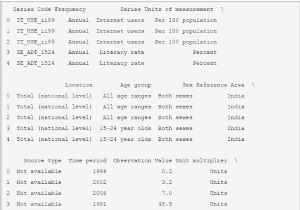
df.head()
आउटपुट
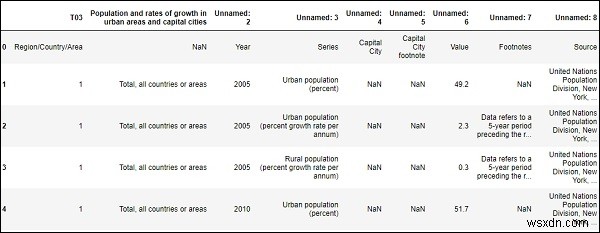
हमारे डेटाफ्रेम या CSV फ़ाइल में पंक्तियों और कॉलम की संख्या पढ़ने के लिए।
# हमारे डेटाफ्रेम में पंक्तियों और कॉलम की संख्या गिनें
df.shape
आउटपुट
(4166,9)
Pandas - Dataframe गणित
पांडा के विभिन्न टूल्स का उपयोग करके डेटाफ्रेम पर ऑपरेशन किए जा सकते हैं सांख्यिकी के लिए
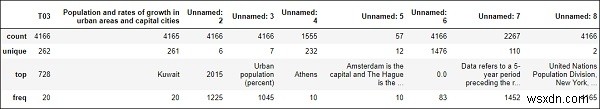
# NaN मानों को छोड़कर विभिन्न सारांश आंकड़ों की गणना करें
df.describe()
आउटपुट
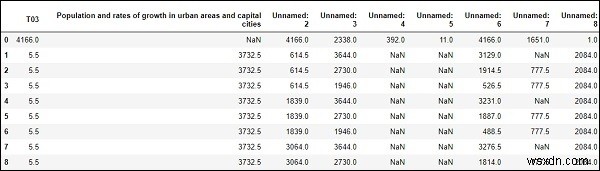
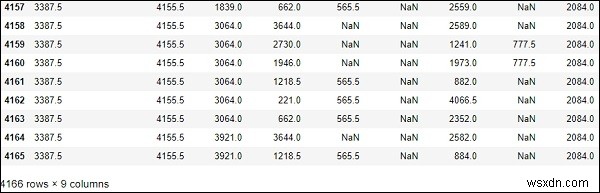
# संख्यात्मक डेटा रैंक की गणना करें
df.rank()
आउटपुट
.....
.....
Pandas - ग्राफ प्लॉट करें
import matplotlib.pyplot as plt
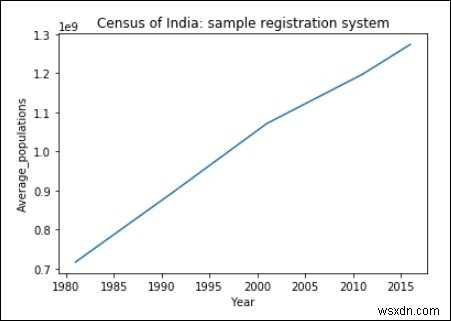
years = [1981, 1991, 2001, 2011, 2016]
Average_populations = [716493000, 891910000, 1071374000, 1197658000, 1273986000]
plt.plot(years, Average_populations)
plt.title("Census of India: sample registration system")
plt.xlabel("Year")
plt.ylabel("Average_populations")
plt.show()
आउटपुट
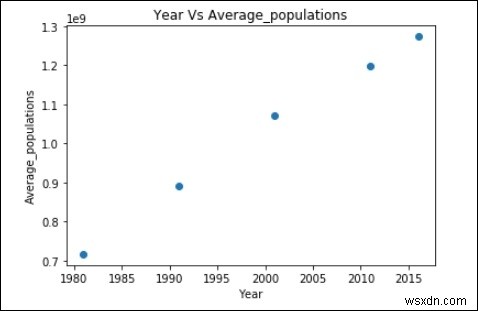
उपरोक्त डेटा का स्कैटर प्लॉट:
plt.scatter(years,Average_populations)
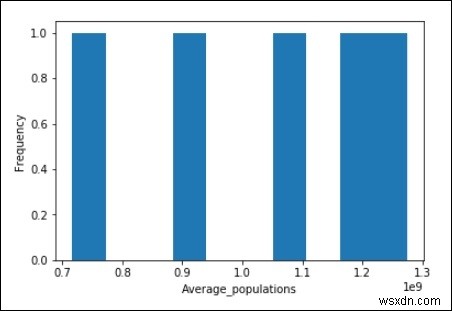
हिस्टोग्राम:
import matplotlib.pyplot as plt
Average_populations = [716493000, 891910000, 1071374000, 1197658000, 1273986000]
plt.hist(Average_populations, bins=10)
plt.xlabel("Average_populations")
plt.ylabel("Frequency")
plt.show()
आउटपुट