डेटा विश्लेषण के लिए, एक्सप्लोरेटरी डेटा विश्लेषण (EDA) आपका पहला कदम होना चाहिए। एक्सप्लोरेटरी डेटा विश्लेषण हमें मदद करता है -
डेटा सेट में अंतर्दृष्टि देना।
अंतर्निहित संरचना को समझना।
महत्वपूर्ण पैरामीटर्स और उनके बीच के संबंधों को निकालना।
अंतर्निहित मान्यताओं का परीक्षण करना।
नमूना डेटा सेट का उपयोग करके EDA को समझना
Python का उपयोग करके EDA को समझने के लिए, हम नमूना डेटा को किसी भी वेबसाइट से सीधे या अपने स्थानीय डिस्क से ले सकते हैं। मैं UCI मशीन लर्निंग रिपॉजिटरी से नमूना डेटा ले रहा हूं जो रेड वाइन क्वालिटी डेटा सेट का एक सार्वजनिक रूप से उपलब्ध संस्करण है और EDA का उपयोग करके डेटा सेट में बहुत अंतर्दृष्टि प्राप्त करने का प्रयास कर रहा हूं।
import pandas as pd
df = pd.read_csv("https://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv")
df.head()
उपरोक्त स्क्रिप्ट को जुपिटर नोटबुक में चलाने पर, नीचे जैसा आउटपुट मिलेगा -
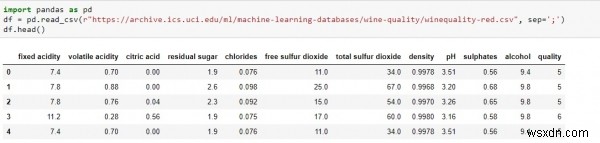
शुरू करने के लिए,
सबसे पहले, आवश्यक लाइब्रेरी आयात करें, इस मामले में pandas।
pandas लाइब्रेरी के read_csv() फ़ंक्शन का उपयोग करके CSV फ़ाइल पढ़ें और दिए गए डेटा सेट में प्रत्येक डेटा डिलीमीटर ";" से अलग किया गया है।
pandas लाइब्रेरी द्वारा प्रदान किए गए ".head" फ़ंक्शन की मदद से डेटा सेट से पहले पांच अवलोकन लौटाएं। हम इसी तरह ".tail()" फ़ंक्शन का उपयोग करके अंतिम पांच अवलोकन प्राप्त कर सकते हैं।
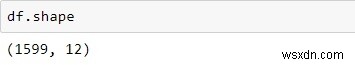
हम ".shape" का उपयोग करके डेटा सेट से कुल पंक्तियों और कॉलम की संख्या प्राप्त कर सकते हैं जैसे नीचे -
df.shape
यह पता लगाने के लिए कि इसमें कौन से कॉलम हैं, किस प्रकार के और क्या उनमें कोई मान है या नहीं, info() फ़ंक्शन की मदद से।
df.info()
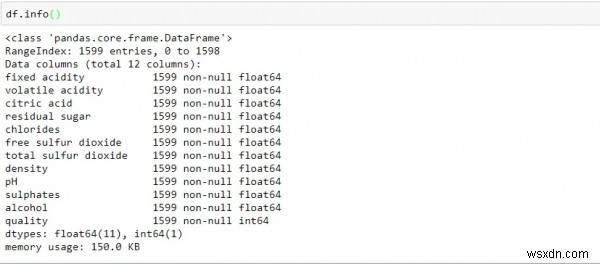
उपरोक्त डेटा को देखकर, हम निष्कर्ष निकाल सकते हैं -
डेटा में केवल फ्लोट और पूर्णांक मान हैं।
सभी कॉलम वेरिएबल नॉन-नल हैं (कोई खाली या गुम मान नहीं)।
Pandas द्वारा प्रदान किया गया एक और उपयोगी फ़ंक्शन describe() है जो डेटा की गिनती, माध्य, मानक विचलन, न्यूनतम और अधिकतम मान और मात्राएं प्रदान करता है।
df.describe()
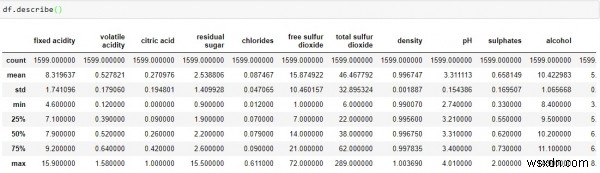
उपरोक्त डेटा से, हम निष्कर्ष निकाल सकते हैं कि प्रत्येक कॉलम का माध्य मान इंडेक्स कॉलम में माध्यिका मान (50%) से कम है।
"अवशिष्ट चीनी", "मुक्त सल्फर डाइऑक्साइड" और "कुल सल्फर डाइऑक्साइड" प्रीडिक्टर्स के 75% और अधिकतम मानों में भारी अंतर है।
उपरोक्त दो अवलोकन, हमारे डेटा सेट में चरम मूल्यों - विचलन का संकेत देते हैं।
निर्भर वेरिएबल से हमें कुछ प्रमुख अंतर्दृष्टि मिल सकती हैं -
df.quality.unique()
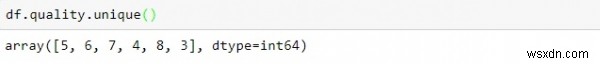
"quality" स्कोर स्केल में, 1 नीचे आता है यानी खराब और 10 ऊपर आता है यानी सर्वश्रेष्ठ।
उपरोक्त से हम निष्कर्ष निकाल सकते हैं, कोई भी अवलोकन 1 (खराब), 2 और 9, 10 (सर्वश्रेष्ठ) स्कोर नहीं करता है। सभी स्कोर 3 से 8 के बीच हैं।
df.quality.value_counts()
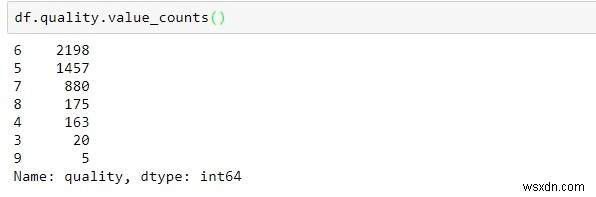
उपरोक्त प्रसंस्कृत डेटा प्रत्येक गुणवत्ता स्कोर के लिए वोट काउंट की जानकारी देता है अवरोही क्रम में।
अधिकांश गुणवत्ता 5-7 की सीमा में हैं।
3 और 6 श्रेणियों में सबसे कम अवलोकन देखे गए हैं।
डेटा विज़ुअलाइज़ेशन
गुम मानों की जांच करने के लिए -
हम seaborn लाइब्रेरी की मदद से अपने व्हाइट-व्हिस्की CSV डेटा सेट में गुम मानों की जांच कर सकते हैं। इसे पूरा करने का कोड नीचे है -
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
df = pd.read_csv("https://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-white.csv", sep=";")
sns.heatmap(df.isnull(), cbar=False, yticklabels=False, cmap='viridis')
आउटपुट
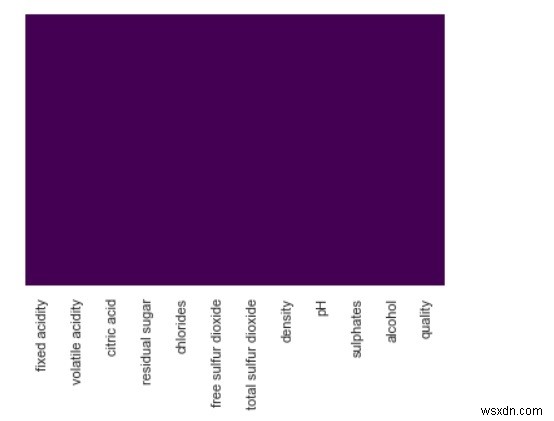
उपरोक्त से हम देख सकते हैं कि डेटासेट में कोई गुम मान नहीं है। यदि कोई होता, तो हमने बैंगनी पृष्ठभूमि पर अलग रंग की छाया द्वारा दर्शाए गए आंकड़े को देखा होता।
अलग डेटासेट के साथ जहां गुम मान हैं, आप अंतर देखेंगे।
सहसंबंध जांचने के लिए
डेटासेट के विभिन्न मूल्यों के बीच सहसंबंध जांचने के लिए, हमारे मौजूदा डेटासेट में नीचे कोड डालें -
plt.figure(figsize=(8,4))
sns.heatmap(df.corr(), cmap='Greens', annot=False)
आउटपुट
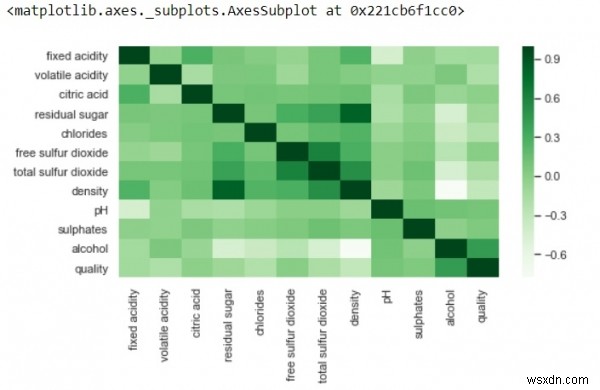
उपरोक्त, सकारात्मक सहसंबंध गहरे रंगों द्वारा दर्शाया गया है और नकारात्मक सहसंबंध हल्के रंगों द्वारा।
annot=True का मान बदलें, और आउटपुट आपको ग्रिड-सेल में उन मूल्यों को दिखाएगा जिनके द्वारा सुविधाएँ एक दूसरे से संबंधित हैं।
हम annot=True के साथ एक और सहसंबंध मैट्रिक्स उत्पन्न कर सकते हैं। अपने मौजूदा कोड में नीचे दी गई कोड लाइनों को जोड़कर अपना कोड संशोधित करें -
k = 12
cols = df.corr().nlargest(k, 'quality')['quality'].index
cm = df[cols].corr()
plt.figure(figsize=(8,6))
sns.heatmap(cm, annot=True, cmap='viridis')
आउटपुट
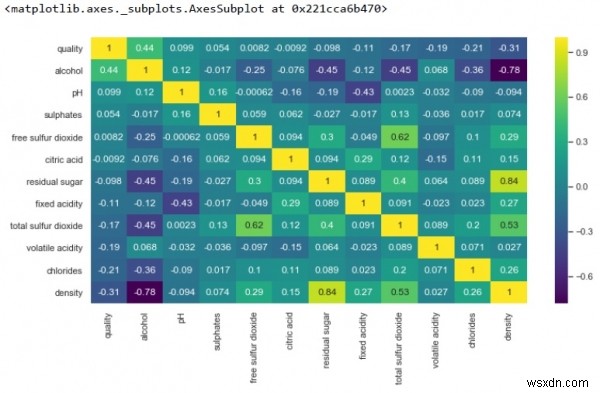
उपरोक्त से हम देख सकते हैं, अवशिष्ट चीनी के साथ घनत्व का मजबूत सकारात्मक सहसंबंध है। हालांकि, घनत्व और अल्कोहल का मजबूत नकारात्मक सहसंबंध।
साथ ही, मुक्त सल्फर डाइऑक्साइड और गुणवत्ता के बीच कोई सहसंबंध नहीं है।