पायथन डेटा विज़ुअलाइज़ेशन के लिए विभिन्न उपयोग में आसान लाइब्रेरी प्रदान करता है। अच्छी बात यह है कि ये लाइब्रेरी छोटे या बड़े डेटासेट के साथ काम करती हैं।
डेटा विज़ुअलाइज़ेशन के लिए सबसे अधिक उपयोग की जाने वाली पायथन लाइब्रेरी में से कुछ हैं -
Matplotlib
Pandas
Plotly
Seaborn
नीचे हम एक निश्चित डेटा के लिए विभिन्न प्रकार के विज़ुअलाइज़ेशन चार्ट प्लॉट करने जा रहे हैं ताकि उस डेटा का बेहतर विश्लेषण किया जा सके।
हम नीचे दिए गए डेटा सेट का विश्लेषण करने जा रहे हैं जिसे विभिन्न चार्ट के माध्यम से विज़ुअलाइज़ किया जाएगा -
| देश या क्षेत्र | वर्ष | वेरिएंट | मान |
|---|---|---|---|
| भारत | 2019 | मध्यम | 1368737.513 |
| भारत | 2019 | उच्च | 1378419.072 |
| भारत | 2019 | कम | 1359043.965 |
| भारत | 2019 | निरंतर प्रजनन क्षमता | 1373707.838 |
| भारत | 2019 | तत्काल प्रतिस्थापन | 1366687.871 |
| भारत | 2019 | शून्य प्रवासन | 1370868.782 |
| भारत | 2019 | निरंतर मृत्यु दर | 1366282.778 |
| भारत | 2019 | कोई परिवर्तन नहीं | 1371221.64 |
| भारत | 2019 | गति | 1367400.614 |
बेसिक प्लॉट
आइए कुछ बेसिक प्लॉट बनाएं: लाइन प्लॉट, स्कैटर प्लॉट और हिस्टोग्राम
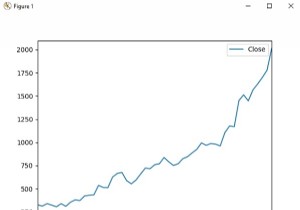
लाइन प्लॉट
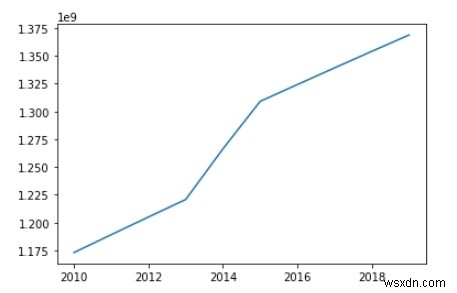
लाइन ग्राफ वे प्लॉट हैं जहां एक रेखा खींची जाती है ताकि x और y मानों के एक विशेष सेट के बीच संबंध को इंगित किया जा सके।
import matplotlib.pyplot as plt
Year = [2010, 2011, 2012, 2013, 2014, 2015, 2016, 2017, 2018, 2019]
India_Population = [1173108018,1189172906,1205073612,1220800359,1266344631,1309053980,1324171354,1339180127,1354051854,1368737513]
plt.plot(Year, India_Population)
plt.show()
आउटपुट
स्कैटर प्लॉट
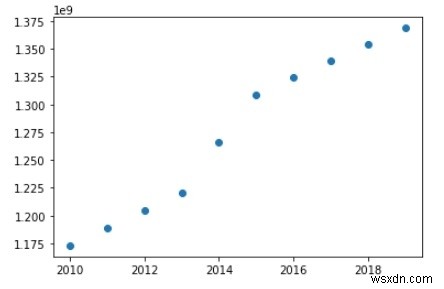
वैकल्पिक रूप से, आप डेटा पॉइंट्स के रूप में 2 स्थितियों के साथ मात्रा प्लॉट करना चाह सकते हैं।
लाइन ग्राफ के लिए समान डेटा पर विचार करें, स्कैटर प्लॉट बनाने के लिए हमें उपरोक्त कोड में केवल एक लाइन संशोधित करने की आवश्यकता है -
plt.plot(Year, India_Population,'o')
आउटपुट
हिस्टोग्राम
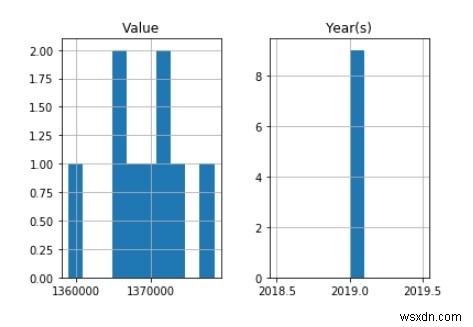
हिस्टोग्राम विज्ञान अनुप्रयोगों में बहुत बार उपयोग किए जाते हैं और यह बहुत संभावना है कि आपको किसी बिंदु पर उन्हें प्लॉट करने की आवश्यकता होगी। वे वितरण प्लॉट करने के लिए बहुत उपयोगी हैं।
import pandas as pd
import matplotlib.pyplot as plt
data = [
    ['India', 2019, 'Medium', 1368737.513],
    ['India', 2019, 'High', 1378419.072],
    ['India', 2019, 'Low', 1359043.965],
    ['India', 2019, 'Constant fertility', 1373707.838],
    ['India', 2019,'Instant replacement', 1366687.871],
    ['India', 2019, 'Zero migration', 1370868.782],
    ['India', 2019,'Constant mortality', 1366282.778],
    ['India', 2019, 'No change', 1371221.64],
    ['India', 2019, 'Momentum', 1367400.614],
]
df = pd.DataFrame(data, columns = ([ 'Country or Area', 'Year(s)', 'Variant', 'Value']))
df.hist()
plt.show()
आउटपुट
पाई चार्ट
import numpy as np
import matplotlib.pyplot as plt
n = 25
Z = np.ones(n)
Z[-1] *= 2.5
plt.axes([0.05, 0.05, 0.95, 0.95])
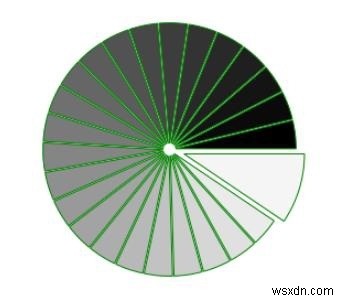
plt.pie(Z, explode=Z*.05, colors=['%f' % (i/float(n)) for i in range(n)], wedgeprops={"linewidth": 1, "edgecolor": "green"})
plt.gca().set_aspect('equal')
plt.xticks([]), plt.yticks([])
plt.show()
आउटपुट
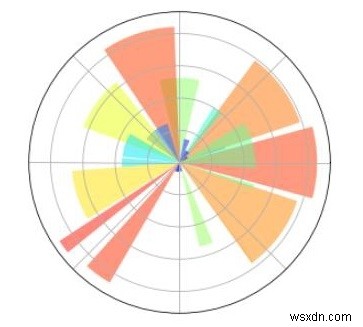
पोलर प्लॉट
कोड:
import numpy as np
import matplotlib.pyplot as plt
ax = plt.axes([0.5,0.05,0.95,0.95], polar=True)
N = 25
theta = np.arange(0.0, 2.5*np.pi, 2.5*np.pi/N)
radii = 10*np.random.rand(N)
width = np.pi/4*np.random.rand(N)
bars = plt.bar(theta, radii, width=width, bottom=0.0)
for r,bar in zip(radii, bars):
    bar.set_facecolor(plt.cm.jet(r/10.))
    bar.set_alpha(0.5)
ax.set_xticklabels([])
ax.set_yticklabels([])
plt.show()
आउटपुट