क्रॉलर विकसित करने के लिए सबसे अच्छे फ्रेमवर्क में से एक scrapy है। Scrapy एक लोकप्रिय वेब स्क्रैपिंग और क्रॉलिंग फ्रेमवर्क है जो वेबसाइटों को स्क्रैप करना आसान बनाने के लिए हाई-लेवल फंक्शनलिटी का उपयोग करता है।
इंस्टॉलेशन
विंडोज में scrapy इंस्टॉल करना आसान है: हम या तो pip या conda (यदि आपके पास anaconda है) का उपयोग कर सकते हैं। Scrapy पायथन 2 और 3 दोनों संस्करणों पर चलता है।
pip install Scrapy
या
conda install -c conda-forge scrapy
यदि Scrapy सही ढंग से इंस्टॉल हो गया है, तो एक scrapy कमांड अब टर्मिनल में उपलब्ध होगी -
C:\Users\rajesh>scrapy Scrapy 1.6.0 - no active project Usage: scrapy[options] [args] Available commands: bench Run quick benchmark test fetch Fetch a URL using the Scrapy downloader genspider Generate new spider using pre-defined templates runspider Run a self-contained spider (without creating a project) settings Get settings values shell Interactive scraping console startproject Create new project version Print Scrapy version view Open URL in browser, as seen by Scrapy [ more ] More commands available when run from project directory Use "scrapy -h" to see more info about a command.
प्रोजेक्ट शुरू करना
अब जब Scrapy इंस्टॉल हो गया है, तो हम अपने पहले Scrapy प्रोजेक्ट के लिए डिफ़ॉल्ट संरचना उत्पन्न करने के लिए startproject कमांड चला सकते हैं।
इसे करने के लिए, टर्मिनल खोलें और उस डायरेक्टरी में नेविगेट करें जहां आप अपना Scrapy प्रोजेक्ट स्टोर करना चाहते हैं, और फिर scrapy startproject
C:\Users\rajesh>scrapy startproject scrapy_example
New Scrapy project 'scrapy_example', using template directory 'c:\python\python361\lib\site-packages\scrapy\templates\project', created in: C:\Users\rajesh\scrapy_example
You can start your first spider with:
cd scrapy_example
scrapy genspider example example.com
C:\Users\rajesh>cd scrapy_example
C:\Users\rajesh\scrapy_example>tree /F
Folder PATH listing
Volume serial number is 8CD6-8D39
C:.
| scrapy.cfg
| └───scrapy_example
    | items.py
    | middlewares.py
    | pipelines.py
    | settings.py
    | __init__.py
    | ├───spiders
    | | __init__.py
    | |
    | └───__pycache__
    └───__pycache__
दूसरा तरीका है हम scrapy shell चलाएं और वेब स्क्रैपिंग करें, जैसे नीचे -
In [18]: fetch ("https://www.wsj.com/india")
2019-02-04 22:38:53 [scrapy.core.engine] DEBUG: Crawled (200)  (referer: None)
Scrapy क्रॉलर एक "response" ऑब्जेक्ट लौटाएगा जिसमें डाउनलोड की गई जानकारी होती है। आइए चेक करें कि हमारा उपरोक्त क्रॉलर क्या समाहित करता है -
In [19]: view(response)
Out[19]: True
और आपके डिफ़ॉल्ट ब्राउज़र में, वेब लिंक खुल जाएगा और आप कुछ ऐसा देखेंगे -
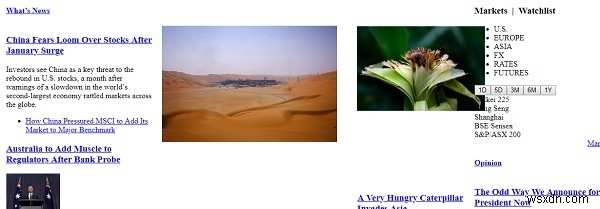
बहुत बढ़िया, यह हमारे वेब पेज से कुछ हद तक समान दिखता है, इसलिए क्रॉलर ने पूरे वेब पेज को सफलतापूर्वक डाउनलोड कर लिया है।
अब देखते हैं कि हमारा क्रॉलर क्या समाहित करता है -
In [22]: print(response.text)


    The Wall Street Journal & Breaking News, Business, Financial and Economic News, World News and Video


    …& so much more:
आइए इस वेबपेज से कुछ महत्वपूर्ण जानकारी निकालने की कोशिश करते हैं -
वेबपेज का शीर्षक निकालना -
Scrapy HTML से CSS सेलेक्टर्स जैसे क्लास, आईडी आदि के आधार पर जानकारी निकालने के तरीके प्रदान करता है। किसी भी वेबपेज शीर्षक के लिए CSS सेलेक्टर ढूंढने के लिए, बस राइट क्लिक करें और इंस्पेक्ट पर क्लिक करें, जैसे नीचे:
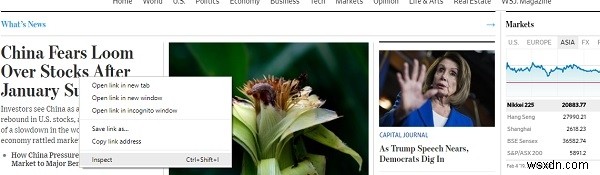
यह आपके ब्राउज़र विंडो में डेवलपर टूल्स खोलेगा -
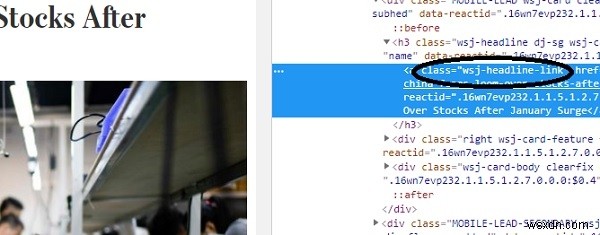
जैसा कि देखा जा सकता है, CSS क्लास "wsj-headline-link" उन सभी एंकर () टैग पर लागू होती है जिनमें शीर्षक होते हैं। इस जानकारी के साथ, हम response ऑब्जेक्ट में बाकी कंटेंट से सभी शीर्षक खोजने की कोशिश करेंगे -
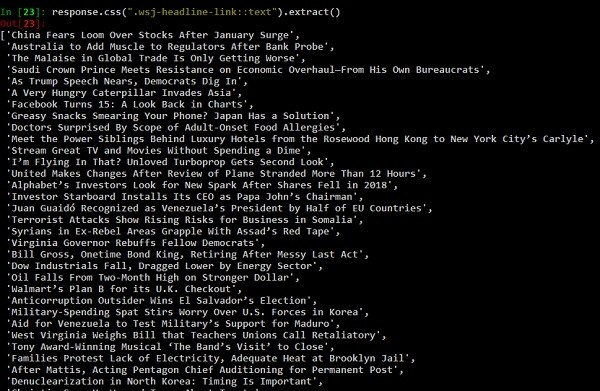
response.css() वह फंक्शन है जो CSS सेलेक्टर के आधार पर कंटेंट निकालेगा (जैसे ऊपर एंकर टैग)। आइए हमारे response.css फंक्शन के कुछ और उदाहरण देखें।
In [24]: response.css(".wsj-headline-link::text").extract_first()
Out[24]: 'China Fears Loom Over Stocks After January Surge'
और
In [25]: response.css(".wsj-headline-link").extract_first()
Out[25]: 'China Fears Loom Over Stocks After January Surge'
वेबपेज से सभी लिंक प्राप्त करने के लिए -
links = response.css('a::attr(href)').extract()
आउटपुट
['https://www.google.com/intl/en_us/chrome/browser/desktop/index.html', 'https://support.apple.com/downloads/', 'https://www.mozilla.org/en-US/firefox/new/', 'https://windows.microsoft.com/en-us/internet-explorer/download-ie', 'https://www.barrons.com', 'https://bigcharts.marketwatch.com', 'https://www.wsj.com/public/page/wsj-x-marketing.html', 'https://www.dowjones.com/', 'https://global.factiva.com/factivalogin/login.asp?productname=global', 'https://www.fnlondon.com/', 'https://www.mansionglobal.com/', 'https://www.marketwatch.com', 'https://newsplus.wsj.com', 'https://privatemarkets.dowjones.com', 'https://djlogin.dowjones.com/login.asp?productname=rnc', 'https://www.wsj.com/conferences', 'https://www.wsj.com/pro/centralbanking', 'https://www.wsj.com/video/', 'https://www.wsj.com', 'https://www.bigdecisions.com/', 'https://www.businessspectator.com.au/', 'https://www.checkout51.com/?utm_source=wsj&utm_medium=digitalhousead&utm_campaign=wsjspotlight', 'https://www.harpercollins.com/', 'https://housing.com/', 'https://www.makaan.com/', 'https://nypost.com/', 'https://www.newsamerica.com/', 'https://www.proptiger.com', 'https://www.rea-group.com/', …… ……
WSJ (वॉल स्ट्रीट जर्नल) वेबपेज से कमेंट काउंट प्राप्त करने के लिए -
In [38]: response.css(".wsj-comment-count::text").extract()
Out[38]: ['71', '59']
उपरोक्त सिर्फ scrapy के माध्यम से वेब-स्क्रैपिंग का परिचय है, हम scrapy के साथ बहुत कुछ कर सकते हैं।