कंप्यूटर विज्ञान में वेब स्क्रैपिंग का अर्थ वेबसाइटों से डेटा निकालना है। इस तकनीक का उपयोग करके वेब पर असंरचित डेटा को संरचित डेटा में बदलें।
पायथन 3 में सबसे आम वेब स्क्रैपिंग टूल्स हैं -
- Urllib2
- Requests
- BeautifulSoup
- Lxml
- Selenium
- MechanicalSoup
Urllib2 - यह टूल पायथन के साथ प्री-इंस्टॉल्ड आता है। यह मॉड्यूल URL निकालने के लिए उपयोग किया जाता है। urlopen() फ़ंक्शन का उपयोग करके विभिन्न प्रोटोकॉल (FTP, HTTP आदि) का उपयोग करके URL प्राप्त करना।
उदाहरण कोड
from urllib.request import urlopen
my_html = urlopen("https://www.tutorialspoint.com/")
print(my_html.read())
आउटपुट
b'Requests - यह मॉड्यूल प्रीइंस्टॉल्ड नहीं है, हमें कमांड प्रॉम्प्ट में कमांड लाइन लिखनी होगी। Requests HTTP/1.1 को अनुरोध भेजता है।
pip install requests
उदाहरण
import requests # URL प्राप्त करें my_req = requests.get('https://www.tutorialspoint.com/') print(my_req.encoding) print(my_req.status_code) print(my_req.elapsed) print(my_req.url) print(my_req.history) print(my_req.headers['Content-Type'])आउटपुट
UTF-8 200 0:00:00.205727 https://www.tutorialspoint.com/ [] text/html; charset=UTF-8BeautifulSoup - यह एक पार्सिंग लाइब्रेरी है जिसका उपयोग विभिन्न पार्सर्स में किया जाता है। पायथन की स्टैंडर्ड लाइब्रेरी BeautifulSoup के डिफ़ॉल्ट पार्सर प्रदान करती है। यह एक पार्सर ट्री बनाता है जिसका उपयोग HTML पेज से डेटा निकालने के लिए किया जाता है।
इस मॉड्यूल को स्थापित करने के लिए, हम कमांड प्रॉम्प्ट में कमांड लाइन लिखते हैं।
pip install beautifulsoup4
उदाहरण
from bs4 import BeautifulSoup # requests इम्पोर्ट करना import requests # URL प्राप्त करें my_req = requests.get("https://www.tutorialspoint.com/") my_data = my_req.text my_soup = BeautifulSoup(my_data) for my_link in my_soup.find_all('a'): print(my_link.get('href'))आउटपुट
https://www.tutorialspoint.com/index.htm https://www.tutorialspoint.com/questions/index.php ... (बहुत सारे लिंक्स) ...Lxml - यह एक पार्सिंग लाइब्रेरी है, उच्च-प्रदर्शन, प्रोडक्शन-गुणवत्ता HTML और XML पार्सिंग लाइब्रेरी। यदि हम उच्च-गुणवत्ता, अधिकतम गति चाहते हैं, तो हमें इस लाइब्रेरी का उपयोग करना होगा। इसमें कई मॉड्यूल हैं जिनके द्वारा हम वेबसाइट से डेटा निकाल सकते हैं।
स्थापित करने के लिए हम कमांड प्रॉम्प्ट में लिखते हैं
pip install lxml
उदाहरण
from lxml import etree my_root_elem = etree.Element('html') etree.SubElement(my_root_elem, 'head') etree.SubElement(my_root_elem, 'title') etree.SubElement(my_root_elem, 'body') print(etree.tostring(my_root_elem, pretty_print=True).decode("utf-8"))आउटपुट
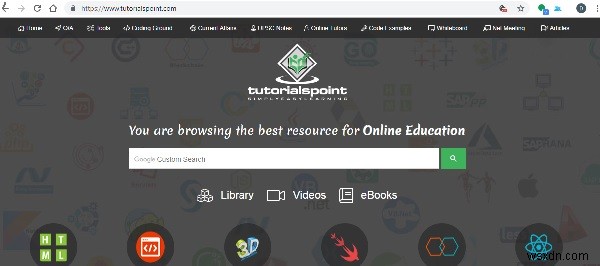
Selenium - यह एक ऑटोमेट ब्राउज़र टूल है, इसे वेब-ड्राइवर्स के रूप में भी जाना जाता है। जब हम किसी वेबसाइट का उपयोग करते हैं, तो हम देखते हैं कि कभी-कभी हमें कुछ समय इंतजार करना पड़ता है, उदाहरण के लिए जब हम किसी बटन पर क्लिक करते हैं या पेज स्क्रॉल करते हैं, इस क्षण में सेलेनियम की आवश्यकता होती है।
सेलेनियम स्थापित करने के लिए हम इस कमांड का उपयोग करते हैं
pip install selenium
उदाहरण
from selenium import webdriver
my_path_to_chromedriver = '/Users/Admin/Desktop/chromedriver'
my_browser = webdriver.Chrome(executable_path=my_path_to_chromedriver)
my_url = 'https://www.tutorialspoint.com/'
my_browser.get(my_url)
आउटपुट
MechanicalSoup - यह वेबसाइटों के साथ इंटरैक्शन को स्वचालित करने के लिए एक और पायथन लाइब्रेरी है। इसका उपयोग करके हम स्वचालित रूप से कुकीज़ स्टोर और भेज सकते हैं, रीडायरेक्ट का पालन कर सकते हैं, और लिंक्स का पालन कर सकते हैं और फॉर्म सबमिट कर सकते हैं। यह जावास्क्रिप्ट नहीं करता है।
स्थापित करने के लिए हम निम्नलिखित कमांड का उपयोग कर सकते हैं
pip install MechanicalSoup
उदाहरण
import mechanicalsoup
my_browser = mechanicalsoup.StatefulBrowser()
my_value = my_browser.open("https://www.tutorialspoint.com/")
print(my_value)
my_val = my_browser.get_url()
print(my_val)
my_va = my_browser.follow_link("forms")
print(my_va)
my_value1 = my_browser.get_url()
print(my_value1)