वेब स्क्रैपिंग न केवल डेटा विज्ञान के प्रति उत्साही लोगों को उत्साहित करता है, बल्कि छात्रों या शिक्षार्थियों को भी, जो वेबसाइटों में गहराई से जाना चाहते हैं। पायथन कई वेब स्क्रैपिंग लाइब्रेरी प्रदान करता है, जिनमें शामिल हैं:
- Scrapy
- Urllib
- BeautifulSoup
- Selenium
- Python Requests
- LXML
हम पायथन के lxml लाइब्रेरी पर चर्चा करेंगे जिसका उपयोग वेबपेज से डेटा स्क्रैप करने के लिए किया जाता है, जो C में लिखित libxml2 XML पार्सिंग लाइब्रेरी के शीर्ष पर बनाया गया है, जो इसे ब्यूटीफुल सूप की तुलना में तेज़ बनाता है लेकिन कुछ कंप्यूटरों, विशेष रूप से विंडोज़ पर इंस्टॉल करना कठिन भी बनाता है।
lxml इंस्टॉल करना और आयात करना
lxml को कमांड लाइन का उपयोग करके pip से इंस्टॉल किया जा सकता है:
pip install lxml
या
conda install -c anaconda lxml
एक बार lxml इंस्टॉलेशन पूरा हो जाने पर, html मॉड्यूल आयात करें, जो lxml से HTML पार्स करता है:
>>> from lxml import html
उस पेज का सोर्स कोड प्राप्त करें जिसे आप स्क्रैप करना चाहते हैं - हमारे पास दो विकल्प हैं: या तो हम पायथन रिक्वेस्ट लाइब्रेरी या urllib का उपयोग कर सकते हैं और इसका उपयोग करके एक lxml HTML एलिमेंट ऑब्जेक्ट बना सकते हैं जिसमें पेज का संपूर्ण HTML होता है। हम पेज की HTML सामग्री डाउनलोड करने के लिए रिक्वेस्ट लाइब्रेरी का उपयोग करने जा रहे हैं।
पायथन रिक्वेस्ट इंस्टॉल करने के लिए, बस अपनी पसंद के टर्मिनल में यह सरल कमांड चलाएं:
$ pipenv install requests
याहू फाइनेंस से डेटा स्क्रैप करना
मान लीजिए हम google.finance या yahoo.finance से स्टॉक/इक्विटी डेटा स्क्रैप करना चाहते हैं। नीचे याहू फाइनेंस से माइक्रोसॉफ्ट कॉर्पोरेशन का स्क्रीनशॉट है:
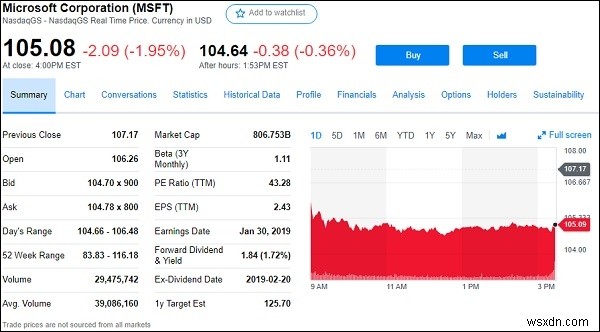
तो उपरोक्त (https://finance.yahoo.com/quote/msft) से, हम स्टॉक के सभी फ़ील्ड निकालने जा रहे हैं जो ऊपर दिखाई दे रहे हैं जैसे:
- पिछला बंद, खुला, बोली, पूछ, दिन की सीमा, 52-सप्ताह की सीमा, वॉल्यूम और इसी तरह।
नीचे पायथन lxml मॉड्यूल का उपयोग करके इसे पूरा करने का कोड है:
lxml_scrape3.py
from lxml import html
import requests
from time import sleep
import json
import argparse
from collections import OrderedDict
from time import sleep

def parse(ticker):
    url = "https://finance.yahoo.com/quote/%s?p=%s" % (ticker, ticker)
    response = requests.get(url, verify=False)
    print("Parsing %s" % (url))
    sleep(4)
    parser = html.fromstring(response.text)
    summary_table = parser.xpath('//div[contains(@data-test,"summary-table")]//tr')
    summary_data = OrderedDict()
    other_details_json_link = "https://query2.finance.yahoo.com/v10/finance/quoteSummary/{0}?formatted=true&lang=en-US®ion=US&modules=summaryProfile%2CfinancialData%2CrecommendationTrend%2CupgradeDowngradeHistory%2Cearnings%2CdefaultKeyStatistics%2CcalendarEvents&corsDomain=finance.yahoo.com".format(ticker)
    summary_json_response = requests.get(other_details_json_link)
    try:
        json_loaded_summary = json.loads(summary_json_response.text)
        y_Target_Est = json_loaded_summary["quoteSummary"]["result"][0]["financialData"]["targetMeanPrice"]['raw']
        earnings_list = json_loaded_summary["quoteSummary"]["result"][0]["calendarEvents"]['earnings']
        eps = json_loaded_summary["quoteSummary"]["result"][0]["defaultKeyStatistics"]["trailingEps"]['raw']
        datelist = []
        for i in earnings_list['earningsDate']:
            datelist.append(i['fmt'])
        earnings_date = ' to '.join(datelist)
        for table_data in summary_table:
            raw_table_key = table_data.xpath('.//td[contains(@class,"C(black)")]//text()')
            raw_table_value = table_data.xpath('.//td[contains(@class,"Ta(end)")]//text()')
            table_key = ''.join(raw_table_key).strip()
            table_value = ''.join(raw_table_value).strip()
            summary_data.update({table_key: table_value})
        summary_data.update({'1y Target Est': y_Target_Est, 'EPS (TTM)': eps, 'Earnings Date': earnings_date, 'ticker': ticker, 'url': url})
        return summary_data
    except:
        print("Failed to parse json response")
        return {"error": "Failed to parse json response"}

if __name__ == "__main__":
    argparser = argparse.ArgumentParser()
    argparser.add_argument('ticker', help='')
    args = argparser.parse_args()
    ticker = args.ticker
    print("Fetching data for %s" % (ticker))
    scraped_data = parse(ticker)
    print("Writing data to output file")
    with open('%s-summary.json' % (ticker), 'w') as fp:
        json.dump(scraped_data, fp, indent=4)
उपरोक्त कोड चलाने के लिए, अपने कमांड टर्मिनल में बस नीचे टाइप करें:
c:\Python\Python361>python lxml_scrape3.py MSFT
lxml_scrap3.py चलाने पर, आप देखेंगे कि आपके वर्तमान कार्य निर्देशिका में एक .json फ़ाइल बनाई गई है जिसका नाम "stockName-summary.json" जैसा कुछ है। चूंकि मैं याहू फाइनेंस से msft (माइक्रोसॉफ्ट) फ़ील्ड निकालने की कोशिश कर रहा हूँ, इसलिए "msft-summary.json" नाम से एक फ़ाइल बनाई गई है।
नीचे उत्पन्न आउटपुट का स्क्रीनशॉट है:
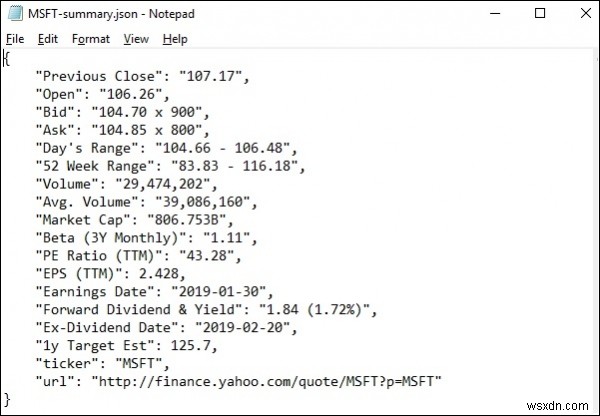
तो हमने सफलतापूर्वक lxml और रिक्वेस्ट का उपयोग करके माइक्रोसॉफ्ट के याहू फाइनेंस से सभी आवश्यक डेटा को स्क्रैप कर लिया है और फिर डेटा को एक फ़ाइल में सहेजा है जिसे बाद में माइक्रोसॉफ्ट स्टॉक के मूल्य आंदोलन को साझा करने या विश्लेषण करने के लिए उपयोग किया जा सकता है।