लीनियर रिग्रेशन मशीन लर्निंग में सबसे सरल मानक टूल्स में से एक है जो दो वेरिएबल्स के बीच पॉजिटिव या नेगेटिव रिलेशनशिप को इंगित करता है।
लीनियर रिग्रेशन क्विक प्रेडिक्टिव एनालिसिस के लिए कुछ अच्छे टूल्स में से एक है। इस सेक्शन में हम पायथन पैंडास पैकेज का उपयोग करके डेटा लोड करेंगे और फिर लीनियर रिग्रेशन मॉडल्स का अनुमान, व्याख्या और विज़ुअलाइज़ेशन करेंगे।
रिग्रेशन क्या है?
रिग्रेशन प्रेडिक्टिव मॉडलिंग तकनीक का एक रूप है जो एक डिपेंडेंट और इंडिपेंडेंट वेरिएबल के बीच रिलेशनशिप बनाने में मदद करता है।
रिग्रेशन के प्रकार
- लीनियर रिग्रेशन
- लॉजिस्टिक रिग्रेशन
- पॉलीनोमियल रिग्रेशन
- स्टेपवाइज़ रिग्रेशन
लीनियर रिग्रेशन कहां उपयोग किया जाता है?
- ट्रेंड्स और सेल्स अनुमानों का मूल्यांकन
- मूल्य परिवर्तनों के प्रभाव का विश्लेषण
- जोखिम का आकलन
हमारे लीनियर रिग्रेशन मॉडल को बनाने के चरण
- सबसे पहले हम सेटअप बनाएंगे और डेटासेट और जुपिटर (जिसका उपयोग मैं इस ट्यूटोरियल के लिए कर रहा हूं, आप एनाकोंडा जैसे अन्य IDE का उपयोग कर सकते हैं) डाउनलोड करेंगे।
- आवश्यक पैकेज और डेटासेट इम्पोर्ट करें।
- अपने डेटासेट लोड होने के साथ, हम अपने डेटासेट का पता लगाएंगे।
- अपने डेटासेट के साथ लीनियर रिग्रेशन करेंगे।
- फिर हम अपने वेरिएबल और दिन के समय के बीच संबंध का पता लगाएंगे।
- सारांश।
सेटअप
आप नीचे दिए गए लिंक से डेटासेट डाउनलोड कर सकते हैं,
https://en.openei.org/datasets/dataset/649aa6d3-2832-4978-bc6e-fa563568398e/resource/b710e97d-29c9-4ca5-8137-63b7cf447317/download/building1retail.csv
जिसका उपयोग हम आउटडोर एयर टेम्परेचर (OAT) को एक एक्सप्लेनेटरी वेरिएबल के रूप में उपयोग करके एक बिल्डिंग की पावर को मॉडल करने के लिए करेंगे।
CSV फाइल को उसी फोल्डर में सेव करें जहां हमारा जुपिटर या IDE इंस्टॉल है।
आवश्यक लाइब्रेरीज़ इम्पोर्ट करें और डेटासेट लोड करें
# आवश्यक लाइब्रेरीज़ इम्पोर्ट करें
import pandas as pd
import numpy as np
from scipy import stats
from datetime import datetime
from sklearn import preprocessing
from sklearn.model_selection import KFold
from sklearn.linear_model import LinearRegression
import matplotlib.pyplot as plt
%matplotlib inline

# डेटा पढ़ें
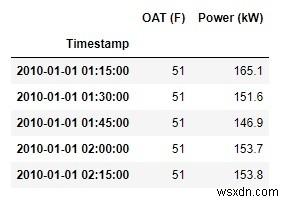
df = pd.read_csv('building1retail.csv', index_col=[0], date_parser=lambda x: datetime.strptime(x, "%m/%d/%Y %H:%M"))
df.head()
आउटपुट
डेटासेट का अन्वेषण
आइए पहले पैंडास के साथ प्लॉट करके अपने डेटासेट को विज़ुअलाइज़ करें।
df.plot(figsize=(22,6))
आउटपुट
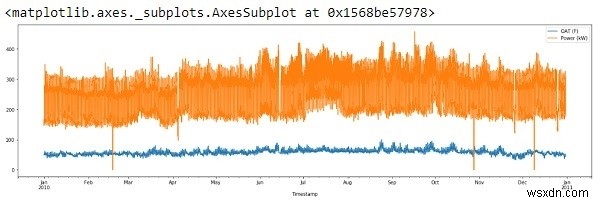
तो, x-अक्ष Jan 2010 - Jan 2011 का डेटा दिखा रहा है।
यदि हम उपरोक्त आउटपुट देखते हैं, तो हम प्लॉट के बारे में दो अजीब चीजें देख सकते हैं:
- कोई मिसिंग डेटा नहीं लगता है, इसे जांचने के लिए, बस चलाएं:
df.isnull().values.any()
आउटपुट
False
False परिणाम बता रहा है कि डेटाफ्रेम में कोई नल वैल्यू नहीं है।
- डेटा में कुछ विसंगतियां प्रतीत होती हैं (लंबे डाउनवर्ड स्पाइक्स)
विसंगतियां या 'आउटलेयर्स' आमतौर पर एक्सपेरिमेंटल एरर का परिणाम होते हैं या शायद वास्तविक मान हो सकते हैं। किसी भी मामले में, हम इन्हें छोड़ देंगे क्योंकि वे रिग्रेशन लाइन के स्लोप को गंभीर रूप से प्रभावित करते हैं।
इससे पहले कि हम 'आउटलेयर्स' को छोड़ें, आइए पहले जांचें कि हमारा डेटा किस प्रकार का वितरण दर्शा रहा है:
df.hist()
आउटपुट
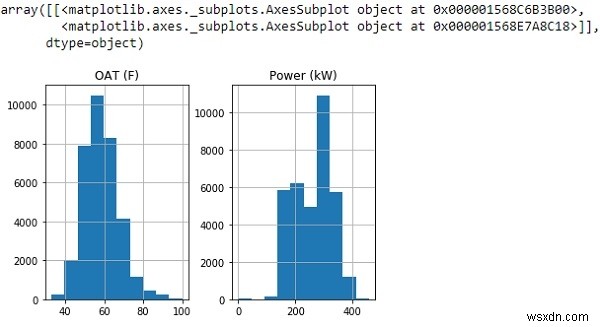
उपरोक्त हिस्टोग्राम से, हम देख सकते हैं कि हमारा ग्राफ डेटा दिखा रहा है जो मोटे तौर पर एक नॉर्मल डिस्ट्रीब्यूशन का पालन करता है।
तो आइए माध्य से 3 स्टैंडर्ड डेविएशन से अधिक सभी मानों को छोड़ दें और नए डेटाफ्रेम को प्लॉट करें।
std_dev = 3
df = df[(np.abs(stats.zscore(df)) < float(std_dev)).all(axis=1)]
df.plot(figsize=(22, 6))
आउटपुट
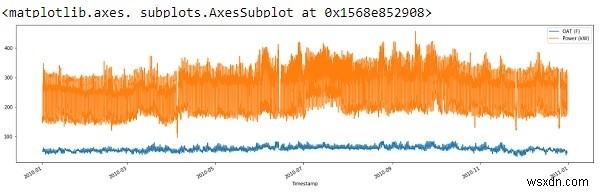
उपरोक्त आउटपुट से हम देख सकते हैं, हमने कुछ हद तक स्पाइक्स को हटा दिया है और अपने डेटा को साफ किया है।
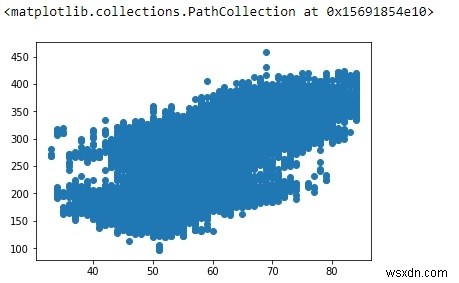
लीनियर रिलेशनशिप को मान्य करें
यह पता लगाने के लिए कि OAT और पावर के बीच कोई लीनियर रिलेशन है या नहीं, आइए एक सिंपल स्कैटर प्लॉट प्लॉट करें:
plt.scatter(df['OAT (F)'], df['Power (kW)'])
आउटपुट
लीनियर रिग्रेशन
मॉडल चलाने और इसके प्रदर्शन का आकलन करने के लिए हम Scikit-learn मॉड्यूल का उपयोग करने जा रहे हैं, साथ ही हम अपने मॉडल के प्रदर्शन का आकलन करने के लिए k-folds क्रॉस वैलिडेशन (k=3) का उपयोग करने जा रहे हैं।
X = pd.DataFrame(df['OAT (F)'])
y = pd.DataFrame(df['Power (kW)'])
model = LinearRegression()
scores = []
kfold = KFold(n_splits=3, shuffle=True, random_state=42)
for i, (train, test) in enumerate(kfold.split(X, y)):
    model.fit(X.iloc[train,:], y.iloc[train,:])
    score = model.score(X.iloc[test,:], y.iloc[test,:])
    scores.append(score)
print(scores)
आउटपुट
[0.38768927735902703, 0.3852220878090444, 0.38451654781487116]
उपरोक्त प्रोग्राम में, model = LinearRegression() एक लीनियर रिग्रेशन मॉडल बनाता है और फॉर लूप डेटासेट को तीन फोल्ड्स में विभाजित करता है। फिर लूप के अंदर, हम डेटा को फिट करते हैं और फिर इसके स्कोर को सूची में जोड़कर इसके प्रदर्शन का आकलन करते हैं।
हालांकि, परिणाम अच्छे नहीं लगते और हम इसके प्रदर्शन में सुधार कर सकते हैं।
दिन का समय
पावर (वेरिएबल) दिन के समय पर अत्यधिक निर्भर है। आइए इस जानकारी का उपयोग वन-हॉट एन्कोडिंग का उपयोग करके इसे अपने रिग्रेशन मॉडल में शामिल करने के लिए करें।
model = LinearRegression()
scores = []
kfold = KFold(n_splits=3, shuffle=True, random_state=42)
for i, (train, test) in enumerate(kfold.split(X, y)):
    model.fit(X.iloc[train,:], y.iloc[train,:])
    scores.append(model.score(X.iloc[test,:], y.iloc[test,:]))
print(scores)
आउटपुट
[0.8074246958895391, 0.8139449185141592, 0.8111379602960773]
यह हमारे मॉडल में एक बड़ा अंतर है।
सारांश
इस सेक्शन में, हमने डेटासेट का पता लगाने और इसे रिग्रेशन मॉडल में फिट करने के लिए तैयार करने की मूल बातें सीखीं। हमने इसके प्रदर्शन का आकलन किया, इसकी कमियों का पता लगाया और इसे ठीक किया।