Scrapy स्पाइडर
Scrapy स्पाइडर एक क्लास है जो वेबसाइट के लिंक का पालन करने और वेबपेज से जानकारी निकालने की सुविधा प्रदान करती है।
यह मुख्य क्लास है जिससे अन्य स्पाइडर्स को इनहेरिट करना चाहिए।
Scrapinghub
Scrapinghub एक ओपन सोर्स एप्लिकेशन है जो Scrapy स्पाइडर्स को चलाता है। Scrapinghub वेब कंटेंट को कुछ उपयोगी डेटा या जानकारी में बदल देता है। यह हमें वेबपेज से डेटा निकालने की अनुमति देता है, यहां तक कि जटिल वेबपेज के लिए भी।
हम स्क्रैपी स्पाइडर्स को क्लाउड पर डिप्लॉय और एक्जीक्यूट करने के लिए scrapinghub का उपयोग करने जा रहे हैं।
Scrapinghub पर स्पाइडर्स डिप्लॉय करने के चरण -
चरण 1 -
एक scrapy प्रोजेक्ट बनाएं -
scrapy इंस्टॉल करने के बाद, बस अपने टर्मिनल में निम्नलिखित कमांड चलाएं -
$scrapy startproject
अपनी डायरेक्टरी को अपने नए प्रोजेक्ट (project_name) में बदलें।
चरण 2 -
अपनी टार्गेट वेबसाइट के लिए एक scrapy स्पाइडर लिखें, आइए एक सामान्य वेबसाइट "quotes.toscrape.com" लेते हैं।
नीचे मेरा बहुत सरल scrapy स्पाइडर है -
कोड -
# scrapy लाइब्रेरी आयात करें
import scrapy

class AllSpider(scrapy.Spider):
    crawled = set()
    # स्पाइडर नाम
    name = 'all'
    # प्रारंभिक URL
    start_urls = ['https://www.tutorialspoint.com/']

    def __init__(self):
        self.links = []

    def parse(self, response):
        self.links.append(response.url)
        for href in response.css('a::attr(href)'):
            yield response.follow(href, self.parse)
चरण 3 -
अपना स्पाइडर चलाएं और आउटपुट को अपने links.json फ़ाइल में सेव करें -
उपरोक्त कोड निष्पादित करने के बाद, आप सभी लिंक को स्क्रैप कर पाएंगे और इसे links.json फ़ाइल के अंदर सेव कर पाएंगे। यह एक लंबी प्रक्रिया नहीं हो सकती है लेकिन इसे लगातार 24/7 चलाने के लिए हमें इस स्पाइडर को Scrapinghub पर डिप्लॉय करने की आवश्यकता है।
चरण 4 -
Scrapinghub पर अकाउंट बनाना
इसके लिए, आपको बस ScrapingHub लॉगिन पेज पर अपने Gmail अकाउंट या Github का उपयोग करके लॉगिन करना होगा। यह डैशबोर्ड पर रीडायरेक्ट करेगा।
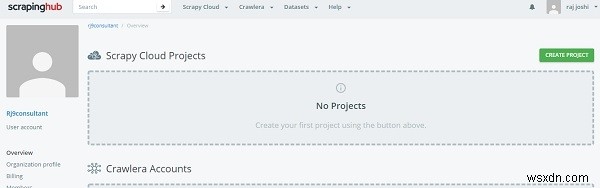
अब Create project पर क्लिक करें और प्रोजेक्ट का नाम बताएं। अब हम अपने प्रोजेक्ट को कमांड लाइन (CLI) या github के माध्यम से क्लाउड पर जोड़ सकते हैं। अगला हम shub CLI के माध्यम से अपना कोड डिप्लॉय करने जा रहे हैं, पहले shub इंस्टॉल करें
$pip install shub
shub इंस्टॉल करने के बाद, अकाउंट बनाने पर जनरेट हुए API की का उपयोग करके shub अकाउंट में लॉगिन करें (https://app.scrapinghub.com/account/apikey से अपना API की दर्ज करें)।
$shub login
यदि आपका API की ठीक है, तो आप अब लॉगिन हो चुके हैं। अब हमें डिप्लॉय आईडी का उपयोग करके इसे डिप्लॉय करने की आवश्यकता है, जो आप "deploy your code" सेक्शन के कमांड लाइन सेक्शन पर देखते हैं (6 अंकों की संख्या)।
$ shub deploy deploy_id
कमांड लाइन से बस इतना ही, अब स्पाइडर्स डैशबोर्ड सेक्शन पर वापस जाएं, उपयोगकर्ता तैयार स्पाइडर देख सकता है। बस स्पाइडर नाम पर क्लिक करें और रन बटन पर। बस इतना ही अब आप अपने डैशबोर्ड में अपना स्पाइडर देख सकते हैं, कुछ इस तरह -
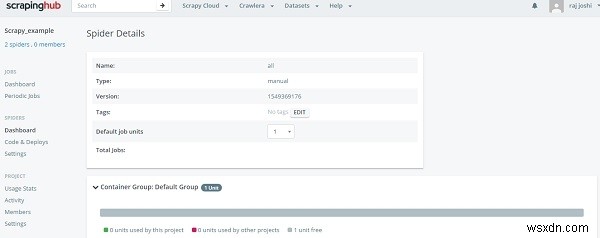
यह हमें एक क्लिक के माध्यम से चल रही प्रगति दिखाएगा और आपको अपना लोकल मशीन 24/7 चलाने की आवश्यकता नहीं है।