सॉफ्टवेयर विकसित करना चुनौतीपूर्ण हो सकता है, लेकिन इसे बनाए रखना कहीं अधिक चुनौतीपूर्ण है। रखरखाव में सॉफ्टवेयर पैच और सर्वर रखरखाव शामिल हैं। इस पोस्ट में, हम सर्वर प्रबंधन और रखरखाव पर ध्यान केंद्रित करेंगे।
पारंपरिक रूप से, सर्वर ऑन-प्रिमाइसेस थे, जिसका अर्थ है भौतिक हार्डवेयर खरीदना और बनाए रखना। क्लाउड कंप्यूटिंग के साथ, इन सर्वरों को अब भौतिक रूप से स्वामित्व में रखने की आवश्यकता नहीं है। 2006 में, जब अमेज़ॅन ने AWS शुरू किया और अपनी EC2 सेवा पेश की, तो आधुनिक क्लाउड कंप्यूटिंग का युग शुरू हुआ। इस प्रकार की सेवा के साथ, हमें अब भौतिक सर्वरों को बनाए रखने या भौतिक हार्डवेयर को अपग्रेड करने की आवश्यकता नहीं थी। इसने बहुत सारी समस्याओं को हल किया, लेकिन सर्वर रखरखाव और संसाधन प्रबंधन अभी भी हमारे ऊपर हैं। इन विकासों को अगले स्तर पर ले जाते हुए, हमारे पास अब सर्वरलेस तकनीक है।
सर्वरलेस तकनीक क्या है?
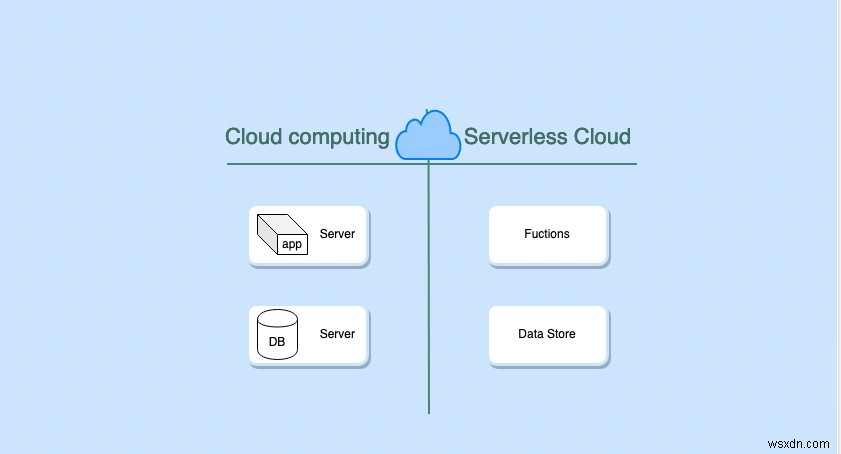
सर्वरलेस तकनीक सर्वर को प्रबंधित और प्रोविजन करने के काम को क्लाउड प्रोवाइडर पर ऑफलोड करने में मदद करती है। इस पोस्ट में, हम AWS पर चर्चा करेंगे।
सर्वरलेस शब्द का अर्थ यह नहीं है कि कोई सर्वर बिल्कुल नहीं है। एक सर्वर है, लेकिन यह क्लाउड प्रोवाइडर द्वारा पूरी तरह से प्रबंधित है। एक अर्थ में, सर्वरलेस तकनीक के उपयोगकर्ताओं के लिए, कोई दृश्यमान सर्वर नहीं है। सर्वर सीधे हमारे लिए दृश्यमान नहीं हैं, और उन्हें प्रबंधित करने का काम क्लाउड प्रोवाइडर द्वारा स्वचालित है। यहां कुछ विशेषताएं हैं जो इसे सर्वरलेस बनाती हैं:
- कोई ऑपरेशनल प्रबंधन नहीं - सर्वर को पैच करने या उच्च उपलब्धता के लिए उन्हें प्रबंधित करने की आवश्यकता नहीं;
- आवश्यकतानुसार स्केल करें - केवल कुछ उपयोगकर्ताओं की सेवा करने से लेकर लाखों उपयोगकर्ताओं की सेवा करने तक;
- जितना उपयोग उतना भुगतान करें - लागत उपयोग के आधार पर प्रबंधित की जाती है।
सर्वरलेस तकनीक को निम्नानुसार वर्गीकृत किया जा सकता है:
- कंप्यूट (उदाहरण के लिए, Lambda और Fargate)
- स्टोरेज (उदाहरण के लिए, S3)
- डेटा स्टोर (उदाहरण के लिए, DynamoDB और Aurora)
- इंटीग्रेशन (उदाहरण के लिए, API Gateway, SNS, और SQS)
- एनालिटिक्स (उदाहरण के लिए, Kinesis और Athena)
सर्वरलेस तकनीक का उपयोग क्यों करें?
लागत
जितना उपयोग उतना भुगतान सर्वरलेस तकनीक का उपयोग करने के मुख्य लाभों में से एक है। जब ट्रैफिक वॉल्यूम में अप्रत्याशित परिवर्तन होता है, तो आपको उपयोग पैटर्न के आधार पर सर्वर को ऊपर या नीचे स्केल करने की आवश्यकता होती है, लेकिन सेल्फ-मैनेज्ड ऑटोस्केलिंग के साथ स्केल करना मुश्किल और अक्षम हो सकता है। सर्वरलेस कंप्यूटिंग, जैसे AWS Lambda, लागत बचाने में आसानी से मदद कर सकती है क्योंकि निष्क्रिय समय के दौरान भुगतान करने की कोई आवश्यकता नहीं है।
डेवलपर उत्पादकता
चूंकि सर्वरलेस कंप्यूटिंग क्लाउड प्रोवाइडर द्वारा प्रदान की जाने वाली पूरी तरह से प्रबंधित सेवाओं को संदर्भित करती है, इसलिए डेवलपर्स को सर्वर प्रोविजन करने या सर्वर एप्लिकेशन विकसित करने की आवश्यकता नहीं है। डेवलपर्स सर्वर का प्रबंधन किए बिना तुरंत कोडिंग शुरू कर सकते हैं। यह दृष्टिकोण सर्वर को पैच करने या ऑटोस्केलिंग प्रबंधित करने की आवश्यकता को भी हटा देता है। इस सभी समय को बचाने से डेवलपर्स की उत्पादकता बढ़ाने में मदद मिलती है।
लोच
सर्वरलेस कंप्यूटिंग अत्यधिक लोचदार है और उपयोग के आधार पर ऊपर या नीचे स्केल कर सकती है। उपयोगकर्ताओं में स्पाइक को आसानी से संभाला जा सकता है। यह एक बड़ा लाभ हो सकता है और डेवलपर्स का बहुत समय बचाने में मदद करता है।
उच्च उपलब्धता
जब कंप्यूटिंग सर्वरलेस होती है और क्लाउड प्रोवाइडर द्वारा प्रबंधित होती है और सर्वर का उच्च अपटाइम होता है, तो फेलओवर स्वचालित रूप से संभाले जाते हैं। इस तरह के मुद्दों को प्रबंधित करने के लिए विशेष कौशल की आवश्यकता होती है। सर्वरलेस दृष्टिकोण के साथ, ऑप्स और डेवलपर्स का काम एक ही व्यक्ति द्वारा किया जा सकता है।
रूबी में सर्वरलेस कार्यक्षमता को कैसे लागू करें
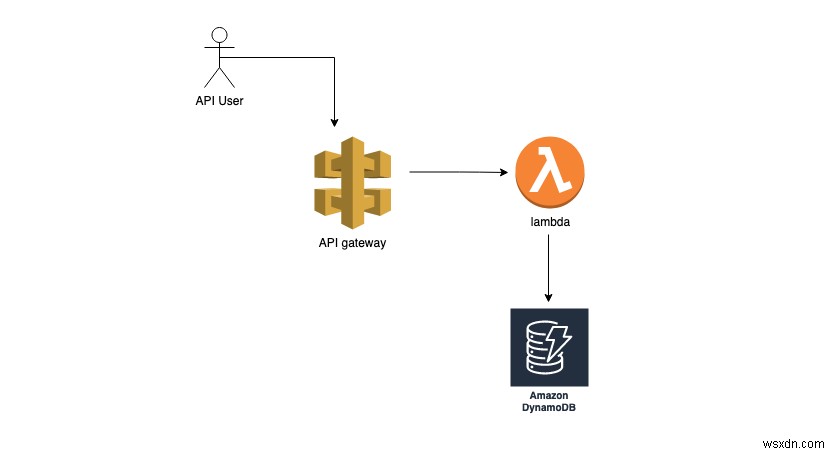
AWS के अनुसार, रूबी AWS में सबसे व्यापक रूप से उपयोग की जाने वाली भाषाओं में से एक है। Lambda ने नवंबर 2018 में रूबी का समर्थन शुरू किया। हम AWS द्वारा प्रदान की गई केवल सर्वरलेस तकनीकों का उपयोग करके रूबी में एक वेब API बनाएंगे।
AWS में सर्वरलेस इन्फ्रा बनाने के लिए, हम बस AWS कंसोल में लॉग इन कर सकते हैं और उन्हें बनाना शुरू कर सकते हैं। हालांकि, हम कुछ ऐसा विकसित करना चाहते हैं जो आसानी से टेस्टेबल हो और डिजास्टर रिकवरी की सुविधा प्रदान करे। हम सर्वरलेस फीचर को कोड के रूप में लिखेंगे। ऐसा करने के लिए, AWS सर्वरलेस एप्लिकेशन मॉडल (SAM) प्रदान करता है। SAM AWS में सर्वरलेस एप्लिकेशन बनाने के लिए उपयोग किया जाने वाला एक फ्रेमवर्क है। यह Lambda, डेटाबेस, और API को डिजाइन करने के लिए YAML-आधारित सिंटैक्स प्रदान करता है। AWS SAM एप्लिकेशन को AWS SAM-CLI का उपयोग करके बनाया जा सकता है, जिसे इस लिंक के माध्यम से डाउनलोड किया जा सकता है।
AWS SAM CLI AWS CloudFormation के शीर्ष पर बनाया गया है। यदि आप CloudFormation के साथ IaC लिखने से परिचित हैं, तो यह बहुत सरल होगा। वैकल्पिक रूप से, आप सर्वरलेस फ्रेमवर्क का भी उपयोग कर सकते हैं। इस पोस्ट में, मैं AWS SAM का उपयोग करूंगा।
SAM CLI का उपयोग करने से पहले, सुनिश्चित करें कि आपके पास निम्नलिखित हैं:
- AWS प्रोफाइल सेटअप
- Docker इंस्टॉल्ड
- SAM CLI इंस्टॉल्ड
हम एक सर्वरलेस एप्लिकेशन विकसित करेंगे। हम अपने एप्लिकेशन में DynamoDB और Lambda जैसे कुछ सर्वरलेस इन्फ्रा बनाकर शुरू करेंगे। आइए डेटाबेस से शुरू करें:
DynamoDB
DynamoDB एक सर्वरलेस AWS-प्रबंधित डेटाबेस सेवा है। चूंकि यह सर्वरलेस है, इसे सेटअप करना बहुत त्वरित और आसान है। DynamoDB बनाने के लिए, हम SAM टेम्पलेट को निम्नानुसार परिभाषित करते हैं:
AWSTemplateFormatVersion: '2010-09-09'
Transform: AWS::Serverless-2016-10-31
Resources:
  UsersTable:
    Type: AWS::Serverless::SimpleTable
    Properties:
      PrimaryKey:
        Name: id
        Type: String
      TableName: users
SAM CLI और उपरोक्त टेम्पलेट के साथ, हम एक बुनियादी DynamoDB टेबल बना सकते हैं। पहले, हमें अपने सर्वरलेस ऐप के लिए एक पैकेज बनाना होगा। इसके लिए, हम निम्न कमांड चलाते हैं। यह पैकेज बनाएगा और इसे s3 पर पुश करेगा। कमांड चलाने से पहले serverless-users-bucket नाम से s3 बकेट बनाना सुनिश्चित करें:
$ sam package --template-file sam.yaml \
  --output-template-file out.yaml \
  --s3-bucket serverless-users-bucket
s3 अब हमारे सर्वरलेस ऐप के लिए टेम्पलेट और कोड का स्रोत बन जाता है, जिसके बारे में हम बात करेंगे जब हम इसके लिए एक Lambda फंक्शन बनाएंगे।
हम अब इस टेम्पलेट को DynamoDB बनाने के लिए डेप्लॉय कर सकते हैं:
$ sam deploy --template-file out.yaml \
  --stack-name serverless-users-app \
  --capabilities CAPABILITY_IAM
इसके साथ, हमारे पास DynamoDB सेटअप है। अगला, हम एक Lambda बनाएंगे, जहां इस टेबल का उपयोग किया जाएगा।
Lambda
Lambda AWS द्वारा प्रदान की जाने वाली एक सर्वरलेस कंप्यूटिंग सेवा है। इसका उपयोग वास्तविक सर्वर प्रबंधन की आवश्यकता के बिना, जहां कोड निष्पादित होता है, आवश्यकतानुसार कोड निष्पादित करने के लिए किया जा सकता है। Lambda का उपयोग Async प्रक्रियाओं, REST APIs, या किसी भी शेड्यूल्ड जॉब्स को चलाने के लिए किया जा सकता है। हमें बस एक हैंडलर फंक्शन लिखना है और फंक्शन को AWS Lambda पर पुश करना है। Lambda इवेंट्स के आधार पर कार्य को निष्पादित करने का काम करेगा। एक इवेंट विभिन्न स्रोतों द्वारा ट्रिगर किया जा सकता है, जैसे API gateway, SQS, या S3; इसे किसी अन्य कोडबेस द्वारा भी ट्रिगर किया जा सकता है। जब ट्रिगर किया जाता है, तो यह Lambda फंक्शन इवेंट्स और कॉन्टेक्स्ट पैरामीटर्स प्राप्त करता है। इन पैरामीटर्स में मान ट्रिगर के स्रोत के आधार पर भिन्न होते हैं। हम इन इवेंट्स को हैंडलर को पास करके Lambda फंक्शन को मैन्युअली या प्रोग्रामेटिकली भी ट्रिगर कर सकते हैं। एक हैंडलर दो आर्गुमेंट्स लेता है:
इवेंट - इवेंट्स आमतौर पर ट्रिगर के स्रोत से पास किया गया एक की-वैल्यू हैश होता है। ये मान विभिन्न स्रोतों द्वारा ट्रिगर किए जाने पर स्वचालित रूप से पास होते हैं, जैसे SQS, Kinesis, या एक API gateway। जब मैन्युअली ट्रिगर करते हैं, तो हम यहां इवेंट्स पास कर सकते हैं। इवेंट में Lambda फंक्शन हैंडलर के लिए इनपुट डेटा होता है। उदाहरण के लिए, एक API gateway में, अनुरोध बॉडी इस इवेंट के अंदर होती है।
कॉन्टेक्स्ट - कॉन्टेक्स्ट हैंडलर फंक्शन में दूसरा आर्गुमेंट है। इसमें विशिष्ट विवरण शामिल हैं, जिसमें ट्रिगर का स्रोत, Lambda फंक्शन नाम, संस्करण, रिक्वेस्ट-आईडी, और बहुत कुछ शामिल है।
हैंडलर का आउटपुट उस सेवा को वापस पास किया जाता है जिसने Lambda फंक्शन को ट्रिगर किया। Lambda फंक्शन का आउटपुट हैंडलर फंक्शन का रिटर्न वैल्यू है।
AWS Lambda सात अलग-अलग भाषाओं का समर्थन करता है जिनमें आप कोड कर सकते हैं, जिसमें रूबी शामिल है। यहां, हम DynamoDB से कनेक्ट करने के लिए AWS Ruby-sdk का उपयोग करेंगे।
कोड लिखने से पहले, आइए SAM टेम्पलेट का उपयोग करके Lambda के लिए एक इन्फ्रा बनाएं:
AWSTemplateFormatVersion: "2010-09-09"
Transform: AWS::Serverless-2016-10-31
Description: "Serverless users app"
Resources:
  CreateUserFunction:
    Type: AWS::Serverless::Function
    Properties:
      Handler: users.create
      Runtime: ruby2.7
      Policies:
        - DynamoDBWritePolicy:
            TableName: !Ref UsersTable
      Environment:
        Variables:
          USERS_TABLE: !Ref UsersTable
हैंडलर में, हम निष्पादित किए जाने वाले फंक्शन के संदर्भ को Handler: <filename>.<method_name> के रूप में लिखते हैं।
सर्वरलेस पॉलिसी टेम्पलेट का संदर्भ लें एक पॉलिसी के लिए जिसे आप Lambda से जोड़ सकते हैं आधारित संसाधन पर जिसका यह उपयोग करता है। चूंकि हमारा Lambda फंक्शन DynamoDB में लिखता है, हमने पॉलिसीज़ सेक्शन में DynamoDBWritePolicy का उपयोग किया है।
हम Lambda फंक्शन को env वेरिएबल USERS_TABLE भी प्रदान कर रहे हैं ताकि यह निर्दिष्ट डेटाबेस को अनुरोध भेज सके।
तो, Lambda इन्फ्रा के लिए हमें यही चाहिए। अब, आइए DynamoDB में एक यूजर बनाने के लिए कोड लिखें, जिसे Lambda फंक्शन निष्पादित करेगा।
Gemfile में AWS रिकॉर्ड जोड़ें:
# Gemfile
source 'https://rubygems.org' do
  gem 'aws-record', '~> 2'
end
इनपुट को DynamoDB में लिखने के लिए कोड जोड़ें:
# users.rb
require 'aws-record'

class UsersTable
  include Aws::Record
  set_table_name ENV['USERS_TABLE']
  string_attr :id, hash_key: true
  string_attr :body
end

def create(event:, context:)
  body = event["body"]
  id = SecureRandom.uuid
  user = UsersTable.new(id: id, body: body)
  user.save!
  user.to_h
end
यह बहुत त्वरित और आसान है। AWS DynamoDB तक पहुंचने के लिए aws-record जेम प्रदान करता है, जो रेल्स के activerecord के समान है।
अब, निर्भरताओं को इंस्टॉल करने के लिए निम्न कमांड चलाएं।
नोट: सुनिश्चित करें कि आपके पास Lambda में परिभाषित रूबी का वही संस्करण है। यहां उदाहरण के लिए, आपको अपने मशीन पर Ruby2.7 इंस्टॉल्ड चाहिए।
# निर्भरताएं इंस्टॉल करें
$ bundle install
$ bundle install --deployment
परिवर्तनों को पैकेज करें:
$ sam package --template-file sam.yaml \
  --output-template-file out.yaml \
  --s3-bucket serverless-users-bucket
डेप्लॉय करें:
sam deploy --template-file out.yaml \
  --stack-name serverless-users-app \
  --capabilities CAPABILITY_IAM
इस कोड के साथ, हमारे पास अब Lambda चल रहा है, जो इनपुट को डेटाबेस में लिख सकता है। हम Lambda के सामने एक API gateway जोड़ सकते हैं ताकि हम इसे HTTP कॉल्स के माध्यम से एक्सेस कर सकें। एक API gateway बहुत सारी API प्रबंधन कार्यक्षमताएं प्रदान करता है, जैसे रेट लिमिटिंग और ऑथेंटिकेशन। हालांकि, यह उपयोग के आधार पर महंगा हो सकता है। API प्रबंधन के बिना केवल HTTP API का उपयोग करने का एक सस्ता विकल्प है। उपयोग के मामले के आधार पर, आप सबसे उपयुक्त चुन सकते हैं।
AWS Lambda की कुछ सीमाएं हैं। उनमें से कुछ को संशोधित किया जा सकता है, लेकिन अन्य निश्चित हैं:
- मेमोरी - डिफ़ॉल्ट रूप से, निष्पादन समय के दौरान एक Lambda के पास 128 MB मेमोरी होती है। इसे 64 MB के इन्क्रीमेंट में 3,008 MB तक बढ़ाया जा सकता है।
- टाइमआउट - Lambda फंक्शन की कोड निष्पादित करने के लिए एक समय सीमा होती है। डिफ़ॉल्ट सीमा 3 सेकंड है। इसे 900 सेकंड तक बढ़ाया जा सकता है।
- स्टोरेज - Lambda स्टोरेज के लिए एक
/tmpडायरेक्टरी प्रदान करता है। इस स्टोरेज की सीमा 512 MB है। - अनुरोध और प्रतिक्रिया आकार - सिंक्रोनस ट्रिगर के लिए 6 MB तक और एसिंक्रोनस ट्रिगर के लिए 256 MB तक।
- पर्यावरण चर - 4KB तक
चूंकि Lambda की इनमें से कुछ सीमाएं हैं, इसलिए ऐसा कोड लिखना बेहतर है जो इन सीमाओं के भीतर फिट बैठता है। यदि वे नहीं करते हैं, तो हम कोड को विभाजित कर सकते हैं ताकि एक Lambda दूसरे को ट्रिगर करे। AWS द्वारा एक स्टेप फंक्शन भी प्रदान किया जाता है, जिसका उपयोग कई Lambda फंक्शन्स को क्रमबद्ध करने के लिए किया जा सकता है।
सर्वरलेस एप्लिकेशन को लोकली कैसे टेस्ट करें?
सर्वरलेस एप्लिकेशन के लिए, हमें एक वेंडर की आवश्यकता होती है जो प्रबंधित सर्वरलेस सेवाएं प्रदान करता है। हम अपने एप्लिकेशन को टेस्ट करने के लिए AWS पर निर्भर हैं। एप्लिकेशन को टेस्ट करने के लिए, AWS द्वारा कुछ स्थानीय विकल्प प्रदान किए जाते हैं। AWS सर्वरलेस तकनीकों के साथ संगत कुछ ओपन-सोर्स टूल्स का उपयोग भी एप्लिकेशन को स्थानीय रूप से टेस्ट करने के लिए किया जा सकता है।
आइए हमारे Lambda फंक्शन और DynamoDB को टेस्ट करें। ऐसा करने के लिए, हमें इन्हें स्थानीय रूप से चलाने की आवश्यकता है।
पहले, एक डॉकर नेटवर्क बनाएं। नेटवर्क Lambda फंक्शन और DynamoDB के बीच संचार में मदद करेगा।
$ docker network create lambda-local --docker-network lambda-local
DynamoDB लोकल AWS द्वारा प्रदान किया गया DynamoDB का एक स्थानीय संस्करण है, जिसका उपयोग हम इसे स्थानीय रूप से टेस्ट करने के लिए कर सकते हैं। निम्न डॉकर इमेज चलाकर DynamoDB लोकल चलाएं:
$ docker run -p 8000:8000 --network lambda-local --name dynamodb amazon/dynamodb-local
user.rb फाइल में निम्न लाइन जोड़ें। यह Lambda को लोकल DynamoDB से जोड़ेगा:
local_client = Aws::DynamoDB::Client.new(
  region: "local",
  endpoint: 'https://dynamodb:8000'
)
UsersTable.configure_client(client: local_client)
एक input.json फाइल जोड़ें, जिसमें Lambda के लिए इनपुट हो:
{
  "name": "Milap Neupane",
  "location": "Global"
}
Lambda को निष्पादित करने से पहले, हमें लोकल DynamoDB में टेबल जोड़ने की आवश्यकता है। ऐसा करने के लिए, हम aws-migrate द्वारा प्रदान की गई माइग्रेशन कार्यक्षमता का उपयोग करेंगे। आइए migrate.rb फाइल बनाएं और निम्न माइग्रेशन जोड़ें:
require 'aws-record'
require './users.rb'
local_client = Aws::DynamoDB::Client.new(
  region: "local",
  endpoint: 'https://localhost:8000'
)
migration = Aws::Record::TableMigration.new(UsersTable, client: local_client)
migration.create!(
  provisioned_throughput: {
    read_capacity_units: 5,
    write_capacity_units: 5
  }
)
migration.wait_until_available
अंत में, निम्न कमांड का उपयोग करके Lambda को स्थानीय रूप से निष्पादित करें:
$ sam local invoke "CreateUserFunction" -t sam.yaml \
  -e input.json \
  --docker-network lambda-local
यह DynamoDB टेबल में यूजर का डेटा बनाएगा।
लोकलस्टैक जैसे विकल्प हैं, जो AWS स्टैक्स को स्थानीय रूप से चलाने के लिए हैं।
सर्वरलेस कंप्यूटिंग का उपयोग कब किया जाना चाहिए
यह तय करते समय कि सर्वरलेस कंप्यूटिंग का उपयोग करना है या नहीं, हमें इसके लाभों और कमियों दोनों के बारे में पता होना चाहिए। निम्नलिखित विशेषताओं के आधार पर, हम तय कर सकते हैं कि सर्वरलेस दृष्टिकोण कब उपयोग करना है:
लागत
- जब एप्लिकेशन में निष्क्रिय समय और असंगत ट्रैफिक होता है, तो Lambdas अच्छे होते हैं क्योंकि वे लागत कम करने में मदद करते हैं।
- जब एप्लिकेशन में लगातार ट्रैफिक वॉल्यूम होता है, तो AWS Lambda का उपयोग करना महंगा हो सकता है।
प्रदर्शन
- यदि एप्लिकेशन प्रदर्शन-संवेदनशील नहीं है, तो AWS Lambda का उपयोग करना एक अच्छा विकल्प है।
- Lambdas का एक कोल्ड बूट समय होता है, जो कोल्ड बूट के दौरान धीमी प्रतिक्रिया समय का कारण बन सकता है।
बैकग्राउंड प्रोसेसिंग
- Lambda बैकग्राउंड प्रोसेसिंग के लिए उपयोग करने के लिए एक अच्छा विकल्प है। Sidekiq जैसे कुछ ओपन-सोर्स टूल्स में सर्वर स्केलिंग और रखरखाव ओवरहेड होता है। हम सर्वर रखरखाव की परेशानी के बिना बैकग्राउंड जॉब्स को प्रोसेस करने के लिए AWS Lambda और AWS SQS कतार को जोड़ सकते हैं।
समवर्ती प्रसंस्करण
- जैसा कि हम जानते हैं, रूबी में समवर्ती प्रसंस्करण ऐसा कुछ नहीं है जिसे हम आसानी से कर सकते हैं। Lambda के साथ, हम प्रोग्रामिंग भाषा समर्थन की आवश्यकता के बिना समवर्ती प्रसंस्करण प्राप्त कर सकते हैं। Lambda को समवर्ती रूप से निष्पादित किया जा सकता है और प्रदर्शन को बेहतर बनाने में मदद करता है।
आवधिक या एकबारगी स्क्रिप्ट चलाना
- हम रूबी कोड निष्पादित करने के लिए क्रॉन जॉब्स का उपयोग करते हैं, लेकिन बड़े पैमाने के एप्लिकेशन के लिए क्रॉन जॉब्स का सर्वर रखरखाव मुश्किल हो सकता है। इवेंट-बेस्ड Lambdas का उपयोग एप्लिकेशन को स्केल करने में मदद करता है।
ये सर्वरलेस एप्लिकेशन में Lambda फंक्शन्स के कुछ उपयोग के मामले हैं। हमें सब कुछ सर्वरलेस बनाने की आवश्यकता नहीं है; हम ऊपर निर्दिष्ट उपयोग के मामलों के लिए एक हाइब्रिड मॉडल बना सकते हैं। यह एप्लिकेशन को स्केल करने और डेवलपर्स की उत्पादकता बढ़ाने में मदद करता है। सर्वरलेस तकनीक विकसित हो रही है और बेहतर हो रही है। अन्य सर्वरलेस तकनीकें हैं, जैसे AWS Fargate और Google CloudRun, जिनमें AWS Lambda की सीमाएं नहीं हैं।