वेरिएंस का विश्लेषण या ANOVA एक उपयोगी विश्लेषण है। 1918 में प्रक्रिया के विकास की शुरुआत से ही, इसका व्यापक रूप से उपयोग किया गया है। यह माध्य और विभिन्न समूहों के बीच सांख्यिकीय अंतर दिखाता है और यह निर्धारित करता है कि उनके मूल्य एक-दूसरे से कितना संबंधित हैं। एक नेस्टेड ANOVA वह है जहां ये समूह कई समूहों में विभाजित होते हैं जिनसे हम व्यक्तिगत रूप से संबंधित हो भी सकते हैं और नहीं भी। यह लेख नेस्टेड ANOVA के अवलोकन और एक्सेल में विश्लेषण कैसे करें, इस पर चर्चा करेगा।
आप नीचे दिए गए लिंक से प्रदर्शन के लिए उपयोग की गई वर्कबुक डाउनलोड कर सकते हैं।
ANOVA विश्लेषण क्या है?
ANOVA एक सांख्यिकीय विधि है जिसका उपयोग डेटासेट के भीतर देखे गए वेरिएंस का विश्लेषण करने के लिए किया जाता है। इसे करने के लिए, हमें डेटासेट को दो भागों में विभाजित करने की आवश्यकता होती है - व्यवस्थित और यादृच्छिक कारक।
ANOVA हमें यह निर्धारित करने देता है कि कौन से कारक दिए गए डेटा सेट को महत्वपूर्ण रूप से प्रभावित करते हैं। विश्लेषण पूरा करने के बाद, एक विश्लेषक आमतौर पर उन पद्धतिगत कारकों पर अतिरिक्त विश्लेषण करता है जो डेटा सेट की असंगत प्रकृति को महत्वपूर्ण रूप से प्रभावित करते हैं। उस स्थिति में, उसे अनुमानित रिग्रेशन विश्लेषण के लिए प्रासंगिक अतिरिक्त डेटा बनाने के लिए ANOVA निष्कर्षों का उपयोग करने की आवश्यकता होती है। ANOVA कई डेटा सेट की तुलना यह देखने के लिए करता है कि क्या उनके बीच कोई संबंध है।
ANOVA दो प्रकार के होते हैं, एक है सिंगल फैक्टर और दूसरा है टू फैक्टर। सिंगल फैक्टर में, ANOVA एक चर पर एक कारक के प्रभाव को ढूंढता है। दूसरी ओर, टू फैक्टर ANOVA में कई आश्रित चर होते हैं।
नेस्टेड ANOVA का अवलोकन
जैसा कि नाम से पता चलता है, एक नेस्टेड ANOVA में कम से कम एक कारक दूसरे के अंदर नेस्टेड होता है।
मान लीजिए एक विशिष्ट संगठन के दो स्टोर दो अलग-अलग स्थानों पर हैं। उदाहरण के लिए, पहले स्टोर में 2 टीमें हैं - टीम A और B, और दूसरे में टीम C और D। उनकी बिक्री उनकी संबंधित टीम के भीतर असाइन की गई होगी जो स्टोर के भीतर नेस्टेड होगी।
आलंकारिक रूप से, यह इस तरह होगा।
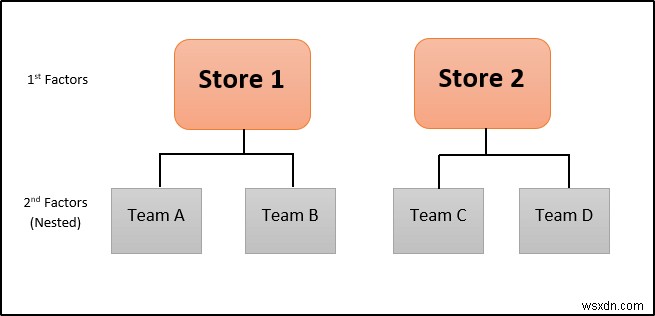
जैसा कि आप चित्र से देख सकते हैं, दूसरा कारक पहले कारक के अंदर नेस्टेड है। इसलिए, ऐसी बिक्री का ANOVA विश्लेषण नेस्टेड ANOVA श्रेणी में आएगा।
अब रीडिंग या डेटा एंट्री से डेटा अब स्प्रेडशीट पर इस तरह दिखेगा।
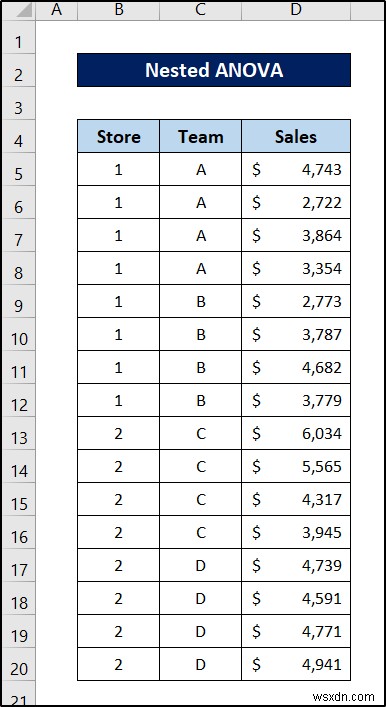
इस डेटा से, हम दो चीजों का विश्लेषण कर सकते हैं - क्या प्रत्येक स्टोर (फैक्टर 1) और प्रत्येक टीम (फैक्टर 2) में बिक्री समान है?
इस डेटा पर ANOVA करने पर (बाद के अनुभाग में इस पर अधिक), हमें ऐसा कुछ मिलेगा।
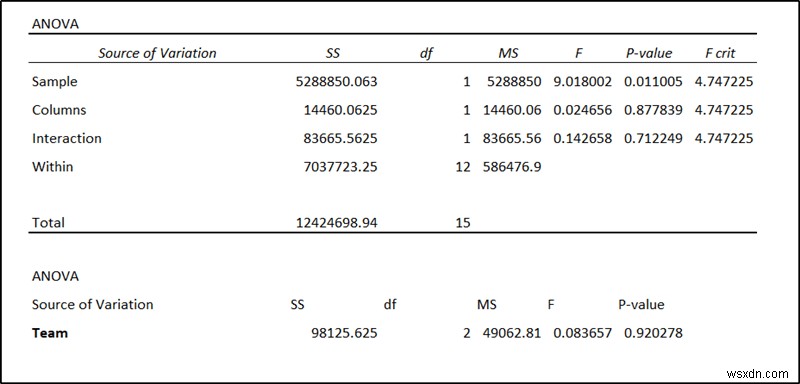
यहां P-मान प्रत्येक कारक के महत्व का न्याय करेंगे। इस डेटा से, हम देख सकते हैं कि स्टोर का सांख्यिकीय रूप से महत्वपूर्ण प्रभाव है जबकि उनमें टीमों का नहीं है।
इन गणनाओं और व्याख्याओं के बारे में अगले अनुभाग में अधिक जानकारी।
एक्सेल में नेस्टेड ANOVA कैसे करें
एक्सेल में नेस्टेड ANOVA करने का कोई सीधा तरीका नहीं है। लेकिन हम डेटासेट को संशोधित करके और कुछ मैन्युअल गणनाएं करके अभी भी ऑपरेशन कर सकते हैं। हम यहां डेटा एनालिसिस टूलपैक के टू फैक्टर विद रिप्लिकेशन फीचर का उपयोग करेंगे। ध्यान रखें, आपके रिबन में डिफ़ॉल्ट रूप से डेटा एनालिसिस टूलपैक नहीं हो सकता है। डेटा एनालिसिस टूलपैक कैसे सक्षम करें देखने के लिए यहां क्लिक करें। अंत में, हमें मैन्युअल गणना के लिए F.DIST.RT फंक्शन की आवश्यकता होगी।
लेकिन पहले, हमें मूल रॉ डेटासेट में कुछ संशोधन करने होंगे। क्योंकि हम इस पर टू फैक्टर विद रिप्लिकेशन करेंगे। पिछले अनुभाग से रॉ डेटासेट लेते हैं।
अब एक्सेल में नेस्टेड ANOVA करने के चरण देखने के लिए इन चरणों का पालन करें।
चरण:
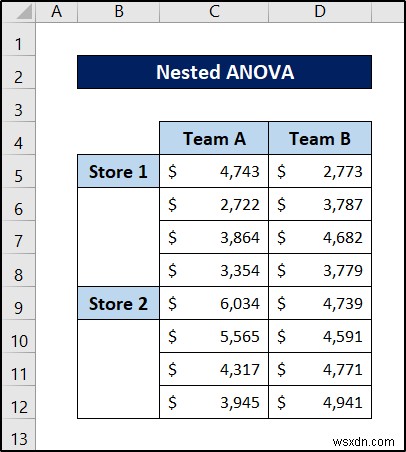
- सबसे पहले, डेटासेट को निम्नलिखित में पुनर्व्यवस्थित करें। हमने टीम C और D के बिक्री मूल्यों को A और B के अंतर्गत शामिल किया ताकि एक्सेल उन्हें पढ़ सके।
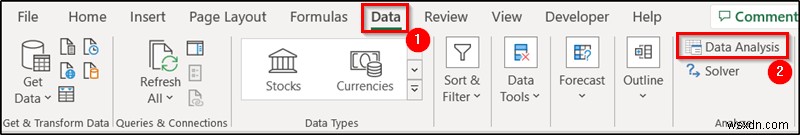
- अब अपने रिबन पर डेटा टैब पर जाएं।
- फिर एनालाइज़ समूह अनुभाग से डेटा एनालिसिस चुनें।
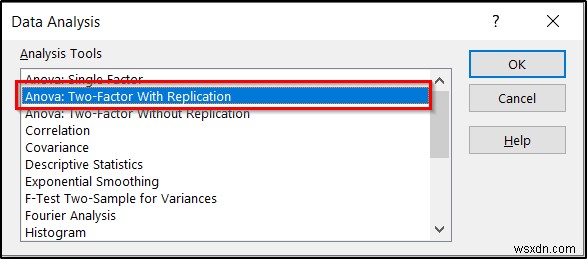
- डेटा एनालिसिस बॉक्स दिखाई देगा।
- अब एनालिसिस टूल्स के तहत Anova: Two-Factor with Replication चुनें।
- फिर OK पर क्लिक करें।
- अगला, Anova:Two-Factor With Replication बॉक्स दिखाई देगा। बॉक्स में निम्नलिखित विवरण चुनें।
- पहला, इनपुट रेंज के रूप में रेंज B4:D12 दर्ज करें।
- दूसरा, रोज़ पर सैंपल फ़ील्ड में 4 डालें, क्योंकि हमारे पास प्रत्येक नेस्टेड फैक्टर के लिए चार एंट्री हैं।
- आप अल्फा मान भी बदल सकते हैं यदि आप चाहें। लेकिन हम इसे अभी 0.05 पर रखेंगे।
- तीसरा, आप आउटपुट विकल्प के तहत जहां चाहें अपने परिणाम प्रदर्शित करने के लिए चुन सकते हैं।
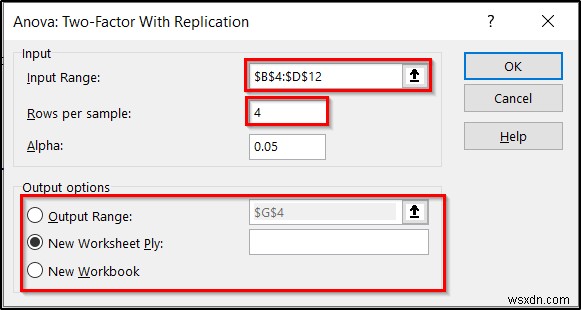
- जब आप इन सभी के साथ हो जाएं, तो OK पर क्लिक करें।
- परिणामस्वरूप, आपके द्वारा चुने गए स्थान पर परिणाम सामने आएगा। हम नेस्टेड ANOVA विश्लेषण के लिए ANOVA के अंतिम भाग का उपयोग करेंगे।
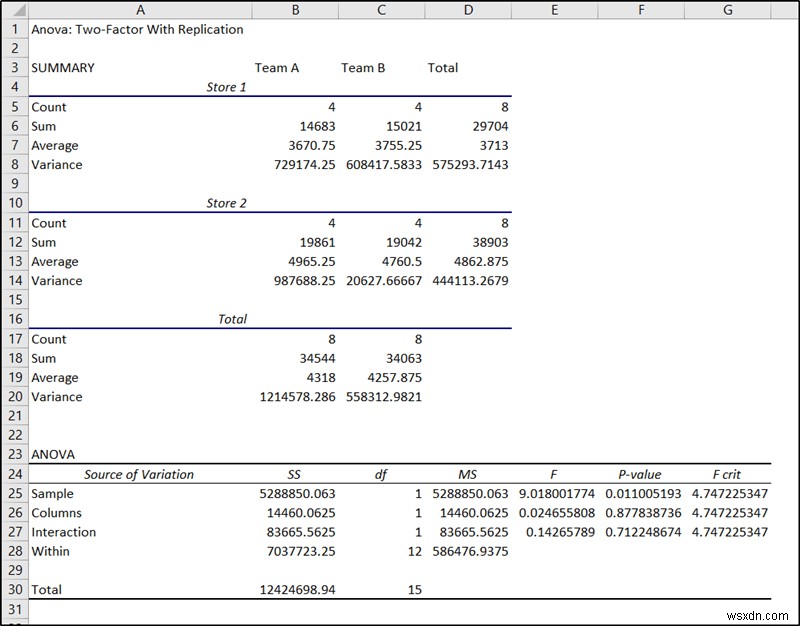
- सेल F25 में सैंपल का P-मान सैंपल के महत्व को दर्शाता है जो इस मामले में पहला कारक, स्टोर है।
- अन्य कारकों के महत्व के लिए, अब हमें कुछ मैन्युअल गणनाएं करने की आवश्यकता है।
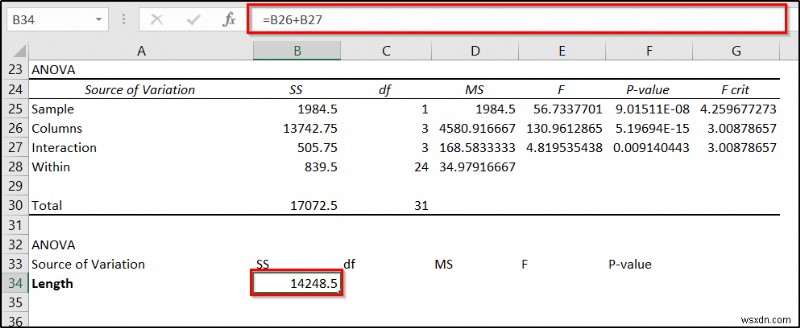
- सबसे पहले, सेल B34 चुनें और निम्न सूत्र लिखें।
=B26+B27
- फिर एंटर दबाएं।
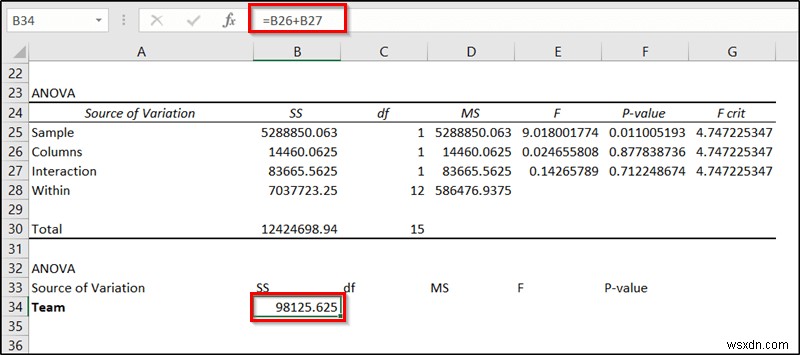
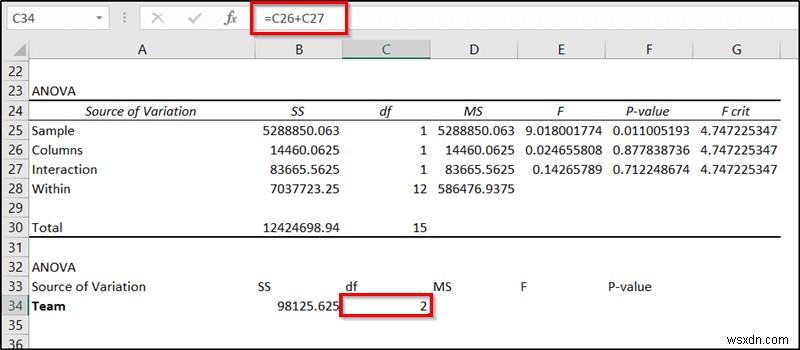
- अब सेल C34 में निम्न सूत्र डालें और एंटर दबाएं।
=C26+C27
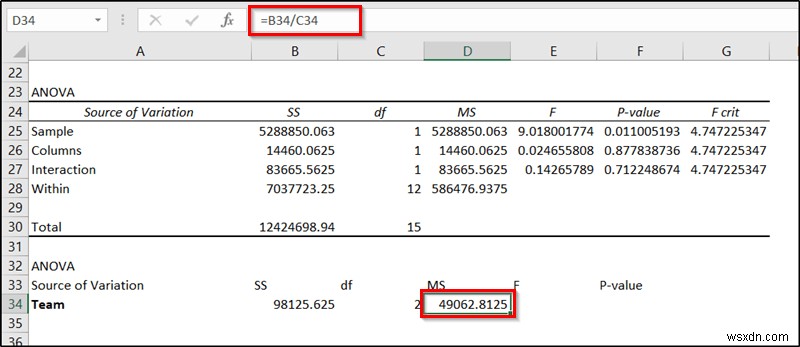
- अगला, सेल D34 में निम्न सूत्र डालें और एंटर दबाएं।
=B34/C34
- उसके बाद, सेल E34 में निम्न सूत्र का उपयोग करें।
=D34/D28
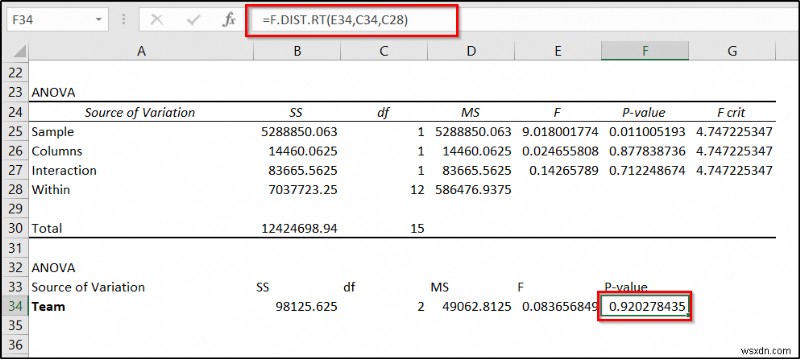
- अंत में, सेल F34 में निम्न सूत्र का उपयोग करें और फिर एंटर दबाएं।
=F.DIST.RT(E34,C34,C28)
परिणाम की व्याख्या
यदि ANOVA विश्लेषण से किसी कारक का P-मान 0.05 से कम होता है तो उसका डेटा पर महत्वपूर्ण प्रभाव पड़ता है। इस उदाहरण में, हमारे पास दो कारक थे - स्टोर और टीमें, जहां टीमें स्टोर के अंदर नेस्टेड थीं। इस डेटा के लिए स्टोर का P-मान सेल F25 में है और टीमों का P-मान सेल F34 में है।
जैसा कि आप परिणाम से देख सकते हैं, स्टोर का P-मान 0.011005 है जो 0.05 से कम है। यह इस कारक की बिक्री पर महत्वपूर्ण प्रभाव को दर्शाता है। जबकि टीम फैक्टर का P-मान 0.9202 है जो 0.05 से अधिक है। जो डेटा या बिक्री पर महत्वपूर्ण प्रभाव नहीं दर्शाता। इसलिए हम सुरक्षित रूप से निष्कर्ष निकाल सकते हैं कि इस मामले में स्टोर स्थान टीमों में कर्मचारियों के संयोजन से अधिक महत्वपूर्ण है।
इस तरह हम एक्सेल में नेस्टेड ANOVA कर सकते हैं।
एक्सेल में नेस्टेड ANOVA के 2 उपयुक्त उदाहरण
एक्सेल में नेस्टेड ANOVA करने का सामान्य विचार समान है। अब हम इसे दो अलग-अलग उदाहरणों में लागू करेंगे ताकि विभिन्न मामलों में इसके उपयोग को प्रदर्शित किया जा सके। ध्यान रखें कि, हमें रिबन में डेटा एनालिसिस टूलपैक उपलब्ध होना चाहिए। यदि आपके पास नहीं है, तो डेटा एनालिसिस टूलपैक कैसे सक्षम करें देखने के लिए यहां क्लिक करें।
1. विभिन्न लंबाईयों के साथ प्रतिरोध के वेरिएंस की गणना
इस पहले उदाहरण में, हम निम्नलिखित डेटासेट का उपयोग करेंगे।
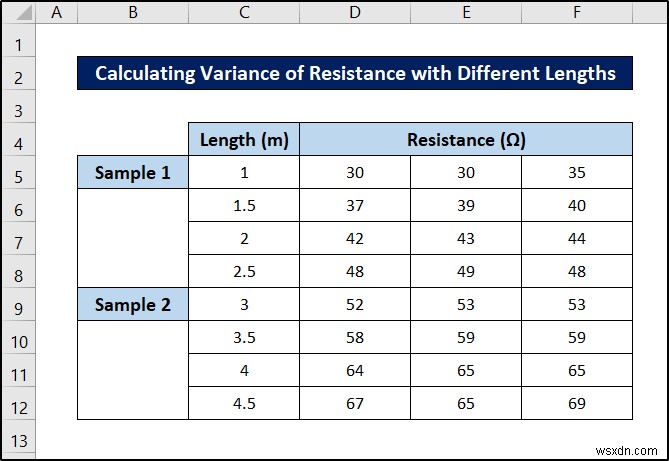
आप कह सकते हैं कि यहां दो नेस्ट हैं - प्रतिरोध मूल्य लंबाई के अंदर नेस्टेड हैं, जो बदले में विभिन्न सैंपल के अंदर नेस्टेड हैं।
लेकिन मूल विचार डेटासेट के लिए टू-फैक्टर विद रिप्लिकेशन का उपयोग करना है। इसलिए हमें डेटासेट को इस तरह चाहिए। और पहले की तरह, अंत में मैन्युअल गणना के लिए हमें F.DIST.RT फंक्शन की आवश्यकता होगी। एक्सेल में इस नेस्टेड डेटासेट पर ANOVA कैसे करें, यह देखने के लिए चरणों का पालन करें।
चरण:
- सबसे पहले, अपने रिबन पर डेटा टैब पर जाएं।
- फिर एनालाइज़ समूह अनुभाग से डेटा एनालिसिस चुनें।
- डेटा एनालिसिस बॉक्स दिखाई देगा।
- अब एनालिसिस टूल्स के तहत Anova: Two-Factor with Replication चुनें।
- फिर OK पर क्लिक करें।
- अगला, Anova:Two-Factor With Replication बॉक्स दिखाई देगा। बॉक्स में निम्नलिखित विवरण चुनें।
- पहला, इनपुट रेंज के रूप में रेंज B4:F12 दर्ज करें।
- दूसरा, रोज़ पर सैंपल फ़ील्ड में 4 डालें, क्योंकि हमारे पास प्रत्येक नेस्टेड फैक्टर के लिए चार एंट्री हैं।
- आप अल्फा मान भी बदल सकते हैं यदि आप चाहें। लेकिन हम इसे अभी 0.05 पर रखेंगे।
- तीसरा, आप आउटपुट विकल्प के तहत जहां चाहें अपने परिणाम प्रदर्शित करने के लिए चुन सकते हैं।
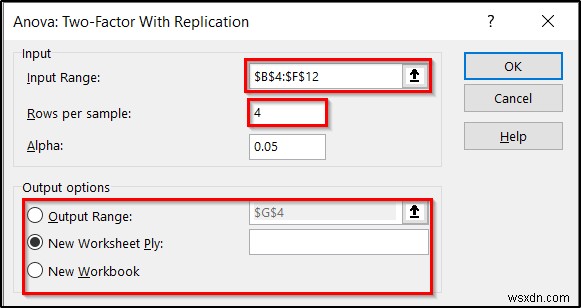
- जब आप इन सभी के साथ हो जाएं, तो OK पर क्लिक करें।
- परिणामस्वरूप, आपके द्वारा चुने गए स्थान पर परिणाम सामने आएगा। हम नेस्टेड ANOVA विश्लेषण के लिए ANOVA के अंतिम भाग का उपयोग करेंगे।
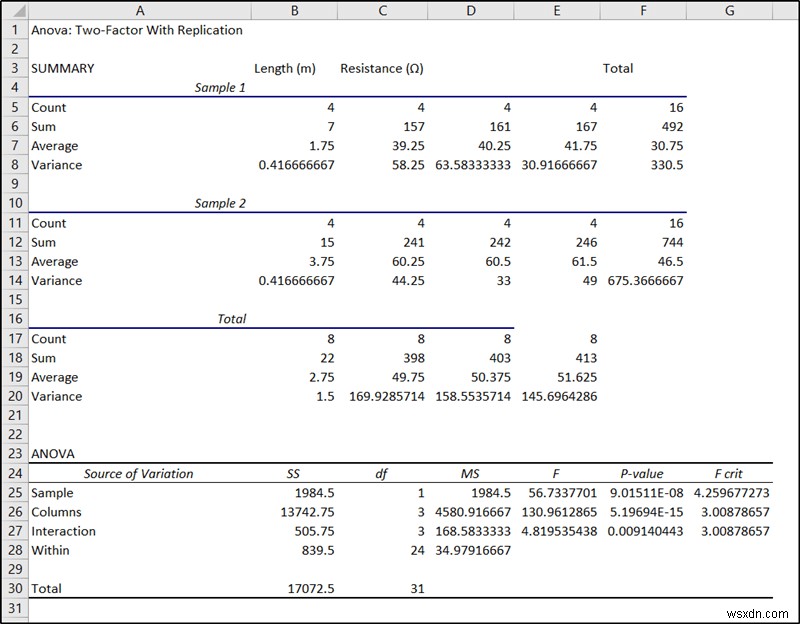
- सेल F25 में सैंपल का P-मान सैंपल के महत्व को दर्शाता है जो इस मामले में पहला कारक, सैंपल है।
- अब सेल B34 चुनें और निम्न सूत्र लिखें।
=B26+B27
- फिर एंटर दबाएं।
- अब सेल C34 में निम्न सूत्र डालें और एंटर दबाएं।
=C26+C27
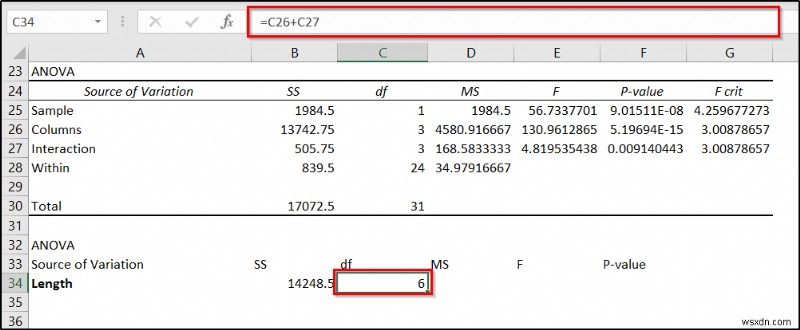
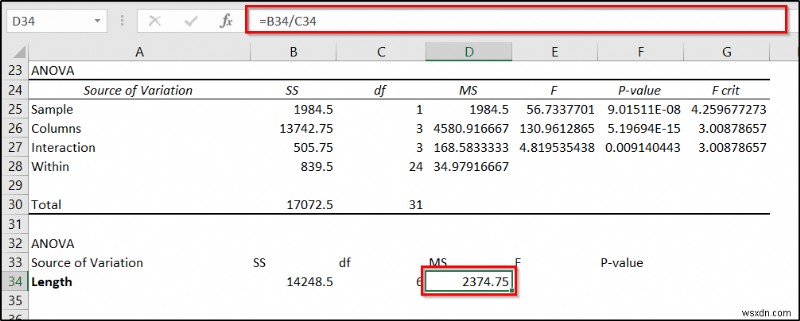
- अगला, सेल D34 में निम्न सूत्र डालें और एंटर दबाएं।
=B34/C34
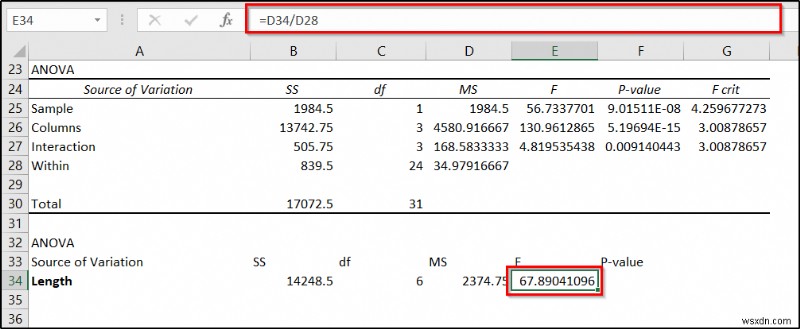
- उसके बाद, सेल E34 में निम्न सूत्र का उपयोग करें।
=D34/D28
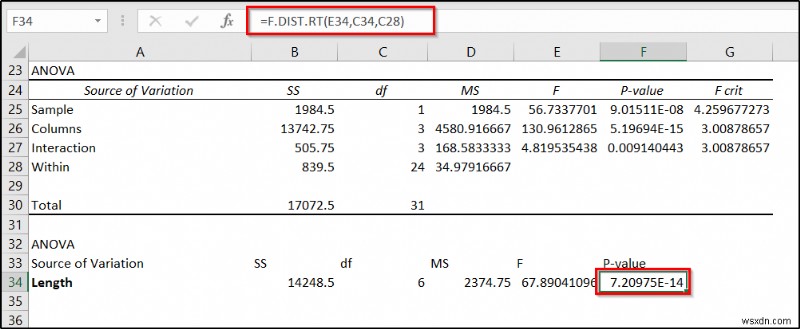
- अंत में, सेल F34 में निम्न सूत्र का उपयोग करें और फिर एंटर दबाएं।
=F.DIST.RT(E34,C34,C28)
परिणाम की व्याख्या
अंतिम परिणाम में, सेल F25 में P-मान सैंपल (विभिन्न लंबाईयों के) के महत्व को दर्शाता है और सेल F34 का मान प्रतिरोध पर लंबाई के महत्व को दर्शाता है। चूंकि दोनों अल्फा मान 0.05 से नीचे हैं, इसलिए इस उदाहरण में दोनों महत्वपूर्ण कारक हैं।
और पढ़ें: एक्सेल में ANOVA परिणामों की व्याख्या कैसे करें (3 तरीके)
समान पठन
- एक्सेल में रिग्रेशन कैसे करें और ANOVA की व्याख्या
- एक्सेल में वन वे ANOVA करें (2 उपयुक्त उदाहरण)
- एक्सेल में ANOVA परिणामों को ग्राफ कैसे करें (3 उपयुक्त उदाहरण)
- एक्सेल में रिपीटेड मेजर्स ANOVA कैसे करें (आसान चरणों के साथ)
2. विभिन्न अनुभागों से अंकों के वेरिएंस का विश्लेषण
इस दूसरे उदाहरण में, हम निम्नलिखित डेटासेट का उपयोग करेंगे।
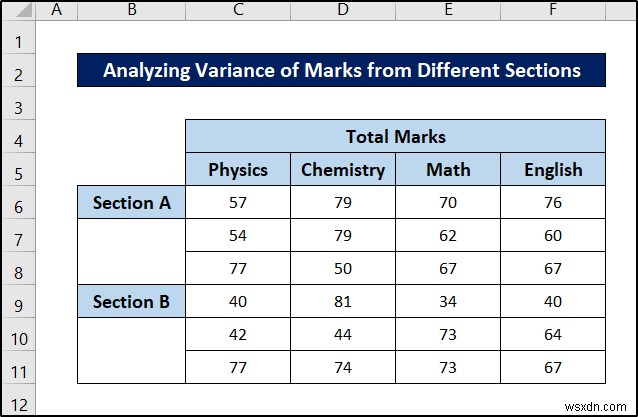
फिर से, यह टू-वे ANOVA के लिए डेटासेट जैसा दिख सकता है। लेकिन यह एक्सेल में विश्लेषण करने के लिए पुनर्व्यवस्थित नेस्टेड ANOVA है। और पहले की तरह, अंत में मैन्युअल गणना के लिए हमें F.DIST.RT फंक्शन की आवश्यकता होगी।
एक्सेल में इस नेस्टेड ANOVA को कैसे करें, यह देखने के लिए इन चरणों का पालन करें।
चरण:
- सबसे पहले, अपने रिबन पर डेटा टैब पर जाएं।
- फिर एनालाइज़ समूह अनुभाग से डेटा एनालिसिस चुनें।
- डेटा एनालिसिस बॉक्स दिखाई देगा।
- अब एनालिसिस टूल्स के तहत Anova: Two-Factor with Replication चुनें।
- फिर OK पर क्लिक करें।
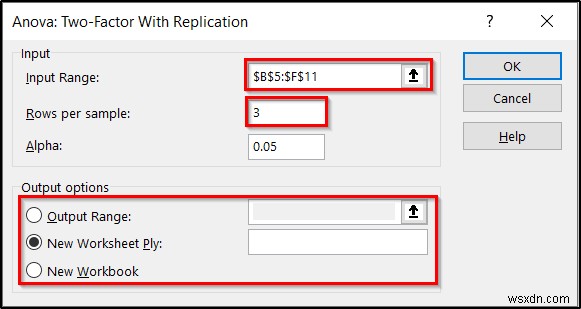
- अगला, Anova:Two-Factor With Replication बॉक्स दिखाई देगा। बॉक्स में निम्नलिखित विवरण चुनें।
- पहला, इनपुट रेंज के रूप में रेंज B5:F11 दर्ज करें।
- दूसरा, रोज़ पर सैंपल फ़ील्ड में 3 डालें, क्योंकि हमारे पास प्रत्येक नेस्टेड फैक्टर के लिए तीन एंट्री हैं।
- आप अल्फा मान भी बदल सकते हैं यदि आप चाहें। लेकिन हम इसे अभी 0.05 पर रखेंगे।
- तीसरा, आप आउटपुट विकल्प के तहत जहां चाहें अपने परिणाम प्रदर्शित करने के लिए चुन सकते हैं।
- जब आप इन सभी के साथ हो जाएं, तो OK पर क्लिक करें।
- परिणामस्वरूप, आपके द्वारा चुने गए स्थान पर परिणाम सामने आएगा। हम नेस्टेड ANOVA विश्लेषण के लिए ANOVA के अंतिम भाग का उपयोग करेंगे।
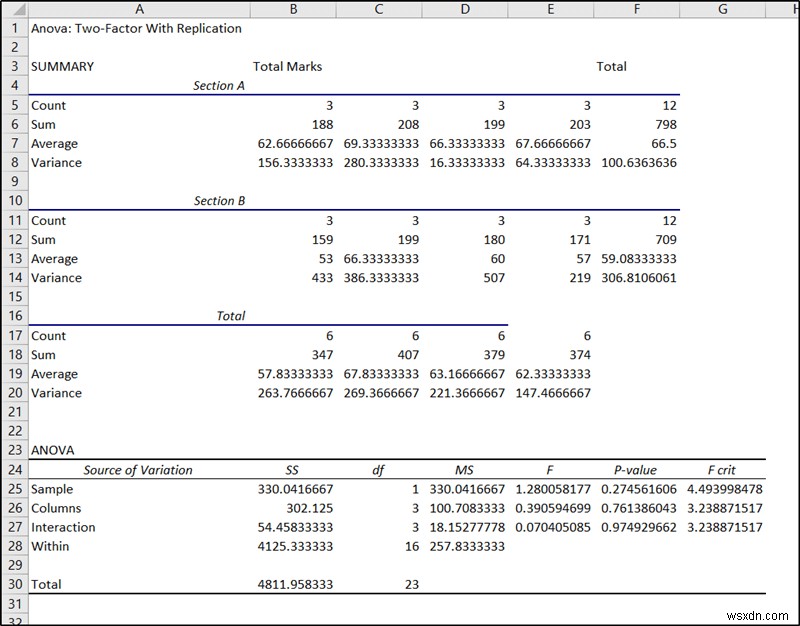
- सेल F25 में सैंपल का P-मान सैंपल के महत्व को दर्शाता है जो इस मामले में पहला कारक, सेक्शन है।
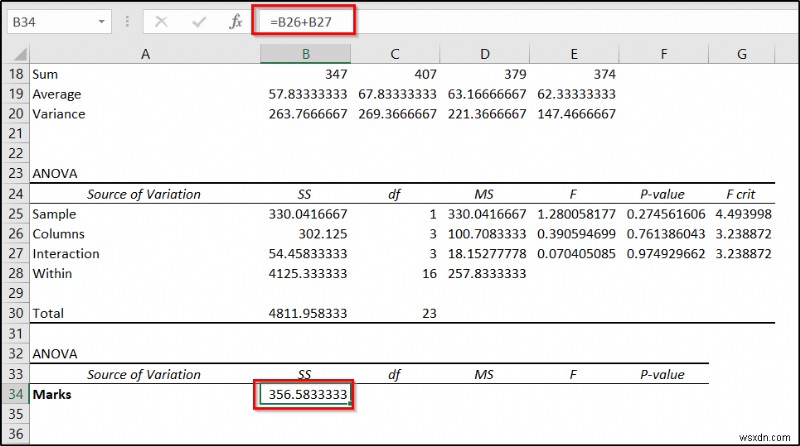
- अब सेल B34 चुनें और निम्न सूत्र लिखें।
=B26+B27
- फिर एंटर दबाएं।
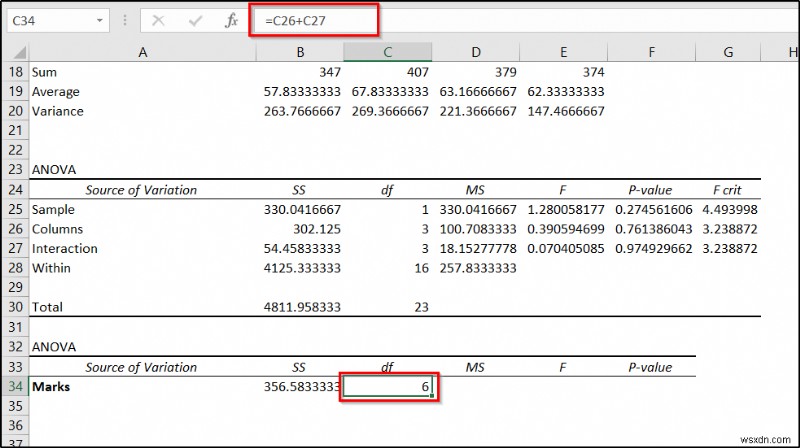
- अब सेल C34 में निम्न सूत्र डालें और एंटर दबाएं।
=C26+C27
- अगला, सेल D34 में निम्न सूत्र डालें और एंटर दबाएं।
=B34/C34
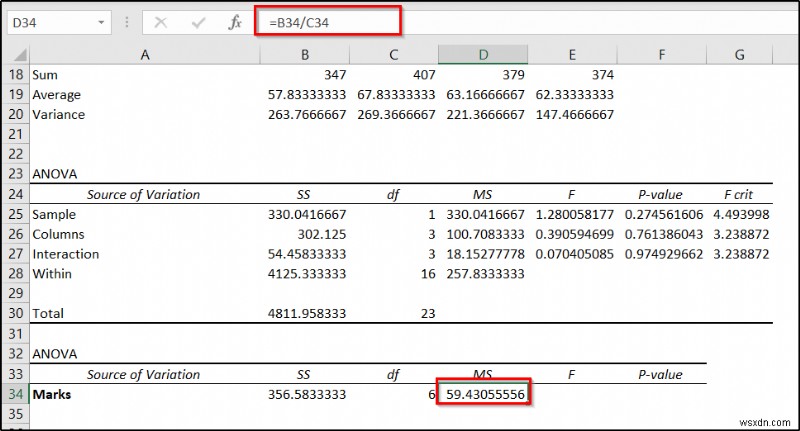
- उसके बाद, सेल E34 में निम्न सूत्र का उपयोग करें।
=D34/D28
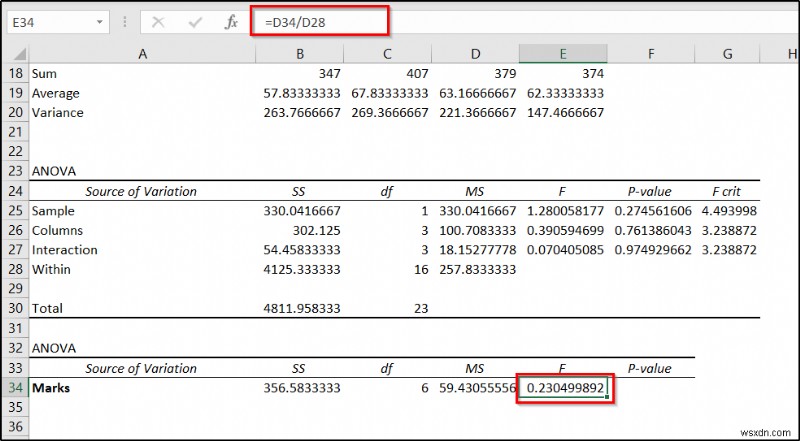
- अंत में, सेल F34 में निम्न सूत्र का उपयोग करें और फिर एंटर दबाएं।
=F.DIST.RT(E34,C34,C28)
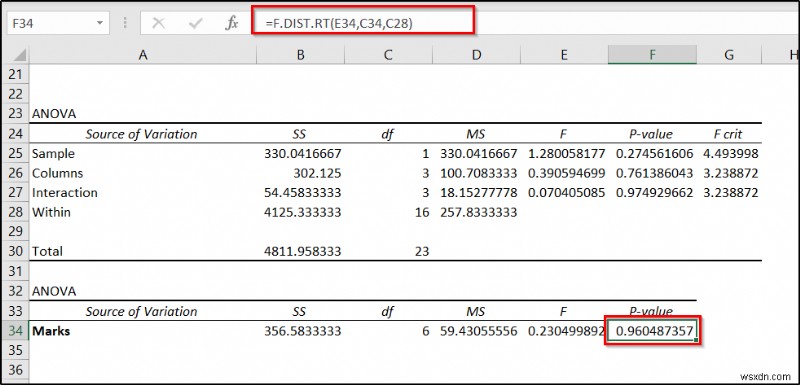
परिणाम की व्याख्या
सेल F25 में P-मान आंकड़ों पर सेक्शन के महत्व को दर्शाता है। यह मान 0.05 के अल्फा मान से अधिक है। इसलिए इसका ज्यादा महत्व नहीं है। सेल F34 का मान डेटासेट में विषय अंकों का P-मान है। यह भी 0.05 से अधिक है। इसलिए, इस डेटासेट के लिए विभिन्न अनुभागों में विभिन्न विषयों पर अंकों पर इसका कोई महत्वपूर्ण प्रभाव नहीं है।
यह एक्सेल में नेस्टेड ANOVA करने का एक और उदाहरण है।
और पढ़ें: एक्सेल ANOVA में P मान की गणना कैसे करें (3 उपयुक्त उदाहरण)
नेस्टेड ANOVA के बारे में याद रखने योग्य बातें
- एक नेस्टेड ANOVA में दो से अधिक कारक हो सकते हैं। जैसे पिछले अनुभाग के पहले उदाहरण में उपयोग किया गया, एक कारक एक कारक में नेस्टेड हो सकता है। वह कारक उसी स्तर के अन्य कारकों के साथ पदानुक्रम में दूसरे कारक में भी नेस्टेड हो सकता है।
- एक नेस्टेड ANOVA टू-वे ANOVA से अलग है। एक टू-फैक्टर ANOVA में दो कारक होते हैं। इस बीच, एक नेस्टेड ANOVA में उन कारकों में से एक दूसरे के अंदर नेस्टेड होना चाहिए। जो टू-वे ANOVA के लिए मामला नहीं है।
निष्कर्ष
तो यह एक्सेल में नेस्टेड ANOVA करने की विधि थी। उम्मीद है, आपने टू-वे रिप्लिकेशन फीचर का उपयोग करके एक्सेल में नेस्टेड ANOVA की अवधारणा को समझ लिया है और इसे अपने डेटासेट के लिए तदनुसार उपयोग कर सकते हैं। मुझे आशा है कि आपको यह मार्गदर्शिका उपयोगी और जानकारीपूर्ण लगी। यदि आपके कोई प्रश्न या सुझाव हैं, तो नीचे कमेंट में हमें बताएं।
ऐसी और गाइड के लिए, Exceldemy.com पर जाएं।
संबंधित लेख
- एक्सेल में रोज़-पर-सैंपल ANOVA कैसे लागू करें (2 आसान विधियाँ)
- एक्सेल में ANOVA टेबल कैसे बनाएं (3 उपयुक्त तरीके)
- रैंडमाइज़्ड ब्लॉक डिज़ाइन ANOVA एक्सेल में (आसान चरणों के साथ)
- एक्सेल में ANOVA टू फैक्टर विदाउट रिप्लिकेशन का उपयोग कैसे करें