समय के अनुसार डेटाफ्रेम फ़िल्टर करने के लिए, loc का उपयोग करें और रिकॉर्ड लाने के लिए इसमें शर्त सेट करें। सबसे पहले, आवश्यक लाइब्रेरी आयात करें:
import pandas as pd
तारीख रिकॉर्ड के साथ सूचियों का एक डिक्शनरी बनाएं:
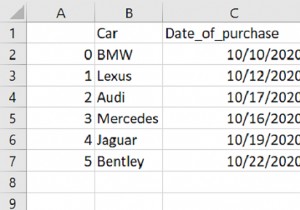
d = {'Car': ['BMW', 'Lexus', 'Audi', 'Mercedes', 'Jaguar', 'Bentley'],
     'Date_of_Purchase': ['2021-07-10', '2021-08-12', '2021-06-17', '2021-03-16', '2021-05-19', '2021-08-22']}
उपरोक्त सूचियों के डिक्शनरी से डेटाफ्रेम बनाएं:
dataFrame = pd.DataFrame(d)
अब, मान लें कि हमें किसी विशिष्ट तारीख के बाद खरीदी गई कारें लानी हैं। इसके लिए, हम loc का उपयोग करते हैं:
resDF = dataFrame.loc[dataFrame["Date_of_Purchase"] > "2021-07-15"]
उदाहरण
निम्नलिखित पूर्ण कोड है:
import pandas as pd
# dictionary of lists
d = {'Car': ['BMW', 'Lexus', 'Audi', 'Mercedes', 'Jaguar', 'Bentley'],
     'Date_of_Purchase': ['2021-07-10', '2021-08-12', '2021-06-17', '2021-03-16', '2021-05-19', '2021-08-22']}
# creating dataframe from the above dictionary of lists
dataFrame = pd.DataFrame(d)
print("DataFrame...\n", dataFrame)
# fetch cars purchased after 15th July 2021
resDF = dataFrame.loc[dataFrame["Date_of_Purchase"] > "2021-07-15"]
# print filtered data frame
print("\nCars purchased after 15th July 2021: \n", resDF)
आउटपुट
यह निम्नलिखित आउटपुट देगा:
DataFrame...
    Car Date_of_Purchase
0  BMW  2021-07-10
1  Lexus 2021-08-12
2  Audi  2021-06-17
3  Mercedes 2021-03-16
4  Jaguar 2021-05-19
5  Bentley 2021-08-22
Cars purchased after 15th July 2021:
    Car Date_of_Purchase
1  Lexus 2021-08-12
5  Bentley 2021-08-22