Excel डेटा विश्लेषण के लिए सबसे शक्तिशाली टूल में से एक है, लेकिन इसकी सीमाएँ हैं। जब डेटासेट लाखों पंक्तियों में बढ़ जाते हैं, जब रिपोर्ट को स्वचालित रूप से चलाने की आवश्यकता होती है, या जब विश्लेषण के लिए मशीन लर्निंग की आवश्यकता होती है, तो अकेले Excel अपनी उम्र दिखाने लगता है। Python इन कई अंतरालों को भरता है। Python एकीकरण ने Excel को एक पारंपरिक स्प्रेडशीट टूल से एक अधिक शक्तिशाली डेटा विश्लेषण प्लेटफॉर्म में बदल दिया है। Excel के अंदर सीधे Python उपलब्ध होने से, विश्लेषक अब अपनी वर्कबुक छोड़े बिना उन्नत गणना कर सकते हैं, भविष्यवाणी मॉडल बना सकते हैं, और परिष्कृत विज़ुअलाइज़ेशन उत्पन्न कर सकते हैं।
इस ट्यूटोरियल में, हम उन्नत Excel डेटा विश्लेषण के लिए पाँच Python लाइब्रेरी दिखाएंगे जिन्हें हर प्रो को उपयोग करना चाहिए। ये लाइब्रेरी आपको Excel के भीतर सीधे उन्नत डेटा मैनिपुलेशन, विज़ुअलाइज़ेशन और मशीन लर्निंग करने की अनुमति देती हैं।
1. Pandas – डेटा मैनिपुलेशन और विश्लेषण का मूल
यदि आप Excel विश्लेषण के लिए केवल एक Python लाइब्रेरी सीखते हैं, तो पहले Pandas सीखें। Pandas Python में लगभग हर उन्नत Excel-संबंधित कार्य की नींव है। यह Excel डेटा को शक्तिशाली DataFrames में बदल देता है ताकि बड़े डेटासेट को कुशलतापूर्वक साफ, परिवर्तित, फ़िल्टर, ग्रुप, मर्ज, एग्रीगेट और एक्सप्लोर किया जा सके।
Excel प्रो के लिए मुख्य ताकत:
- pd.read_excel() और df.to_excel() के साथ Excel फ़ाइलों को मूल रूप से पढ़ें और लिखें
- गन्दे डेटा को संभालें: डुप्लिकेट हटाएं, लापता मान भरें, और फॉर्मेट मानकीकृत करें
- PivotTables से आगे की तर्क के साथ उन्नत ग्रुपिंग और एग्रीगेशन करें
- कई शीट्स या फ़ाइलों को मर्ज या जॉइन करें
- df.describe() के साथ सांख्यिकीय सारांश उत्पन्न करें
- कुछ लाइनों का कोड चलाएँ और हर बार वही परिणाम प्राप्त करें
उदाहरण: गन्दे डेटा की सफाई
Excel में एक आम समस्या है मिश्रित प्रकार, लापता मान और असंगत फॉर्मेटिंग के साथ डेटा प्राप्त करना। Pandas के साथ, आप सब कुछ एक दोहराने योग्य स्क्रिप्ट में ठीक कर सकते हैं।
Python in Excel:
import pandas as pd df = xl("A1:J10000", headers=True) # साफ करें: स्पेस हटाएं, प्रकार बदलें, लापता भरें df['Category'] = df['Category'].str.strip() df['Revenue'] = df['Units'] * df['UnitPrice'].fillna(0) # उन्नत सारांश: क्षेत्र और श्रेणी के अनुसार ग्रुप करें summary = df.groupby(['Region', 'Category']).agg({ 'Revenue': 'sum', 'Units': 'sum' }).reset_index() summary 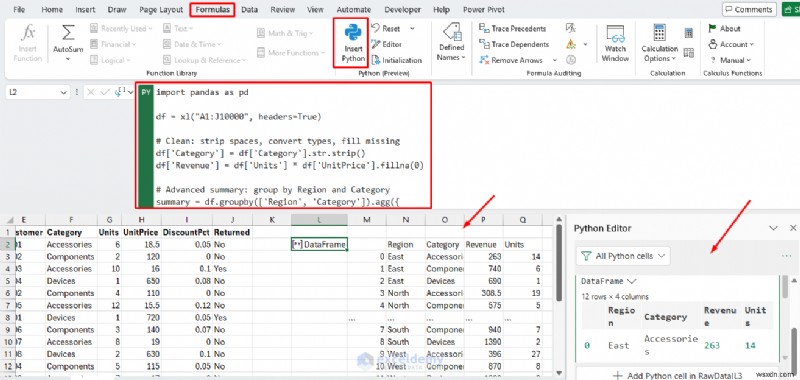
Python in VS Code:
import pandas as pd file_path = 'SalesData.xlsx' df = pd.read_excel(file_path, sheet_name='RawData') # कॉलम प्रकार ठीक करें — टेक्स्ट के रूप में संग्रहीत संख्याओं को संभालता है df['Units'] = pd.to_numeric(df['Units'], errors='coerce').fillna(0).astype(int) df['UnitPrice'] = pd.to_numeric(df['UnitPrice'], errors='coerce').fillna(0.0) df['DiscountPct'] = pd.to_numeric(df['DiscountPct'], errors='coerce').fillna(0.0) # बूलियन-जैसे टेक्स्ट कॉलम मानकीकृत करें df['Returned'] = df['Returned'].astype(str).str.strip().str.lower() \ .map({'yes': True, 'no': False}).fillna(False) # गणना कॉलम जोड़ें df['Revenue'] = df['Units'] * df['UnitPrice'] df['NetRevenue'] = df['Revenue'] * (1 - df['DiscountPct']) # नई शीट के रूप में वापस लिखें — मूल डेटा अछूता with pd.ExcelWriter(file_path, engine='openpyxl', mode='a', if_sheet_exists='replace') as writer: df.to_excel(writer, sheet_name='CleanData', index=False) print('CleanData sheet created in', file_path) 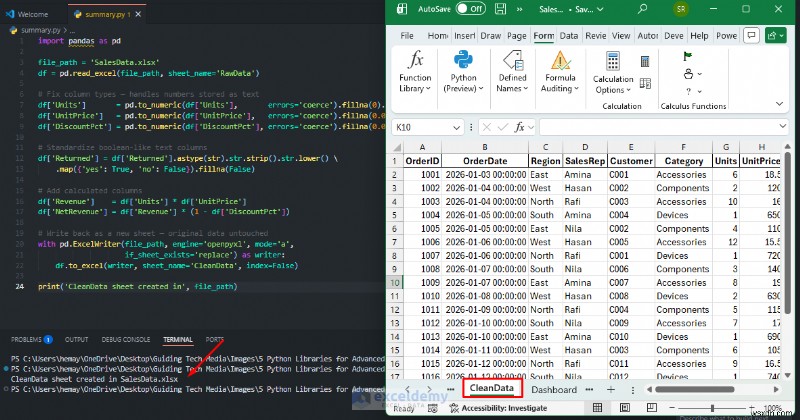
सारांश रिपोर्ट स्वचालित करना
मैन्युअल PivotTables को Pandas groupby वर्कफ़्लो से बदलें जो सेकंड में चलता है और हर बार आपके डेटा अपडेट होने पर साझा करने के लिए तैयार शीट निर्यात करता है:
summary = ( df.groupby(['Region', 'Category'], as_index=False) .agg( Orders = ('OrderID', 'count'), Units = ('Units', 'sum'), NetRevenue = ('NetRevenue', 'sum'), Returns = ('Returned', 'sum') ) ) with pd.ExcelWriter(file_path, engine='openpyxl', mode='a', if_sheet_exists='replace') as writer: summary.to_excel(writer, sheet_name='Summary', index=False) 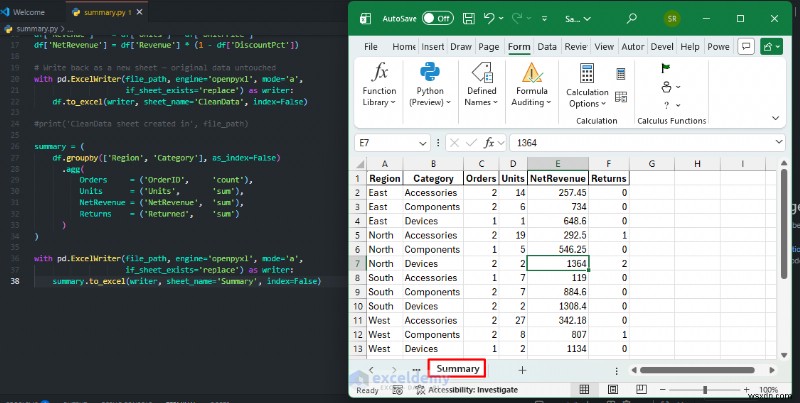
कब उपयोग करें: आपको PivotTable-शैली का आउटपुट मिलता है, लेकिन सफाई और तर्क उसी वर्कफ़्लो में होते हैं। इसका मतलब है कम टूटी रिपोर्ट और कम मैन्युअल हस्तक्षेप। पावर यूज़र Pandas पर भरोसा करते हैं उन डेटासेट को संभालने के लिए जो देशी Excel के लिए बहुत बड़े या बहुत जटिल हैं, खासकर जब डेटासेट कुछ हज़ार पंक्तियों से अधिक हो, जब आपको सफाई या सारांश चरण दोहराने की आवश्यकता हो, या जब आपको कई स्रोतों से डेटा को स्वचालित रूप से मर्ज करने की आवश्यकता हो।
2. OpenPyXL – उन्नत Excel फ़ाइल मैनिपुलेशन और मूल फॉर्मेटिंग
जबकि Pandas डेटा को संभालता है, OpenPyXL .xlsx फ़ाइलों पर बारीक नियंत्रण में उत्कृष्ट है: सेल्स फॉर्मेट करना, चार्ट, टेबल, स्टाइल, फ़ॉर्मूला और इमेज जोड़ना बिना Excel-मूल सुविधाओं को खोए। यह आपको सीधे .xlsx फ़ाइलों के साथ काम करने देता है, ताकि आपका Python वर्कफ़्लो कच्चे विश्लेषण के बजाय Excel-तैयार आउटपुट उत्पन्न कर सके।
Excel प्रो के लिए मुख्य ताकत:
- प्रोग्रामेटिक रूप से वर्कबुक बनाएँ और संशोधित करें
- साफ टेबल को नई शीट्स में निर्यात करें
- पेशेवर चार्ट सीधे Excel फॉर्मेट में जोड़ें जो स्वचालित रूप से अपडेट होते हैं
- पुरानी रिपोर्ट टैब को स्वचालित रूप से बदलें
- विशिष्ट सेल्स पर सशर्त फॉर्मेटिंग, बॉर्डर, फ़ॉन्ट और स्टाइल लागू करें
- =SUM() या =VLOOKUP() जैसे Excel फ़ॉर्मूला को सेल्स में इंजेक्ट करें
- शीट्स को सुरक्षित करें, पेन फ्रीज़ करें, और प्रोग्रामेटिक रूप से कॉलम चौड़ाई सेट करें
- गैर-Python उपयोगकर्ताओं के लिए वर्कबुक-आधारित डिलिवरेबल्स बनाएँ
उदाहरण: अपनी वर्कबुक में मूल चार्ट जोड़ना
Pandas के साथ साफ डेटा उत्पन्न करने के बाद, Excel को मैन्युअल रूप से खोले बिना openpyxl का उपयोग करके एक पेशेवर बार चार्ट जोड़ें।
from openpyxl import load_workbook from openpyxl.chart import BarChart, Reference import pandas as pd file_path = 'SalesData.xlsx' df = pd.read_excel(file_path, sheet_name='CleanData') chart_data = df.groupby('Region', as_index=False)['NetRevenue'] \ .sum().sort_values('NetRevenue', ascending=False) with pd.ExcelWriter(file_path, engine='openpyxl', mode='a', if_sheet_exists='replace') as writer: chart_data.to_excel(writer, sheet_name='RegionChart', index=False) wb = load_workbook(file_path) ws = wb['RegionChart'] chart = BarChart() chart.title = 'Net Revenue by Region' chart.y_axis.title = 'Net Revenue ($)' chart.x_axis.title = 'Region' values = Reference(ws, min_col=2, min_row=1, max_row=ws.max_row) labels = Reference(ws, min_col=1, min_row=2, max_row=ws.max_row) chart.add_data(values, titles_from_data=True) chart.set_categories(labels) ws.add_chart(chart, 'D2') wb.save(file_path) 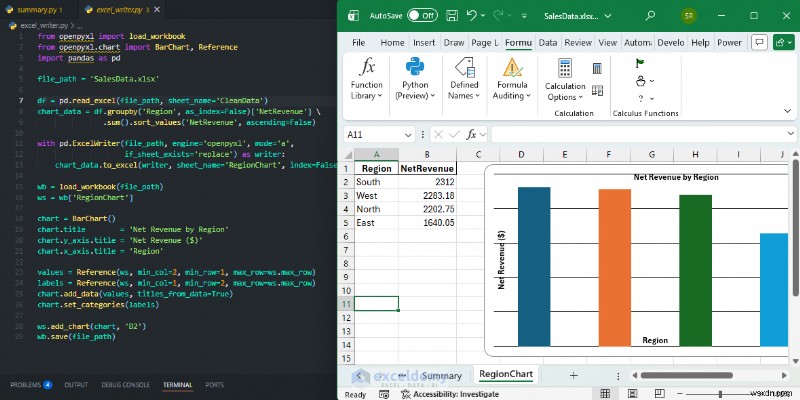
कब उपयोग करें: Pandas डेटा विश्लेषण में मदद करता है। openpyxl इसे डिलीवर करने में मदद करता है। OpenPyXL का उपयोग तब करें जब आपको पिक्सेल-परफेक्ट Excel आउटपुट की आवश्यकता हो जैसे रिपोर्ट और डैशबोर्ड जो हाथ से बने लगते हैं, और जब परिणाम को मूल Excel चार्ट और फॉर्मेटिंग के साथ .xlsx फ़ाइल में रहना हो जिसे सहकर्मी संपादित करना जारी रख सकें।
3. Matplotlib – Excel चार्ट से परे शक्तिशाली विज़ुअलाइज़ेशन
Excel चार्ट सुविधाजनक हैं, लेकिन Matplotlib विश्लेषकों को बहुत अधिक नियंत्रण देता है। Matplotlib स्थिर, प्रकाशन-गुणवत्ता वाले प्लॉट बनाने के लिए गो-टू लाइब्रेरी है। यह अत्यधिक अनुकूलन योग्य है और त्वरित खोजपूर्ण विश्लेषण के लिए Pandas के साथ अच्छी तरह से एकीकृत होता है।
Excel प्रो के लिए मुख्य ताकत:
- हीटमैप, ट्रेंडलाइन के साथ स्कैटर प्लॉट, बॉक्स प्लॉट, हिस्टोग्राम, और 3D चार्ट जैसे उन्नत प्लॉट बनाएँ
- फ़ॉन्ट, रंग, ग्रिडलाइन, टिक मार्क, और लीजेंड पर अधिक नियंत्रण प्राप्त करें
- मल्टी-पैनल सबप्लॉट लेआउट बनाएँ जो एक साथ कई चार्ट दिखाते हैं
- इमेज, PDF, या SVG में निर्यात करें, या OpenPyXL के साथ विज़ुअल्स को वापस Excel में एम्बेड करें
- कस्टम लेबल और तीर के साथ डेटा पॉइंट्स को एनोटेट करें
उदाहरण: मल्टी-पैनल बिक्री डैशबोर्ड बनाना
आइए दो-पैनल चार्ट बनाएँ: बाएँ मासिक राजस्व रुझान और दाएँ श्रेणी ब्रेकडाउन। फिर इसे किसी भी रिपोर्ट के लिए तैयार हाई-रिज़ॉल्यूशन इमेज के रूप में सहेजें।
import pandas as pd import matplotlib.pyplot as plt import matplotlib.ticker as mticker df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') df['Month'] = pd.to_datetime(df['OrderDate']).dt.to_period('M') monthly = df.groupby('Month')['NetRevenue'].sum() cat_rev = df.groupby('Category')['NetRevenue'].sum().sort_values(ascending=True) fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6)) fig.suptitle('Sales Performance Dashboard', fontsize=16, fontweight='bold') # बायाँ पैनल — मासिक राजस्व लाइन चार्ट ax1.plot(list(monthly.index.astype(str)), monthly.values, marker='o', color='#1E5FAD', linewidth=2) ax1.set_title('Monthly Net Revenue') ax1.set_xlabel('Month') ax1.set_ylabel('Revenue ($)') ax1.yaxis.set_major_formatter(mticker.FuncFormatter(lambda x, _: f'${x:,.0f}')) ax1.tick_params(axis='x', rotation=45) ax1.grid(axis='y', linestyle='--', alpha=0.5) # दायाँ पैनल — श्रेणी अनुसार राजस्व हॉरिजॉन्टल बार चार्ट ax2.barh(cat_rev.index, cat_rev.values, color='#217346') ax2.set_title('Revenue by Category') ax2.set_xlabel('Revenue ($)') ax2.xaxis.set_major_formatter(mticker.FuncFormatter(lambda x, _: f'${x:,.0f}')) plt.tight_layout() plt.savefig('sales_dashboard.png', dpi=150, bbox_inches='tight') print('Dashboard saved as sales_dashboard.png') 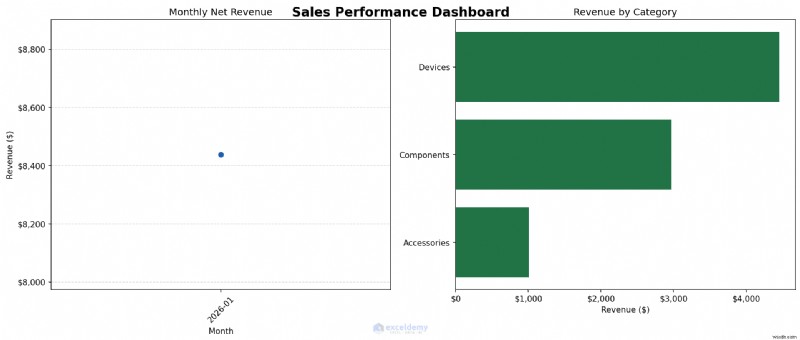
कब उपयोग करें: पहले विश्लेषण चार्ट बनाने के लिए Python का उपयोग करें। फिर तय करें कि चार्ट Python आउटपुट के रूप में रहना चाहिए या सारांश डेटा को अंतिम डैशबोर्ड फॉर्मेटिंग के लिए Excel में वापस करना चाहिए। Matplotlib का उपयोग तब करें जब आपको रिपोर्ट या प्रेजेंटेशन के लिए चार्ट की आवश्यकता हो, या जब आपको अपडेटेड डेटा से सुसंगत स्टाइलिंग के साथ वही चार्ट बार-बार उत्पन्न करने की आवश्यकता हो।
4. Seaborn – सांख्यिकीय डेटा विज़ुअलाइज़ेशन
Seaborn Matplotlib पर बनाता है और सांख्यिकीय विज़ुअलाइज़ेशन पर केंद्रित है। यह पैटर्न और सहसंबंध को उजागर करने वाले दिखने में आकर्षक चार्ट बनाने को सरल बनाता है। जहाँ Matplotlib को एक पॉलिश्ड चार्ट के लिए दर्जनों लाइनों की आवश्यकता हो सकती है, Seaborn अक्सर आकर्षक डिफ़ॉल्ट स्टाइलिंग के साथ एक या दो लाइनों में समान परिणाम प्राप्त कर सकता है। यह आपके डेटा में छिपे वितरण, सहसंबंध और पैटर्न को प्रकट करने में उत्कृष्ट है।
Excel प्रो के लिए मुख्य ताकत:
- सांख्यिकीय चार्ट तेज़ी से बनाएँ
- खोजपूर्ण डेटा विश्लेषण के लिए अच्छा काम करें
- यह देखने के लिए सहसंबंध हीटमैप बनाएँ कि कॉलम एक-दूसरे से कैसे संबंधित हैं
- बिल्ट-इन डेंसिटी कर्व के साथ वितरण प्लॉट बनाएँ
- समूहों की दृश्य तुलना के लिए बॉक्स प्लॉट और वायलिन प्लॉट का उपयोग करें
- संख्यात्मक कॉलम में स्वचालित स्कैटरप्लॉट मैट्रिक्स के लिए पेयर प्लॉट बनाएँ
- एक ही लाइन में कॉन्फिडेंस इंटरवल के साथ रिग्रेशन प्लॉट उत्पन्न करें
उदाहरण: सहसंबंध हीटमैप बनाना
अपने Excel डेटा में छिपे पैटर्न खोजें: कौन से चर एक साथ चलते हैं? एक हीटमैप इसका उत्तर जल्दी दे सकता है और Excel के अंतर्निहित टूल से कहीं आगे निकल जाता है।
import pandas as pd import seaborn as sns import matplotlib.pyplot as plt df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') correlation = df.select_dtypes(include='number').corr() plt.figure(figsize=(10, 8)) sns.heatmap( correlation, annot=True, # प्रत्येक सेल में सहसंबंध मान दिखाएँ fmt='.2f', cmap='coolwarm', # लाल = सकारात्मक, नीला = नकारात्मक center=0, square=True, linewidths=0.5 ) plt.title('Correlation Matrix — Sales Variables', fontsize=14, fontweight='bold') plt.tight_layout() plt.savefig('correlation_heatmap.png', dpi=150) print('Heatmap saved!') 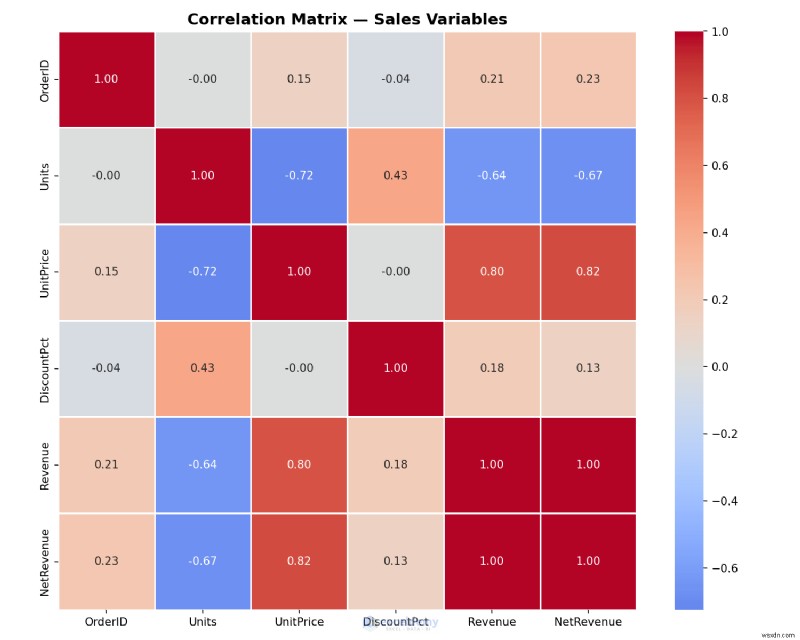
उदाहरण: एक लाइन में बॉक्स प्लॉट बनाना
आउटलायर्स को तुरंत पहचानने के लिए क्षेत्रों में राजस्व वितरण की तुलना करें।
plt.figure(figsize=(10, 6)) sns.boxplot(data=df, x='Region', y='NetRevenue', hue='Region', palette='Set2', legend=False) plt.title('Revenue Distribution by Region') plt.ylabel('Net Revenue ($)') plt.tight_layout() plt.savefig('region_boxplot.png', dpi=150) 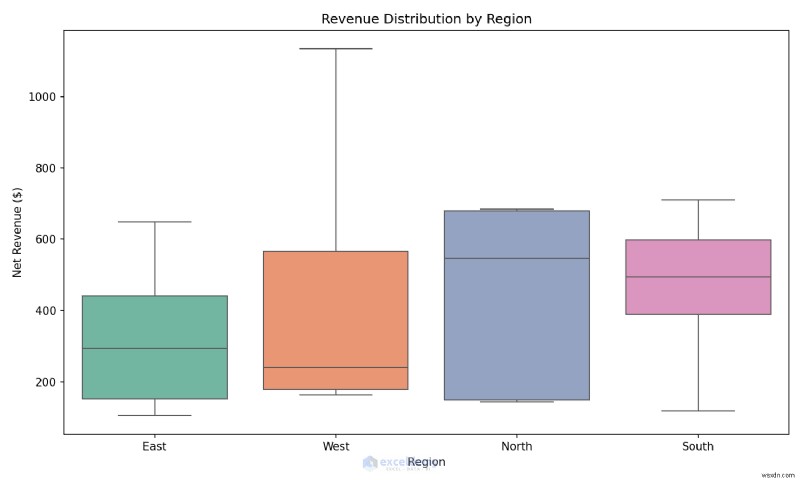
कब उपयोग करें: खोजपूर्ण विश्लेषण के दौरान Seaborn का उपयोग करें जब आप औपचारिक रिपोर्ट बनाने से पहले वितरण, आउटलायर्स और संबंधों को जल्दी समझना चाहते हैं।
5. Scikit-learn – Excel डेटा पर सीधे मशीन लर्निंग
यह वह लाइब्रेरी है जो आपको रिपोर्टिंग से निर्णय समर्थन की ओर ले जाती है। Scikit-learn आपके Excel वर्कफ़्लो में पेशेवर मशीन लर्निंग लाता है। यह Excel उपयोगकर्ताओं के लिए भविष्यवाणी विश्लेषण को सक्षम करता है, जिसमें रिग्रेशन, क्लासिफिकेशन, क्लस्टरिंग और पूर्वानुमान शामिल हैं जिन्हें देशी Excel आसानी से नहीं संभाल सकता। केवल यह वर्णन करने के बजाय कि आपके डेटा में क्या हुआ, यह भविष्यवाणी करने में मदद करता है कि आगे क्या हो सकता है, बिक्री पूर्वानुमान से लेकर ग्राहक क्लासिफिकेशन से लेकर विसंगति पहचान तक।
Excel प्रो के लिए मुख्य ताकत:
- रैखिक और लॉजिस्टिक रिग्रेशन संख्यात्मक परिणाम या श्रेणियों जैसे चर्न जोखिम या बिक्री पूर्वानुमान की भविष्यवाणी करने के लिए
- व्याख्यायोग्य भविष्यवाणियों के लिए निर्णय वृक्ष और रैंडम फॉरेस्ट
- केऔर मीन्स क्लस्टरिंग समान रिकॉर्ड को स्वचालित रूप से समूहित करने के लिए
- मॉडल सटीकता मापने के लिए ट्रेन-टेस्ट स्प्लिटिंग और क्रॉस-वैलिडेशन
- फीचर स्केलिंग, एन्कोडिंग, और प्रीप्रोसेसिंग पाइपलाइन
- फ़िल्टरिंग और सॉर्टिंग के लिए भविष्यवाणियों को Excel में वापस करें
उदाहरण: नेट राजस्व की भविष्यवाणी
अपने ऐतिहासिक बिक्री डेटा पर एक मॉडल प्रशिक्षित करें, फिर नए ऑर्डर के लिए राजस्व की भविष्यवाणी करने के लिए इसका उपयोग करें, जो एक ऐसा विश्लेषण है जिसे Excel मूल रूप से नहीं कर सकता।
import pandas as pd from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_absolute_error, r2_score from sklearn.preprocessing import LabelEncoder df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') # श्रेणीबद्ध कॉलम को संख्याओं के रूप में एनकोड करें for col in ['Region', 'Category', 'SalesRep']: if col in df.columns: df[col] = LabelEncoder().fit_transform(df[col].astype(str)) X = df[['Units', 'UnitPrice', 'DiscountPct', 'Region', 'Category']] y = df['NetRevenue'] # विभाजन: 80% ट्रेन, 20% टेस्ट X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=42 ) # रैंडम फॉरेस्ट मॉडल प्रशिक्षित करें model = RandomForestRegressor(n_estimators=100, random_state=42) model.fit(X_train, y_train) # सटीकता मूल्यांकन करें predictions = model.predict(X_test) print(f'Mean Absolute Error: ${mean_absolute_error(y_test, predictions):,.2f}') print(f'R² Score: {r2_score(y_test, predictions):.4f}') # भविष्यवाणियों को वापस Excel में निर्यात करें results = X_test.copy() results['Actual'] = y_test.values results['Predicted'] = predictions results.to_excel('predictions.xlsx', index=False) print('Predictions exported to predictions.xlsx') 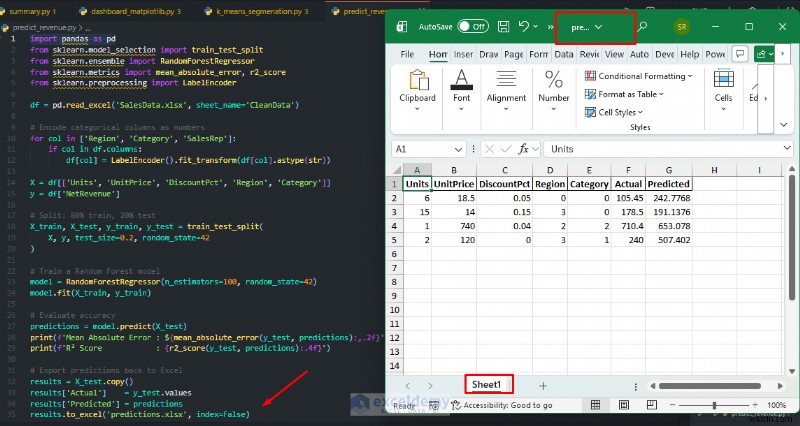
K-Means ग्राहक विभाजन:
कोई मैन्युअल मानदंड बिना खरीद व्यवहार के आधार पर ग्राहकों को स्वचालित रूप से समूहों में विभाजित करें।
import pandas as pd from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') customer = df.groupby('Customer').agg( TotalOrders = ('OrderID', 'count'), TotalRevenue = ('NetRevenue', 'sum'), AvgDiscount = ('DiscountPct', 'mean') ).reset_index() X_scaled = StandardScaler().fit_transform( customer[['TotalOrders', 'TotalRevenue', 'AvgDiscount']] ) customer['Segment'] = KMeans(n_clusters=3, random_state=42, n_init=10) \ .fit_predict(X_scaled) customer.to_excel('customer_segments.xlsx', index=False) print('Segmentation complete! See customer_segments.xlsx') 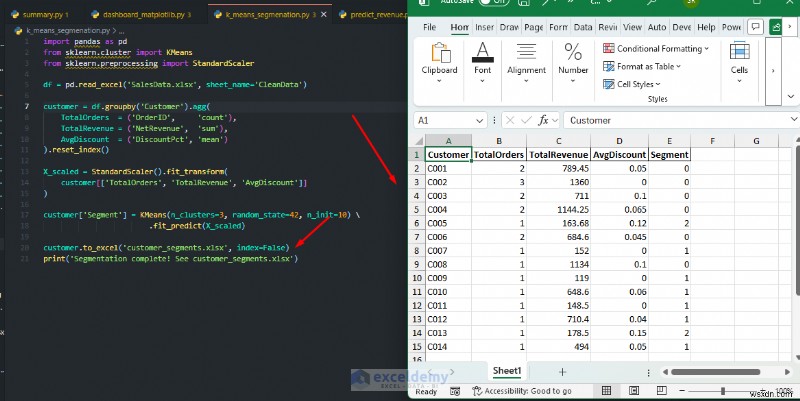
कब उपयोग करें: आप भविष्यवाणियों को वापस वर्कशीट में लिख सकते हैं, फिर Excel उपयोगकर्ताओं को परिणामों को फ़िल्टर, सॉर्ट, चार्ट, या फ़ॉर्मूला और सशर्त फॉर्मेटिंग के साथ संयोजित करने दें। यह पेशेवरों को मशीन लर्निंग अंतर्दृष्टि को सीधे स्प्रेडशीट में वापस जोड़ने की अनुमति देता है। Scikit-learn का उपयोग तब करें जब आपको भविष्य के मूल्यों का पूर्वानुमान लगाने, रिकॉर्ड को वर्गीकृत करने, या प्राकृतिक समूहों की खोज करने की आवश्यकता हो जो PivotTables प्रकट नहीं कर सकते।
बोनस: Xlwings – द्वि-दिशात्मक स्वचालन और लाइव Excel एकीकरण
xlwings लाइब्रेरी रीयल टाइम में एक Excel इंस्टेंस चलाती है। यह Python और Excel के बीच सेतु बनाता है, जिससे वास्तविक स्वचालन सक्षम होता है। जबकि openpyxl स्थिर फ़ाइलों को पढ़ता और लिखता है, xlwings Excel खोल सकता है, इसे लाइव मैनिपुलेट कर सकता है, मानों को वापस Python में पढ़ सकता है, Excel बटन से Python फ़ंक्शन ट्रिगर कर सकता है, और पूर्ण UDFs (यूज़र-डिफाइंड फ़ंक्शन) बना सकता है जो सेल्स में दिखाई देते हैं। यह कई VBA-आधारित वर्कफ़्लो का एक आधुनिक विकल्प है।
Excel प्रो के लिए मुख्य ताकत:
- लाइव Excel सत्र नियंत्रित करें: वर्कबुक को प्रोग्रामेटिक रूप से खोलें, पढ़ें, लिखें, और बंद करें
- Python फ़ंक्शन लिखें जिन्हें Excel सेल्स से सीधे UDFs के रूप में कॉल किया जा सके
- दोहराए जाने वाले कार्यों को स्वचालित करें जैसे डेटा रीफ्रेश करना और रिपोर्ट उत्पन्न करना
- Pandas DataFrames और Matplotlib चार्ट को सीधे नामित रेंज में पुश करें
- Excel बटन द्वारा ट्रिगर Python स्क्रिप्ट चलाएँ
- Windows और macOS दोनों पर काम करें
- डेस्कटॉप वर्कफ़्लो के लिए Python in Excel के लिए मजबूत विकल्प या पूरक के रूप में काम करें
xlwings का उपयोग तब करें जब आपको Excel के साथ लाइव, दो-तरफ़ा इंटरैक्शन की आवश्यकता हो, VBA मैक्रोज़ को बदलते समय, इंटरैक्टिव डैशबोर्ड बनाते समय, या गैर-तकनीकी सहकर्मियों को बटन क्लिक के साथ Python विश्लेषण ट्रिगर करने की अनुमति देते समय।
विभिन्न Excel प्रो के लिए सर्वश्रेष्ठ लाइब्रेरी स्टैक चुनना
हर विश्लेषक को एक साथ सभी पाँच लाइब्रेरी की आवश्यकता नहीं होती। उन्हें अपनाने का एक व्यावहारिक तरीका भूमिका के अनुसार है।
- रिपोर्टिंग विश्लेषकों के लिए: यह संयोजन आपको डेटा साफ करने, सारांश बनाने, चार्ट उत्पन्न करने, और पॉलिश्ड वर्कबुक आउटपुट निर्यात करने देता है।
- Pandas
- Matplotlib
- Openpyxl
- वित्त और संचालन विश्लेषकों के लिए: यह स्टैक मॉडलिंग, KPI गणना, आवंटन, और दोहराने योग्य मासिक रिपोर्टिंग के लिए अच्छा काम करता है।
- Pandas
- Seaborn
- Openpyxl
- उन्नत विश्लेषण टीमों के लिए: यह संयोजन आपको डेटा तैयारी से भविष्यवाणी स्कोरिंग से वर्कबुक डिलीवरी तक पूर्ण पाइपलाइन देता है।
- Pandas
- Matplotlib
- Scikit-learn
- Openpyxl
- Seaborn
अंतिम विचार
ये पाँच Python लाइब्रेरी हैं जो उन्नत Excel डेटा विश्लेषण के लिए हर प्रो को उपयोग करना चाहिए। इन टूल्स में महारत हासिल करें, और आप Excel को एक साधारण स्प्रेडशीट एप्लिकेशन से एक अधिक सक्षम विश्लेषण प्लेटफॉर्म में बदल सकते हैं। एक समझदार सीखने का मार्ग है Pandas से शुरू करना, फिर openpyxl जोड़ना, फिर Matplotlib और Seaborn को एक साथ सीखना, और उसके बाद Scikit-learn से निपटना। प्रत्येक लाइब्रेरी उन्हीं .xlsx फ़ाइलों के साथ काम करती है जिनका आप पहले से उपयोग करते हैं। अधिक सक्षम डेटा विश्लेषक बनने के लिए उनकी खोज शुरू करें।
निःशुल्क उन्नत Excel अभ्यास समाधान के साथ प्राप्त करें!