Python in Excel, Microsoft 365 की एक शक्तिशाली सुविधा है जो आपको Excel सेल्स में सीधे Python कोड लिखने और चलाने की अनुमति देती है। यह Python एनालिटिक्स की शक्ति को Excel में लाता है। आप किसी सेल में सीधे Python टाइप करते हैं, Python गणनाएँ Microsoft क्लाउड में चलती हैं, और आपके परिणाम वर्कशीट में वापस आ जाते हैं। आप स्प्रेडशीट छोड़े बिना या स्थानीय रूप से कुछ भी इंस्टॉल किए बिना Excel के परिचित इंटरफेस और रिकैलकुलेशन को Python के समृद्ध इकोसिस्टम के साथ डेटा विश्लेषण, सफाई, सांख्यिकी और विज़ुअलाइज़ेशन के लिए जोड़ सकते हैं।
इस ट्यूटोरियल में, हम दिखाएंगे कि Python in Excel का उपयोग कैसे करें और यह कब और कैसे उपयोगी है। Jupyter या VS Code जैसे अन्य टूल्स पर स्विच करने के बजाय, आप Python को सीधे Excel में उपयोग कर सकते हैं।
आवश्यकताएँ और उपलब्धता
- Microsoft 365 सब्सक्रिप्शन: कई भुगतान योजनाओं पर उपलब्ध (उपभोक्ता Family/Personal, कमर्शियल, एजुकेशन, एंटरप्राइज़)। कुछ सुविधाओं या उच्च कंप्यूट के लिए ऐड-ऑन की आवश्यकता हो सकती है।
- प्लेटफॉर्म: मुख्य रूप से Windows डेस्कटॉप Excel पर उपलब्ध; वेब, Mac और मोबाइल के लिए समर्थन भिन्न होता है। Excel for iPad, Excel for iPhone, या Excel for Android पर उपलब्ध नहीं।
- स्थानीय Python की आवश्यकता नहीं: सब कुछ पूर्व-इंस्टॉल्ड लाइब्रेरीज़ के साथ क्लाउड में चलता है। Python in Excel का उपयोग करने के लिए आपको अपने कंप्यूटर पर Python का स्थानीय संस्करण इंस्टॉल करने की आवश्यकता नहीं है। यदि आपके कंप्यूटर पर Python का स्थानीय संस्करण इंस्टॉल है, तो उस इंस्टॉलेशन में आपके द्वारा किए गए कोई भी कस्टमाइज़ेशन Python in Excel गणनाओं में प्रतिबिंबित नहीं होंगे।
महत्वपूर्ण: Python in Excel का उपयोग करने के लिए, आपको इंटरनेट एक्सेस की आवश्यकता होती है। ऐसा इसलिए है क्योंकि Python in Excel गणनाएँ Microsoft क्लाउड में Python भाषा के एक मानक संस्करण का उपयोग करके चलती हैं।
Python in Excel का उपयोग शुरू करना
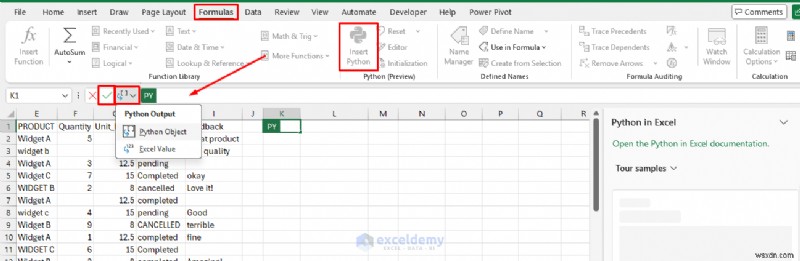
किसी सेल में Python सक्षम करें:
- एक सेल चुनें
- Formulas टैब पर जाएँ >> Insert Python चुनें
- या किसी सेल में =PY टाइप करें और Tab दबाएँ
- फॉर्मूला बार हरा हो जाता है, जो Python मोड को दर्शाता है
xl() फ़ंक्शन: Excel और Python के बीच सेतु
Python in Excel का उपयोग करने की कुंजी xl() फ़ंक्शन है, जो आपके Python कोड को स्प्रेडशीट से सीधे डेटा पढ़ने देता है:
- संपादन मोड में रहते हुए, एक सेल या रेंज चुनने के लिए क्लिक करके खींचें (जैसे, A1:D100)
- Excel xl("A1:D100") या इसी तरह का रेफरेंस डालता है
# एक रेंज को pandas DataFrame के रूप में रेफरेंस करें
df = xl("A1:D100", headers=True)
# एक सेल मान को रेफरेंस करें
target = xl("F1")
यही तरीका है जिससे Python आपके स्प्रेडशीट डेटा को "देखता" है। आप इसे =PY() सेल के अंदर लिखते हैं और परिणाम को एक सामान्य Python ऑब्जेक्ट के रूप में उपयोग करते हैं।
आउटपुट विकल्प:
- फॉर्मूला बार में ड्रॉपडाउन का उपयोग करके Excel Value (देशी Excel सेल्स/टेबल्स में परिवर्तित) के रूप में वापस करें या Python Object (अन्य Python सेल्स में चेनिंग के लिए) के रूप में रखें
- Ctrl + Alt + Shift + M दबाकर आउटपुट प्रकार टॉगल करें
- कुछ मामलों में डीबगिंग या आउटपुट के लिए print() का उपयोग करें
रिकैलकुलेशन: Python सेल्स अन्य फ़ॉर्मूला की तरह स्वचालित रूप से रिकैलकुलेट होते हैं, जब इनपुट बदलते हैं (स्वचालित मोड में)।
सुझाव: छोटे से शुरू करें। अपना डेटा चुनें, Python डालें, इसे DataFrame में बदलें, फिर .head(), .describe(), या सरल ऑपरेशन से एक्सप्लोर करें।
Python in Excel कब उपयोगी है
1. उन्नत डेटा सफाई और परिवर्तन
Python गन्दी तारीखों को आसानी से ठीक कर सकता है, टेक्स्ट को मानकीकृत कर सकता है (कैपिटलाइज़ेशन, स्पेसिंग), नल और डुप्लिकेट को संभाल सकता है, वाइड डेटा को लॉन्ग फॉर्मेट में अनपिवट कर सकता है, और असंगत फॉर्मेट या लापता मानों को प्रबंधित कर सकता है। Pandas इन कार्यों को संक्षिप्त और पुनरुत्पादन योग्य बनाता है।
Python:
import pandas as pd df = xl("A1:I56", headers=True) df.columns = df.columns.str.strip().str.title() # नाम ठीक करें: टाइटल केस df["Customer_Name"] = df["Customer_Name"].str.strip().str.title() # क्षेत्र ठीक करें: टाइटल केस df["Region"] = df["Region"].str.strip().str.title() # उत्पाद मानकीकृत करें: टाइटल केस df["Product"] = df["Product"].str.strip().str.title() # स्थिति और फीडबैक मानकीकृत करें df["Status"] = df["Status"].str.strip().str.capitalize() df["Feedback"] = df["Feedback"].str.strip().str.capitalize() # सभी गन्दी तारीख फॉर्मेट को एक में पार्स करें df["Order_Date"] = pd.to_datetime(df["Order_Date"], dayfirst=True, errors="coerce") # लापता मात्रा को माध्यिका से भरें df["Quantity"] = pd.to_numeric(df["Quantity"], errors="coerce") df["Quantity"] = df["Quantity"].fillna(df["Quantity"].median()) df - टिक मार्क पर क्लिक करें या कोड चलाने के लिए Ctrl+Enter दबाएँ
- आउटपुट सेल पर कार्ड आइकन >> arrayPreview चुनें
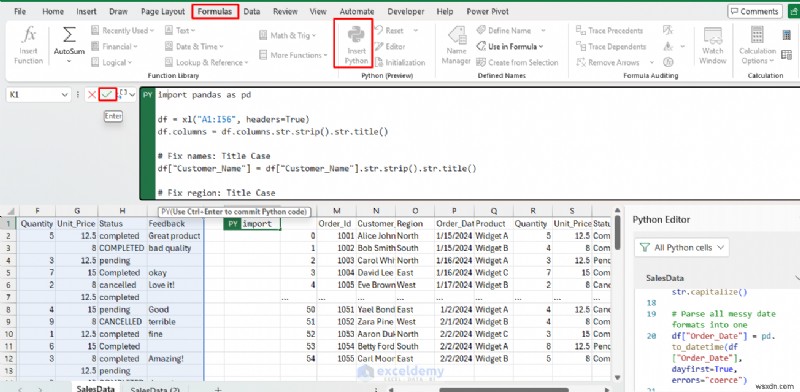
साफ किया गया DataFrame स्वचालित रूप से शीट में वापस फैल जाता है। साफ डेटा को आगे के विश्लेषण और गणनाओं के लिए उपयोग करने के लिए परिणाम को Excel मानों के रूप में वापस करें।
- फॉर्मूला बार से ड्रॉपडाउन खोलें >> Excel Value चुनें
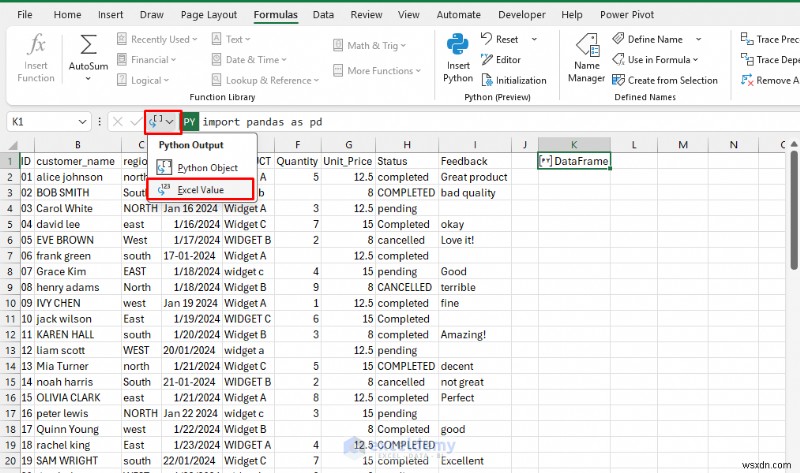
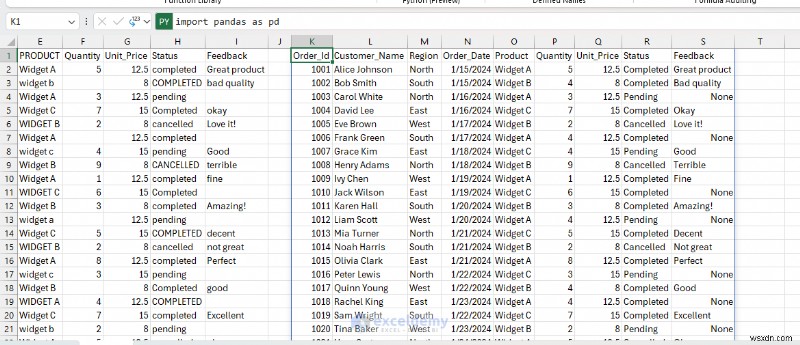
- अब अन्य उदाहरणों में नए, साफ डेटा का उपयोग करें
2. जटिल डेटा विश्लेषण और सांख्यिकी
Python, Excel के अंतर्निहित फ़ंक्शन से परे संचालन को सक्षम बनाता है, जिसमें जटिल ग्रुपिंग, मल्टी-स्टेप परिवर्तन और सांख्यिकीय सारांश शामिल हैं। यह टाइम-सीरीज़ विश्लेषण, रिग्रेशन, क्लस्टरिंग, आउटलायर डिटेक्शन, टेक्स्ट पर सेंटीमेंट विश्लेषण और मोंटे कार्लो सिमुलेशन का भी समर्थन करता है।
Python:
import pandas as pd # SalesData शीट से डेटा लोड करें df = xl("SalesData!K1:S156", headers=True) df["Revenue"] = df["Quantity"] * df["Unit_Price"] # राजस्व सारांश + आउटलायर फ्लैग (> 2 मानक विचलन) summary = df.groupby("Region")["Revenue"].agg(["sum", "mean", "std"]) summary["outlier_threshold"] = summary["mean"] + 2 * summary["std"] summary.round(2) परिणाम सीधे आपकी शीट में एक टेबल के रूप में वापस फैल जाता है। आप संपूर्ण DataFrame के लिए सारांश सांख्यिकी दिखाने के लिए df.describe() का भी उपयोग कर सकते हैं।
Python:
import pandas as pd # SalesData शीट से डेटा लोड करें df = xl("SalesData!K1:S156", headers=True) df["Revenue"] = df["Quantity"] * df["Unit_Price"] df.describe() 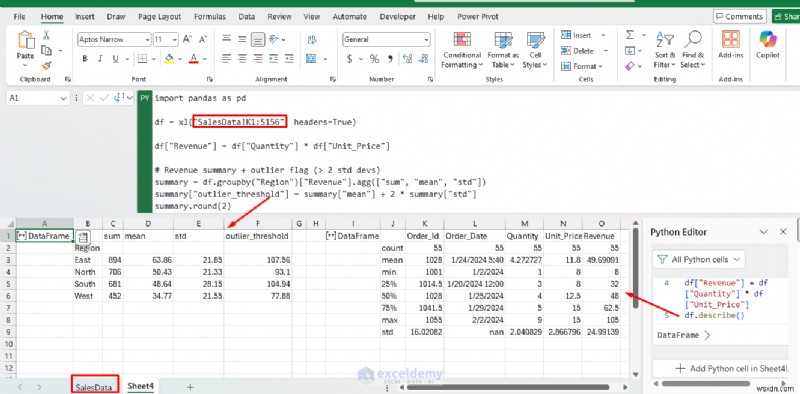
3. बेहतर चार्ट और विज़ुअलाइज़ेशन
Matplotlib, Seaborn, या plotnine के साथ डेंसिटी प्लॉट, स्वार्म प्लॉट, वर्ड क्लाउड, या स्मॉल मल्टीपल जैसे पेशेवर प्लॉट बनाना आसान है। ये Excel चार्ट की तुलना में कहीं अधिक लचीले हैं। Matplotlib और Seaborn के साथ Excel के मूल चार्ट से आगे बढ़ें:
Python:
import pandas as pd import matplotlib.pyplot as plt import seaborn as sns # SalesData शीट से डेटा लोड करें df = xl("SalesData!K1:S156", headers=True) df["Revenue"] = df["Quantity"] * df["Unit_Price"] fig, ax = plt.subplots(figsize=(8, 4)) sns.boxplot(data=df, x="Region", y="Revenue", palette="Set2", ax=ax) ax.set_title("Revenue Distribution by Region") ax.set_xlabel("Region") ax.set_ylabel("Revenue ($)") fig 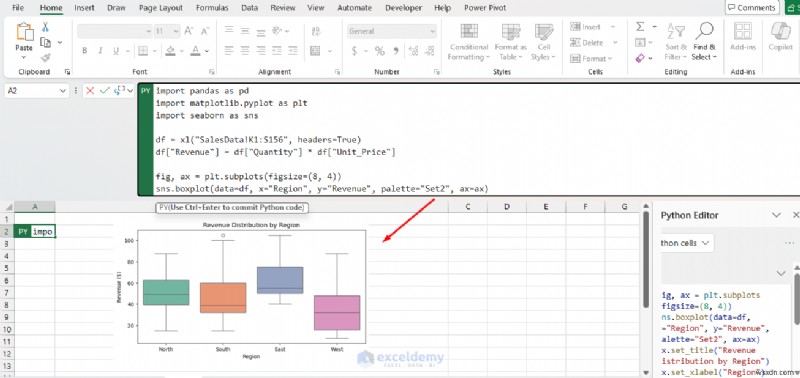
चार्ट वर्कशीट में सीधे एक इमेज ऑब्जेक्ट के रूप में रेंडर होता है, जिसे किसी भी Excel चार्ट की तरह आकार दिया और स्थानांतरित किया जा सकता है।
4. आपके स्प्रेडशीट डेटा पर मशीन लर्निंग
Python भविष्यवाणी मॉडलिंग और पूर्वानुमान को सक्षम बनाता है। आप statsmodels या scikit-learn का उपयोग करके अपने Excel डेटा पर सीधे अधिक सटीक पूर्वानुमान या सरल मशीन लर्निंग मॉडल बना सकते हैं।
Excel छोड़े बिना भविष्यवाणी मॉडल चलाएँ:
Python:
import pandas as pd from sklearn.linear_model import LinearRegression # SalesData शीट से डेटा लोड करें df = xl("SalesData!K1:S156", headers=True) # संख्यात्मक में बदलें और लापता मानों को माध्यिका से भरें df["Quantity"] = pd.to_numeric(df["Quantity"], errors="coerce") df["Unit_Price"] = pd.to_numeric(df["Unit_Price"], errors="coerce") df["Quantity"] = df["Quantity"].fillna(df["Quantity"].median()) df["Unit_Price"] = df["Unit_Price"].fillna(df["Unit_Price"].median()) # राजस्व की गणना करें df["Revenue"] = df["Quantity"] * df["Unit_Price"] # उत्पाद को वन-हॉट एनकोड करें X = pd.get_dummies(df[["Product", "Unit_Price"]], drop_first=True) y = df["Revenue"] # रैखिक रिग्रेशन मॉडल फिट करें model = LinearRegression().fit(X, y) # भविष्यवाणियाँ जोड़ें df["Predicted_Revenue"] = model.predict(X).round(2) # उपयोगी कॉलम के साथ अंतिम परिणाम बनाएँ result = df[["Order_Id", "Product", "Revenue", "Predicted_Revenue"]].copy() result["Difference"] = (result["Revenue"] - result["Predicted_Revenue"]).round(2) # वैकल्पिक: मॉडल प्रदर्शन दिखाएँ print("Model R² Score:", round(model.score(X, y), 4)) result 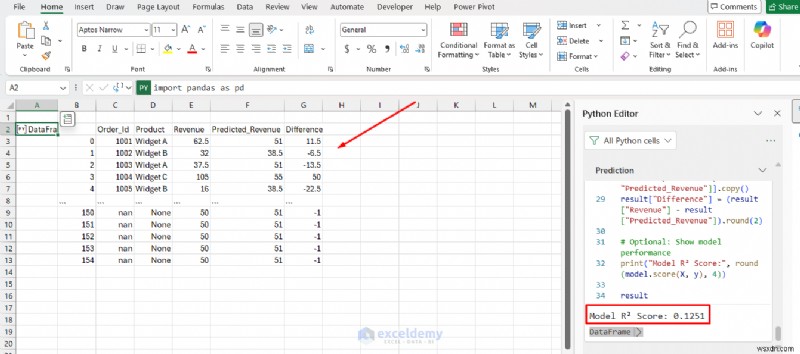
व्यावसायिक विश्लेषक अलग वातावरण पर स्विच किए बिना अपने मौजूदा डेटा पर मशीन लर्निंग मॉडल लागू कर सकते हैं।
5. रोलिंग गणना और टाइम सीरीज़
केवल Excel फ़ॉर्मूला का उपयोग करके मूविंग एवरेज, क्यूमुलेटिव सम, या लैग फीचर्स की गणना करना मुश्किल है। Python इन कार्यों को सरल बनाता है।
Python:
import pandas as pd # अपना पूरा बिक्री डेटा लोड करें df = xl("SalesData!K1:S156", headers=True) # दैनिक राजस्व की गणना करें df["Revenue"] = df["Quantity"] * df["Unit_Price"] # रोलिंग गणना (टाइम सीरीज़) # पहले तारीख के अनुसार सॉर्ट करें (टाइम सीरीज़ के लिए महत्वपूर्ण) df = df.sort_values("Order_Date").reset_index(drop=True) # राजस्व पर 7-दिन की रोलिंग मेट्रिक्स (साप्ताहिक रुझान) df["Revenue_7d_Mean"] = df["Revenue"].rolling(window=7, min_periods=1).mean().round(2) df["Revenue_7d_Sum"] = df["Revenue"].rolling(window=7, min_periods=1).sum().round(2) df["Revenue_7d_Max"] = df["Revenue"].rolling(window=7, min_periods=1).max().round(2) df["Revenue_7d_Std"] = df["Revenue"].rolling(window=7, min_periods=1).std().round(2) # 30-दिन का रोलिंग माध्य (मासिक रुझान) df["Revenue_30d_Mean"] = df["Revenue"].rolling(window=30, min_periods=1).mean().round(2) # क्यूमुलेटिव राजस्व (रनिंग टोटल) df["Cumulative_Revenue"] = df["Revenue"].cumsum().round(2) # प्रदर्शित करने के लिए कॉलम चुनें result = df[["Order_Id", "Order_Date", "Product", "Revenue", "Revenue_7d_Mean", "Revenue_7d_Sum", "Revenue_30d_Mean", "Cumulative_Revenue"]] result यह दृष्टिकोण बिक्री रुझानों के विश्लेषण, दैनिक या साप्ताहिक उतार-चढ़ाव को सुचारू करने, विसंगतियों का पता लगाने और गति पूर्वानुमान के लिए उपयोगी है।
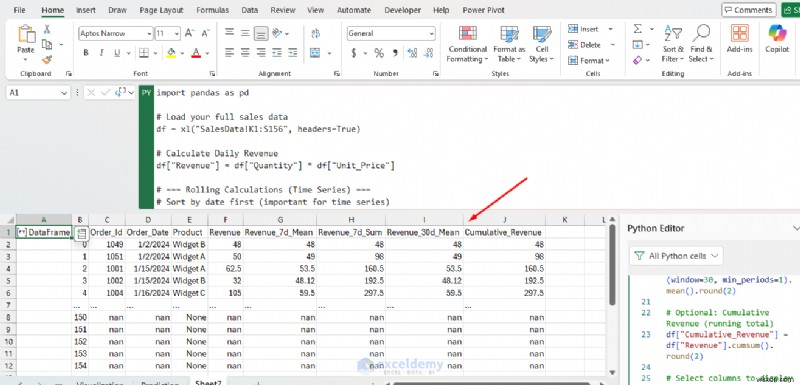
- Revenue_7d_Mean: 7-दिन का मूविंग एवरेज (साप्ताहिक बिक्री रुझानों को सुचारू करता है)
- Revenue_7d_Sum: पिछले 7 दिनों में कुल राजस्व
- Revenue_30d_Mean: 30-दिन का मूविंग एवरेज (लंबी अवधि का रुझान)
- Cumulative_Revenue: उस तारीख तक के सभी राजस्व का रनिंग टोटल
सुझाव और सर्वोत्तम अभ्यास
- सेल्स को चेन करें: मल्टी-स्टेप वर्कफ़्लो बनाने के लिए पिछले Python ऑब्जेक्ट्स (वे वेरिएबल्स के रूप में दिखाई देते हैं) को रेफरेंस करें, बिना किसी एक सेल को अव्यवस्थित किए
- प्रदर्शन: भारी गणनाओं के लिए, क्लाउड कोटा का ध्यान रखें। बड़े कार्यों को चरणों में विभाजित करें या आवश्यकता होने पर प्रीमियम कंप्यूट का उपयोग करें
- सुरक्षा: कोड आइसोलेटेड क्लाउड कंटेनरों में चलता है। संवेदनशील ऑपरेशन से बचें; Microsoft गोपनीयता प्रबंधित करता है
- डीबगिंग: print() का उपयोग करें या DataFrames को चरणबद्ध तरीके से आउटपुट करें। त्रुटियाँ सेल में दिखाई देती हैं
- Excel के साथ संयोजित करें: भारी काम के लिए Python का उपयोग करें और फ़ॉर्मेटिंग, पिवट, या डैशबोर्ड के लिए Excel का
- लर्निंग कर्व: यदि आप Python में नए हैं, तो पहले pandas पर ध्यान केंद्रित करें। कई मुफ्त ट्यूटोरियल और सैंपल फ़ाइलें उपलब्ध हैं
- शेयरिंग: संगत Microsoft 365 वाले प्राप्तकर्ता परिणाम देख या रीफ्रेश कर सकते हैं; अन्यथा, परिणाम स्थिर मानों में परिवर्तित हो जाते हैं
जानने योग्य सीमाएँ
- केवल क्लाउड निष्पादन; इंटरनेट कनेक्शन आवश्यक है
- मानक योजनाओं पर कंप्यूट कोटा
- Python वातावरण Anaconda-प्रबंधित है; आप अपने स्वयं के पैकेज इंस्टॉल नहीं कर सकते या स्थानीय कस्टमाइज़ेशन का उपयोग नहीं कर सकते
- मोबाइल और वेब समर्थन डेस्कटॉप की तुलना में सीमित है
- बहुत बड़े डेटासेट या लंबे समय तक चलने वाला कोड टाइमआउट का सामना कर सकता है
निष्कर्ष
Python in Excel सबसे उपयोगी होता है जब आपका काम मूल रूप से स्प्रेडशीट-आधारित होता है, लेकिन विश्लेषण अधिक उन्नत होता जा रहा है। यह डेटा सफाई, DataFrame-शैली विश्लेषण, उन्नत सांख्यिकी और विज़ुअलाइज़ेशन में उत्कृष्ट है। यह रोजमर्रा के स्प्रेडशीट कार्यों के लिए कम उपयोगी है, जिन्हें Excel पहले से ही अच्छी तरह से संभालता है। Python in Excel स्प्रेडशीट उपयोगकर्ताओं और डेटा वैज्ञानिकों के बीच की खाई को पाटता है, परिचित वर्कफ़्लो को बाधित किए बिना उन्नत विश्लेषण को सुलभ बनाता है। Python से Excel को बदलने के बजाय, Python का चुनिंदा उपयोग करें जब विश्लेषण केवल फ़ॉर्मूला के लिए बहुत जटिल हो जाए।
निःशुल्क उन्नत Excel अभ्यास समाधान के साथ प्राप्त करें!