इस ट्यूटोरियल में, हम TRAI की आधिकारिक वेबसाइट से मोबाइल डेटा स्पीड डाउनलोड करके उसका विश्लेषण करेंगे। फ़ाइल डाउनलोड करने के चरण।
एल्गोरिदम
1. [TRAI](https://myspeed.trai.gov.in/) वेबसाइट पर जाएं।
2. पेज के अंत तक स्क्रॉल करें।
3. आपको विभिन्न महीनों के लिए मोबाइल स्पीड डेटा मिलेगा।
4. सितंबर का मोबाइल डेटा स्पीड डाउनलोड करें।
आइए CSV फ़ाइल में कॉलम देखें।
नेटवर्क नाम
नेटवर्क प्रौद्योगिकी
परीक्षण का प्रकार
स्पीड
सिग्नल स्ट्रेंथ
राज्य
हमें pandas, numpy, matplotlib लाइब्रेरी की आवश्यकता होगी। आइए डेटा विश्लेषण के लिए कोडिंग शुरू करें।
उदाहरण
# आवश्यक लाइब्रेरी आयात करें
import pandas as pd
import numpy as np
import matplotlib.pyplot as plot

# स्थिरांक
DATASET = 'sept19_publish.csv'
NETWORK_NAME = 'JIO'
STATE = 'Andhra Pradesh'

# मान स्टोर करने के लिए सूची
download_speeds = []
upload_speeds = []
states = []
operators = []

# pandas का उपयोग करके डेटासेट आयात करें
data_frame = pd.read_csv(DATASET)

# आसान पहुंच के लिए कॉलम नाम असाइन करें
data_frame.columns = ['Network', 'Technology', 'Type Of Test', 'Speed', 'Signal Strength', 'State']

# डेटासेट से अद्वितीय राज्य और ऑपरेटर प्राप्त करें
unique_states = data_frame['State'].unique()
unique_operators = data_frame['Network'].unique()
print(unique_states)
print()
print(unique_operators)
आउटपुट
यदि आप उपरोक्त प्रोग्राम चलाते हैं तो आपको निम्न परिणाम मिलेगा।
['Kolkata' 'Punjab' 'Delhi' 'UP West' 'Haryana' nan 'West Bengal' 'Tamil Nadu' 'Kerala' 'Rajasthan' 'Gujarat' 'Maharashtra' 'Chennai' 'Madhya Pradesh' 'UP East' 'Karnataka' 'Orissa' 'Andhra Pradesh' 'Bihar' 'Mumbai' 'North East' 'Himachal Pradesh' 'Assam' 'Jammu & Kashmir']
['JIO' 'AIRTEL' 'VODAFONE' 'IDEA' 'CELLONE' 'DOLPHIN']
निरंतरता...
# वांछित नेटवर्क से संबंधित डेटा प्राप्त करें
# हमने पहले ही नेटवर्क घोषित कर दिया है
# यह डेटा फ़िल्टर कर रहा है
JIO = data_frame[data_frame['Network'] == NETWORK_NAME]

# सभी राज्यों के माध्यम से पुनरावृति
for state in unique_states:
    # वर्तमान राज्य का सारा डेटा प्राप्त करें
    current_state = JIO[JIO['State'] == state]
    # वर्तमान_स्टेट से डाउनलोड स्पीड प्राप्त करें
    download_speed = current_state[current_state['Type Of Test'] == 'download']
    # डाउनलोड_स्पीड औसत की गणना करें
    download_speed_avg = download_speed['Speed'].mean()
    # वर्तमान_स्टेट से अपलोड स्पीड प्राप्त करें
    upload_speed = current_state[current_state['Type Of Test'] == 'upload']
    # अपलोड_स्पीड औसत की गणना करें
    upload_speed_avg = upload_speed['Speed'].mean()
    # जांचें कि औसत nan हैं या नहीं
    if pd.isnull(download_speed_avg) or pd.isnull(upload_speed_avg):
        # दोनों स्पीड को शून्य असाइन करें
        download_speed, upload_speed = 0, 0
    else:
        # प्लॉट करने के लिए राज्य जोड़ें यदि मान nan नहीं हैं
        states.append(state)
    download_speeds.append(download_speed_avg)
    upload_speeds.append(upload_speed_avg)
    # डाउनलोड और अपलोड औसत प्रिंट करें
    print(f'{state}: Download Avg. {download_speed_avg:.3f} Upload Avg. {upload_speed_avg:.3f}')
आउटपुट
यदि आप उपरोक्त कोड चलाते हैं तो आपको निम्न परिणाम मिलेगा।
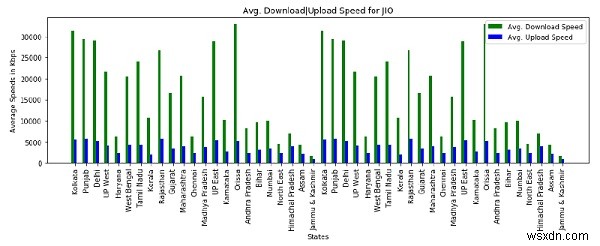
Kolkata: Download Avg. 31179.157 Upload Avg. 5597.086
Punjab: Download Avg. 29289.594 Upload Avg. 5848.015
Delhi: Download Avg. 28956.174 Upload Avg. 5340.927
UP West: Download Avg. 21666.673 Upload Avg. 4118.200
Haryana: Download Avg. 6226.855 Upload Avg. 2372.987
West Bengal: Download Avg. 20457.976 Upload Avg. 4219.467
Tamil Nadu: Download Avg. 24029.364 Upload Avg. 4269.765
Kerala: Download Avg. 10735.611 Upload Avg. 2088.881
Rajasthan: Download Avg. 26718.066 Upload Avg. 5800.989
Gujarat: Download Avg. 16483.987 Upload Avg. 3414.485
Maharashtra: Download Avg. 20615.311 Upload Avg. 4033.843
Chennai: Download Avg. 6244.756 Upload Avg. 2271.318
Madhya Pradesh: Download Avg. 15757.381 Upload Avg. 3859.596
UP East: Download Avg. 28827.914 Upload Avg. 5363.082
Karnataka: Download Avg. 10257.426 Upload Avg. 2584.806
Orissa: Download Avg. 32820.872 Upload Avg. 5258.215
Andhra Pradesh: Download Avg. 8260.547 Upload Avg. 2390.845
Bihar: Download Avg. 9657.874 Upload Avg. 3197.166
Mumbai: Download Avg. 9984.954 Upload Avg. 3484.052
North East: Download Avg. 4472.731 Upload Avg. 2356.284
Himachal Pradesh: Download Avg. 6985.774 Upload Avg. 3970.431
Assam: Download Avg. 4343.987 Upload Avg. 2237.143
Jammu & Kashmir: Download Avg. 1665.425 Upload Avg. 802.925
निरंतरता...
# ग्राफ प्लॉट करें
fix, axes = plot.subplots()
# बार चौड़ाई सेट करें
bar_width = 0.25
# राज्यों की स्थिति पुनर्व्यवस्थित करें
re_states = np.arange(len(states))
# चौड़ाई और ऊंचाई सेट करें
plot.figure(num = None, figsize = (12, 5))
# डाउनलोड स्पीड प्लॉट करें
plot.bar(re_states, download_speeds, bar_width, color = 'g', label = 'Avg. Download Speed')
# अपलोड स्पीड प्लॉट करें
plot.bar(re_states + bar_width, upload_speeds, bar_width, color='b', label='Avg. Upload Speed')
# ग्राफ का शीर्षक
plot.title('Avg. Download|Upload Speed for ' + NETWORK_NAME)
# x-एक्सिस लेबल
plot.xlabel('States')
# y-एक्सिस लेबल
plot.ylabel('Average Speeds in Kbps')
# प्रत्येक बार के नीचे लेबल, राज्यों से मेल खाता हुआ
plot.xticks(re_states + bar_width, states, rotation = 90)
# लीजेंड ड्रा करें
plot.legend()
# ग्राफ लेआउट टाइट करें
plot.tight_layout()
# ग्राफ दिखाएं
plot.show()
आउटपुट
यदि आप उपरोक्त ग्राफ चलाते हैं तो आपको निम्न ग्राफ मिलेगा।
निष्कर्ष
आप अपनी आवश्यकताओं के आधार पर विभिन्न ग्राफ प्लॉट कर सकते हैं। विभिन्न ग्राफ प्लॉट करके डेटासेट के साथ प्रयोग करें। यदि ट्यूटोरियल के संबंध में आपके कोई संदेह हैं, तो उन्हें कमेंट सेक्शन में उल्लेख करें।