Computer >> कंप्यूटर ट्यूटोरियल >  >> प्रोग्रामिंग >> Python

पैंडास में मल्टीइंडेक्स पर groupby कैसे करें


परिचय

मल्टीइंडेक्स डेटा फ्रेम एक से अधिक इंडेक्स वाला डेटा फ्रेम होता है। मान लें कि डेस्कटॉप पर निम्नलिखित CSV स्टोर है:
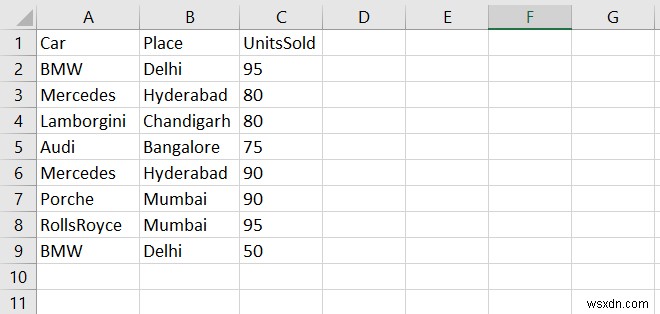
पैंडास में मल्टीइंडेक्स पर groupby कैसे करें

चरण-दर-चरण कार्यान्वयन

1. पैंडास लाइब्रेरी आयात करें और CSV फाइल पढ़ें

import pandas as pd
df = pd.read_csv("C:/Users/amit_/Desktop/sales.csv")
print(df)

2. डेटाफ्रेम के 'Car' और 'Place' कॉलम को इंडेक्स के रूप में बनाएं

df = df.set_index(['Car', 'Place'])

डेटाफ्रेम अब 'Car' और 'Place' कॉलम को इंडेक्स के रूप में रखने वाला मल्टी-इंडेक्स डेटाफ्रेम है।

3. मल्टीइंडेक्स डेटाफ्रेम पर groupby का उपयोग करें

res = df.groupby(level=['Car'])['UnitsSold'].mean()
print(res)

पूर्ण उदाहरण

import pandas as pd

df = pd.read_csv("C:/Users/amit_/Desktop/sales.csv")
print(df)

df = df.set_index(['Car', 'Place'])
df.sort_index()

res = df.groupby(level=['Car'])['UnitsSold'].mean()
print(res)

आउटपुट

     Car     Place  Sold
0     BMW     Delhi     95
1  Mercedes Hyderabad     80
2 Lamborgini Chandigarh     80
3     Audi  Bangalore     75
4  Mercedes Hyderabad     90
5   Porsche     Mumbai     90
6 RollsRoyce Mumbai     95
7     BMW     Delhi     50

Car
Audi        75.8
BMW         72.5
Lamborgini  80.0
Mercedes    85.0
Porsche     90.0
RollsRoyce  95.0
Name: UnitsSold, dtype: float64
  1. पांडास डेटाफ्रेम को डेट द्वारा एग्रीगेट करके कैसे प्लॉट करें? पांडास डेटाफ्रेम को डेट द्वारा एग्रीगेट करके कैसे प्लॉट करें?

    पांडास डेटाफ्रेम को डेट द्वारा एग्रीगेट करके प्लॉट करने के लिए, हम निम्नलिखित चरण अपना सकते हैं: चरण फिगर साइज़ सेट करें और सबप्लॉट्स के बीच और आसपास पैडिंग एडजस्ट करें। दो-आयामी, आकार-परिवर्तनीय, संभावित रूप से विषम सारणीबद्ध डेटा का डेटा फ्रेम df बनाएं। डेट द्वारा एग्रीगेट किए गए पांडास डेटाफ्र

  1. पायथन - पैंडास DataFrame के सबसेट का चयन कैसे करें पायथन - पैंडास DataFrame के सबसेट का चयन कैसे करें

    मान लीजिए हमारी CSV फ़ाइल की सामग्री Microsoft Excel में निम्नलिखित है:सबसे पहले, CSV फ़ाइल से डेटा पैंडास DataFrame में लोड करें:dataFrame = pd.read_csv(C:\\Users\\amit_\\Desktop\\SalesData.csv)सबसेट का चयन करने के लिए वर्गाकार ब्रैकेट का उपयोग करें। ब्रैकेट में कॉलम का उल्लेख करें और पूरे डेटासेट

  1. - Python Pandas - DataFrame Property: shape का उपयोग कैसे करें

    Products.csv file से data read करने और rows और columns की संख्या print करने के लिए Python program लिखें। फिर first ten rows के लिए product column value Car से match होने पर print करें। मान लें, आपके पास products.csv file है और rows और columns की संख्या और first ten rows के लिए product column value C