नियमित अभिव्यक्तियाँ (regex) पहली नज़र में जटिल लग सकती हैं, लेकिन वे पैटर्न मिलान और टेक्स्ट हेरफेर के लिए शक्तिशाली उपकरण हैं। Excel में, वे आपको जटिल पैटर्न के आधार पर डेटा खोजने, निकालने और बदलने की अनुमति देते हैं, जिससे डेटा सफाई, सत्यापन, और पार्सिंग जैसे कार्य बहुत अधिक कुशल हो जाते हैं। एक बार मूल बातें सीख लेने के बाद ये घंटों की सफाई, सत्यापन, और जानकारी निकालने की बचत कर सकते हैं। Regex का समर्थन करने के लिए, Excel REGEXTEST, REGEXEXTRACT, और REGEXREPLACE जैसे फ़ंक्शन प्रदान करता है।
यह Excel पावर यूजर्स के लिए हमारा Regex क्रैश कोर्स है।
Regex क्या है?
Regex (नियमित अभिव्यक्तियाँ) टेक्स्ट के लिए एक पैटर्न भाषा है। किसी सटीक शब्द को खोजने या मिलान करने के बजाय, regex आपको टेक्स्ट के आकार का वर्णन करने देता है। Excel में, regex एक सुपर-पावर्ड FIND + MID + SUBSTITUTE संयोजन की तरह है, जहां एक पैटर्न टेक्स्ट को मान्य, निकाल या साफ कर सकता है।
आप Excel में regex का उपयोग करके सामान्य संरचनाओं का मिलान कर सकते हैं: ईमेल पते, फोन नंबर, कई प्रारूपों में दिनांक, या कोई भी ID जो एक नियम का पालन करता हो।
आधुनिक Excel में, आप इसका उपयोग मुख्य रूप से इसके साथ करते हैं:
- REGEXTEST (जांचें कि कोई पैटर्न मौजूद है या नहीं)
- REGEXEXTRACT (मिलान करने वाला भाग निकालें)
- REGEXREPLACE (मिलान बदलें/साफ़ करें)
Regex मूल बातें: पैटर्न बनाना
Regex पैटर्न वे स्ट्रिंग हैं जो परिभाषित करते हैं कि आप क्या खोज रहे हैं। वे लिटरल वर्णों (जैसे "abc") को विशेष मेटाकैरेक्टर्स के साथ जोड़ते हैं। आप इस तालिका को त्वरित संदर्भ के रूप में उपयोग कर सकते हैं।
मुख्य मेटाकैरेक्टर्स और सिंटैक्स:
| बिल्डिंग ब्लॉक | अर्थ | त्वरित उदाहरण पैटर्न | मिलान |
|---|---|---|---|
| abc | लिटरल टेक्स्ट | TX- | TX- |
| . | कोई भी एकल वर्ण | a.c | abc, a-c |
| \d | अंक (0–9) | \d{4} | 2026 |
| \D | अंक नहीं | \D+ | TX- |
| \w | वर्ड कैरेक्टर (A–Z, a–z, 0–9, _) | \w+ | amina_01 |
| \W | वर्ड कैरेक्टर नहीं | \W+ | – ( ) . |
| \s | व्हाइटस्पेस | \s+ | स्पेस/टैब |
| \S | व्हाइटस्पेस नहीं | \S+ | user@domain |
| [ABC] | इनमें से एक वर्ण | [AEIOU] | A |
| [A-Z] | रेंज (अपरकेस) | [A-Z]{2} | TX |
| [a-z] | रेंज (लोअरकेस) | [a-z]+ | rahman |
| [0-9] | अंक रेंज | [0-9]+ | 1054 |
| [^0-9] | ये नहीं (नेगेटेड क्लास) | [^0-9]+ | TX- |
| * | 0 या अधिक | \d* | "", 7, 1054 |
| + | 1 या अधिक | \d+ | 7, 1054 |
| ? | वैकल्पिक (0 या 1) | -? | – या कुछ नहीं |
| {n} | ठीक n बार | \d{2} | 12 |
| {n,} | कम से कम n बार | \d{4,} | 202601 |
| {n,m} | n और m के बीच | \d{2,4} | 12, 2026 |
| ^ | टेक्स्ट की शुरुआत | ^TX- | TX-1054 (शुरुआत में) |
| $ | टेक्स्ट का अंत | \.com$ | .com से समाप्त होता है |
| \b | वर्ड बाउंड्री | \bTX-\d{4}\b | TX-1054 पूरा टोकन |
| ( … ) | कैप्चरिंग ग्रुप | (\d{4}) | 1054 कैप्चर करता है |
| (?: … ) | नॉन-कैप्चरिंग ग्रुप | (?:TX|CA)-\d{4} | TX-1054 या CA-1054 |
| \ | विशेष वर्णों से बचें | company\.com | लिटरल company.com |
| .* | कोई भी वर्ण (लालची) | \(.*\) | पहले ( से अंतिम ) तक मिलान |
| .*? | कोई भी वर्ण (गैर-लालची) | \(.*?\) | सबसे छोटा ( … ) मिलान |
| (?i) | केस-इनसेंसिटिव मोड (Excel regex पैटर्न में समर्थित नहीं; फ़ंक्शन के case_sensitivity तर्क का उपयोग करें) | — | REGEXTEST(text, pattern, 1) का उपयोग करें |
- क्वांटिफायर्स (*, +, ?, {}) उन पर लागू होते हैं जो उनसे पहले होते हैं।
- फ्लैग्स: Excel के regex फ़ंक्शन पैटर्न में (?i) जैसे इंलाइन फ्लैग्स का समर्थन नहीं करते; केस सेंसिटिविटी के लिए फ़ंक्शन तर्क का उपयोग करें (जैसे REGEXTEST का तीसरा तर्क), या कैरेक्टर क्लास का उपयोग करें (जैसे [Aa])।
- लालची बनाम आलसी: डिफ़ॉल्ट रूप से, क्वांटिफायर्स लालची होते हैं (जितना संभव हो उतना मिलान करें)। क्वांटिफायर के बाद ? जोड़कर इसे आलसी बनाएं (जैसे .*?)।
Excel के Regex फ़ंक्शन
Excel मूल रूप से तीन regex फ़ंक्शन प्रदान करता है। ये फ़ंक्शन एक टेक्स्ट स्ट्रिंग और एक नियमित अभिव्यक्ति पैटर्न को इनपुट के रूप में लेते हैं और पैटर्न के आधार पर टेक्स्ट को मान्य या ट्रांसफॉर्म करते हैं। कोर्स में गोता लगाने से पहले प्रत्येक फ़ंक्शन को जान लें।
सिंटैक्स:
=REGEXTEST(text, pattern, [case_sensitivity])
यह फ़ंक्शन जांचता है कि पैटर्न प्रदान किए गए टेक्स्ट के किसी भी भाग से मेल खाता है या नहीं। यदि पैटर्न टेक्स्ट में कहीं भी मेल खाता है तो TRUE लौटाता है; अन्यथा FALSE।
- text: वह टेक्स्ट या सेल संदर्भ जिसे आप टेस्ट करना चाहते हैं।
- pattern: वह नियमित अभिव्यक्ति (regex) पैटर्न जो उस टेक्स्ट का वर्णन करता है जिससे आप मिलान करना चाहते हैं।
- [case_sensitivity]: निर्धारित करता है कि मिलान केस-सेंसिटिव है या नहीं। डिफ़ॉल्ट रूप से, मिलान केस-सेंसिटिव होता है।
- 0: केस सेंसिटिव
- 1: केस इनसेंसिटिव
यह फ़ंक्शन TRUE लौटाता है यदि A1 में लगातार तीन अंक हैं।
सिंटैक्स:
=REGEXEXTRACT(text, pattern, [return_mode], [case_sensitivity])
यह फ़ंक्शन मिलान करने वाला टेक्स्ट निकालता है।
- [return_mode]: एक संख्या जो निर्दिष्ट करती है कि आप कौन से स्ट्रिंग निकालना चाहते हैं। डिफ़ॉल्ट रूप से, रिटर्न मोड 0 है।
- 0: पैटर्न से मेल खाने वाला पहला स्ट्रिंग लौटाएं
- 1: पैटर्न से मेल खाने वाले सभी स्ट्रिंग को एक सरणी के रूप में लौटाएं
- 2: पहले मिलान से कैप्चरिंग ग्रुप को एक सरणी के रूप में लौटाएं
=REGEXEXTRACT(A1, "\d{3}-\d{3}-\d{4}")
"123-456-7890" जैसे फोन नंबर निकालता है।
सिंटैक्स:
=REGEXREPLACE(text, pattern, replacement, [occurrence], [case_sensitivity])
यह फ़ंक्शन मिलान को नए टेक्स्ट से बदलता है।
- replacement: वह टेक्स्ट जिसे आप पैटर्न के स्थान पर उपयोग करना चाहते हैं। आप $1, $2, आदि के साथ कैप्चर ग्रुप को संदर्भित कर सकते हैं।
- occurrence: निर्दिष्ट करता है कि आप पैटर्न के किस उदाहरण को बदलना चाहते हैं। डिफ़ॉल्ट रूप से, घटना 0 है, जो सभी उदाहरणों को बदल देती है। एक नकारात्मक संख्या अंत से खोजकर उस उदाहरण को बदल देती है।
=REGEXREPLACE(A1, "\d{3}", "***")
हर तीन-अंकीय अनुक्रम को मास्क करता है।
ये फ़ंक्शन सरणियाँ लौटाने पर स्पिल करते हैं (जैसे, एकाधिक निष्कर्षण)।
Excel पावर यूजर्स के लिए व्यावहारिक उदाहरण
मान लें कि आपके पास गन्दा डेटा है। आइए सामान्य परिदृश्यों पर regex लागू करें।
उदाहरण 1: ईमेल पते मान्य करना
आप कंपनी ईमेल को फ़्लैग करने के लिए REGEXTEST का उपयोग कर सकते हैं (केस-इनसेंसिटिव मिलान अक्सर सुरक्षित होते हैं)।
ईमेल मान्य करने के लिए निम्न पैटर्न का उपयोग करें।
- पैटर्न: ^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$
=REGEXTEST(A2, "^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$")
अमान्य ईमेल हाइलाइट करने के लिए सशर्त स्वरूपण का उपयोग करें:
- Home टैब पर जाएं >> Conditional Formatting चुनें >> New Rule चुनें
- Use a formula to determine which cells to format चुनें
- निम्न सूत्र डालें
- Format चुनें >> एक भरण रंग चुनें >> OK पर क्लिक करें
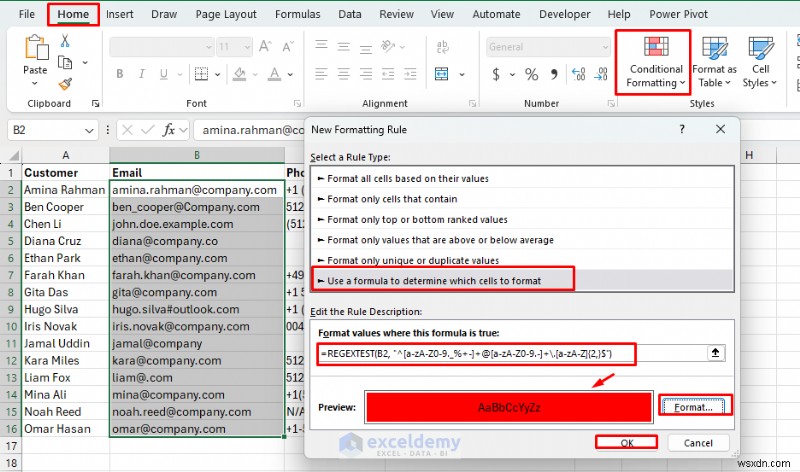
- अमान्य ईमेल पते लाल रंग में हाइलाइट हो जाएंगे
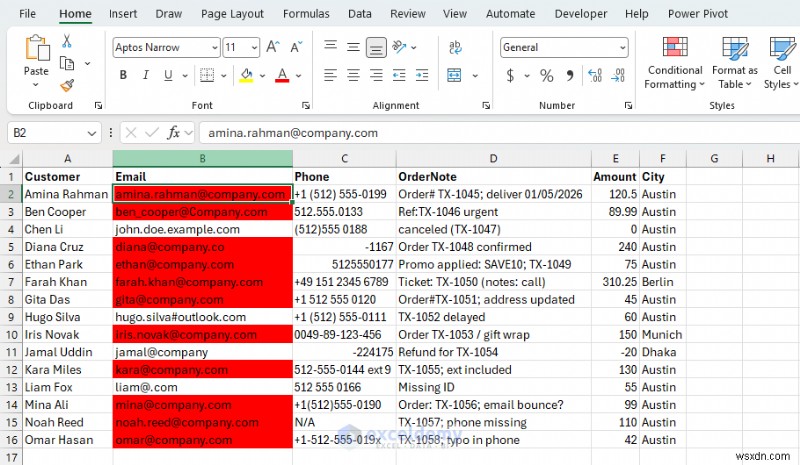
आप कंपनी ईमेल को फ़्लैग करने के लिए REGEXTEST का उपयोग भी कर सकते हैं।
=REGEXTEST(B2,"@company\.com$",1)
- तीसरा तर्क (1) मिलान को केस-इनसेंसिटिव बनाता है, इसलिए Company.com भी पास हो जाता है
- \. डॉट को एस्केप करता है। एक सादा . का अर्थ है "कोई भी वर्ण"
उदाहरण 2: गन्दे नोट्स से डेटा निकालना
मान लें कि आपके पास मिश्रित डेटा है, जैसे नोट्स में ऑर्डर ID या फोन नंबर। आप REGEXEXTRACT फ़ंक्शन का उपयोग करके फोन नंबर या ऑर्डर ID निकाल सकते हैं।
ऑर्डर ID निकालें:
=REGEXEXTRACT(D2,"TX-\d{4}")
- अगर कुछ पंक्तियों में यह नहीं है, तो IFERROR के साथ लपेटें:
=IFERROR(REGEXEXTRACT(D2,"TX-\d{4}"),"")
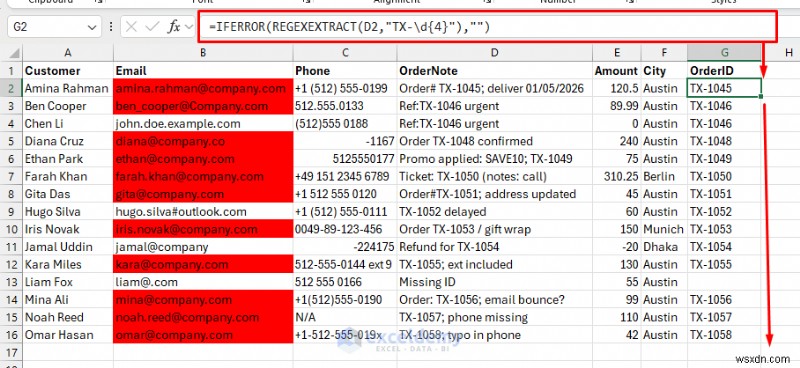
फोन नंबर निकालें:
- डेटा: "मुझे 123-456-7890 या (987) 654-3210 पर कॉल करें।"
- पैटर्न: (\d{3}[-. )]+){2}\d{4}
=REGEXEXTRACT(A2, "(\d{3}[-. )]+){2}\d{4}", 0, 1)
यह सूत्र टेक्स्ट से फोन नंबर निकालता है।
उदाहरण 3: गैर-अंकों को हटाकर फोन नंबर मानकीकृत करना
- पहले अंक-मात्र संस्करण बनाएं।
=REGEXREPLACE(C2,"[^\d]","")
- अब आप प्रारूपित कर सकते हैं (उदाहरण: अंतिम 10 अंकों को US नंबर के रूप में जब उपलब्ध हो):
=LET(x,REGEXREPLACE(C2,"[^\d]",""), d,RIGHT(x,10), IF(LEN(d)=10,"("&LEFT(d,3)&") "&MID(d,4,3)&"-"&RIGHT(d,4),""))
यह दृष्टिकोण सभी गैर-अंक वर्णों को हटा देता है और परिणामी फोन नंबर को प्रारूपित करता है।
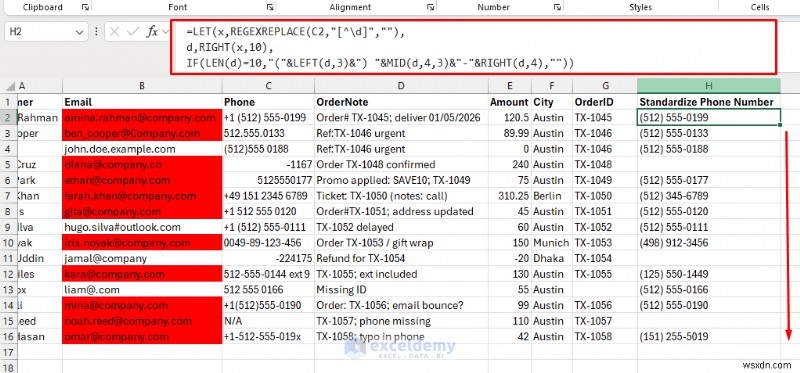
उदाहरण 4: दिनांक पार्स करना और पुन: प्रारूपित करना
आप regex का उपयोग करके दिनांक को पार्स और पुन: प्रारूपित कर सकते हैं।
- पैटर्न: (\d{1,2})/(\d{1,2})/(\d{4})
=REGEXREPLACE(A2, "(\d{1,2})/(\d{1,2})/(\d{4})", "$3-$2-$1")
यह सूत्र दिनांक को पार्स करता है और फिर इसे एक वैध ISO-जैसे प्रारूप में पुन: प्रारूपित करता है। आप प्रतिस्थापन में भागों को संदर्भित करने के लिए कैप्चर ग्रुप () का उपयोग भी कर सकते हैं।
उदाहरण 5: गन्दा डेटा साफ करना (जैसे, अतिरिक्त स्पेस हटाना)
आप regex का उपयोग गन्दा डेटा साफ करने के लिए कर सकते हैं, जैसे अतिरिक्त स्पेस हटाना और प्रारूपण सामान्य करना।
अतिरिक्त स्पेस हटाने के लिए, निम्न पैटर्न का उपयोग करें।
- पैटर्न: \s+
=REGEXREPLACE(A2, "\s+", " ")
यह सूत्र व्हाइटस्पेस के रन को एक स्पेस से बदल देता है।
उदाहरण 6: पैरेंथेसिस में कुछ भी हटाना (पैरेंथेसिस सहित)
- एक सेल चुनें और निम्न सूत्र डालें:
=REGEXREPLACE(D2,"\s*\(.*?\)","")
- .*? एक गैर-लालची मिलान है। यह अंतिम के बजाय पहले क्लोजिंग पैरेंथेसिस पर रुकता है।
यह सूत्र पैरेंथेसिस के भीतर सभी डेटा को हटा देता है, जिसमें पैरेंथेसिस स्वयं भी शामिल हैं।
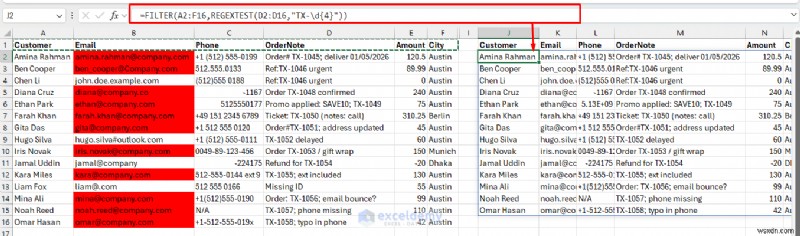
उदाहरण 7: ऑर्डर ID वाली पंक्तियों को फ़िल्टर करना
=FILTER(A2:F16,REGEXTEST(D2:D16,"TX-\d{4}"))
यह सूत्र regex पैटर्न के आधार पर डेटा फ़िल्टर करता है।
Excel में उन्नत Regex तकनीकें
- लुकअहेड/लुकबिहाइंड: टेक्स्ट का उपभोग किए बिना शर्तों का दावा करें।
- पॉजिटिव लुकअहेड: (?=…) जैसे, \d+(?=%)$ % चिह्न से पहले संख्याओं के लिए।
- REGEXEXTRACT में कीमतें निकालने के लिए उपयोग करें: \d+\.\d{2}(?=\sUSD)
- नॉन-कैप्चरिंग ग्रुप्स: कैप्चर किए बिना ग्रुपिंग के लिए (?:…)
- अल्टरनेशन: विकल्पों के लिए, जैसे, (http|https)://\S+ URLs के लिए।
- सरणियों को संभालना: यदि REGEXEXTRACT एकाधिक ग्रुप लौटाता है, तो INDEX या स्पिल रेंज का उपयोग करें।
- अन्य फ़ंक्शंस के साथ संयोजन: शक्तिशाली वर्कफ़्लोज़ के लिए IF, FILTER, या LAMBDA के साथ नेस्ट करें।
टिप्स और सर्वोत्तम अभ्यास
- पैटर्न टेस्ट करें: regex101.com जैसे ऑनलाइन टूल का उपयोग करें "ECMAScript" फ्लेवर के साथ (Excel के regex के सबसे करीब)।
- प्रदर्शन: बड़े डेटासेट पर regex धीमा हो सकता है; पहले नमूनों पर टेस्ट करें।
- त्रुटियां: यदि कोई मिलान नहीं है, तो REGEXEXTRACT #N/A लौटाता है; IFNA या IFERROR के साथ संभालें।
- सीमाएं: Excel का regex एक सबसेट पर आधारित है, बिना पूर्ण PCRE समर्थन के, इसलिए रिकर्सन जैसी उन्नत सुविधाओं से बचें।
- अधिक सीखें: वास्तविक डेटासेट के साथ अभ्यास करें। Regex उपयोग के साथ आसान हो जाता है!
प्रैक्टिस वर्कबुक डाउनलोड करें
समापन
Excel पावर यूजर्स हमारे regex क्रैश कोर्स का पालन करके डेटा सफाई, सत्यापन, और स्वचालन को तेज कर सकते हैं। एक बार जब आप बुनियादी बिल्डिंग ब्लॉक्स के साथ सहज हो जाते हैं, तो अधिक परिष्कृत पैटर्न मिलान के लिए लुकअहेड और लुकबिहाइंड का पता लगाएं। यह क्रैश कोर्स आपको शुरू करता है: पहले अभिव्यक्ति को समझें, फिर खाली वर्कबुक में पैटर्न के साथ प्रयोग करें। Regex Excel में आपके टेक्स्ट को संभालने के तरीके को बदल सकता है!
मुफ़्त उन्नत Excel अभ्यास समाधान के साथ प्राप्त करें!