एक्सेल डेटा प्रबंधन और विश्लेषण के लिए एक शक्तिशाली टूल है। यह त्वरित रिपोर्टिंग और गणनाओं के लिए आदर्श है, लेकिन जब काम गड़बड़, दोहराव वाला या बहुत बड़ा हो जाता है, तो पायथन मदद करता है। पायथन ऑटोमेशन, एडवांस्ड विश्लेषण और एकीकरण की संभावनाएं खोलता है जो एक्सेल की अंतर्निहित सुविधाओं से आगे जाती हैं। पैंडास जैसे पायथन लाइब्रेरी डेटा मैनिपुलेशन के लिए और ओपनपाइक्सेल एक्सेल फाइलों को सीधे हैंडल करने के लिए इस प्रक्रिया को सहज बनाते हैं।
इस ट्यूटोरियल में हम एक्सेल + पायथन से किए जा सकने वाले 5 कार्यों को दिखाएंगे।
पांच चीजों का पता लगाने के लिए नमूना बिक्री डेटा पर विचार करें जो आप एक्सेल और पायथन के साथ कर सकते हैं।
1. गन्दे एक्सेल डेटा को साफ और मानकीकृत करें (दोहराने योग्य तरीके से)
एक्सेल में गन्दा डेटा होना आम बात है, क्योंकि वास्तविक दुनिया का डेटा शायद ही कभी साफ होता है। अक्सर, डेटा में अतिरिक्त स्पेस, मिश्रित कैपिटलाइज़ेशन, टेक्स्ट के रूप में संग्रहीत संख्याएं, असंगत फॉर्मेटिंग, लापता मान, डुप्लिकेट एंट्री, या ऐसा डेटा होता है जिसे विश्लेषण से पहले पुनर्गठित करने की आवश्यकता होती है। यह समस्या फॉर्मूला और विश्लेषण को बर्बाद कर देती है।
पायथन डेटा-सफाई कार्यों में उत्कृष्ट है। आप ऐसे स्क्रिप्ट लिख सकते हैं जो विभिन्न फाइलों में डेटा फॉर्मेट को मानकीकृत करते हैं, इंटेलिजेंट तरीकों से लापता मान भरते हैं, डुप्लिकेट हटाते हैं, पैटर्न के आधार पर कॉलम को विभाजित या संयोजित करते हैं, और बिजनेस नियमों के विरुद्ध डेटा को मान्य करते हैं। इन चरणों के लिए एक्सेल में मैन्युअल फाइंड-एंड-रिप्लेस ऑपरेशन के घंटों की आवश्यकता हो सकती है। पायथन का उपयोग करके, आप एक दोहराने योग्य स्क्रिप्ट बना सकते हैं जो हजारों पंक्तियों को सेकंडों में संसाधित करता है।
मान लीजिए आपको गन्दा बिक्री डेटा प्राप्त हुआ। आइए एक पायथन स्क्रिप्ट का उपयोग करें जो गन्दा डेटा पढ़ती है, कॉलम को साफ और मानकीकृत करती है, और गणना किए गए फील्ड जोड़ती है।
- Revenue = Units * UnitPrice
- NetRevenue = Revenue * (1 – DiscountPct)
import pandas as pd
file_path = "SalesData.xlsx"
df = pd.read_excel(file_path, sheet_name="Sales Data")

# Clean types
df["Units"] = pd.to_numeric(df["Units"], errors="coerce").fillna(0).astype(int)
df["UnitPrice"] = pd.to_numeric(df["UnitPrice"], errors="coerce").fillna(0.0)
df["DiscountPct"] = pd.to_numeric(df["DiscountPct"], errors="coerce").fillna(0.0)
df["Returned"] = (
    df["Returned"].astype(str).str.strip().str.lower()
    .map({"yes": True, "no": False})
    .fillna(False)
)

# Add calculated fields
df["Revenue"] = df["Units"] * df["UnitPrice"]
df["NetRevenue"] = df["Revenue"] * (1 - df["DiscountPct"])

# Write back into the SAME file as a NEW sheet
with pd.ExcelWriter(file_path, engine="openpyxl", mode="a", if_sheet_exists="replace") as writer:
    df.to_excel(writer, sheet_name="CleanData", index=False)

print("Saved CleanData sheet inside:", file_path)
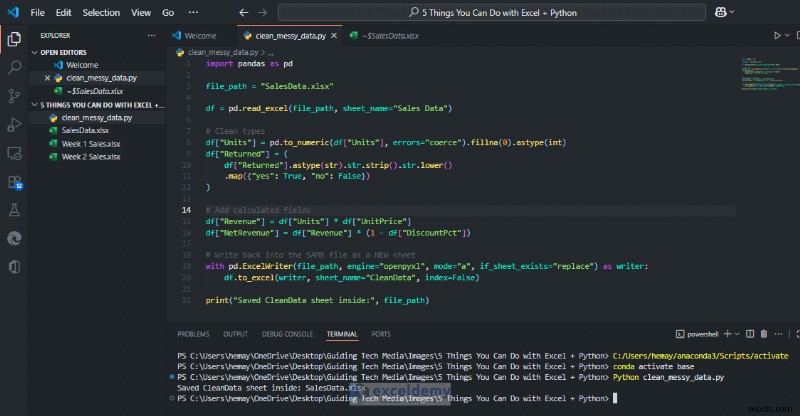
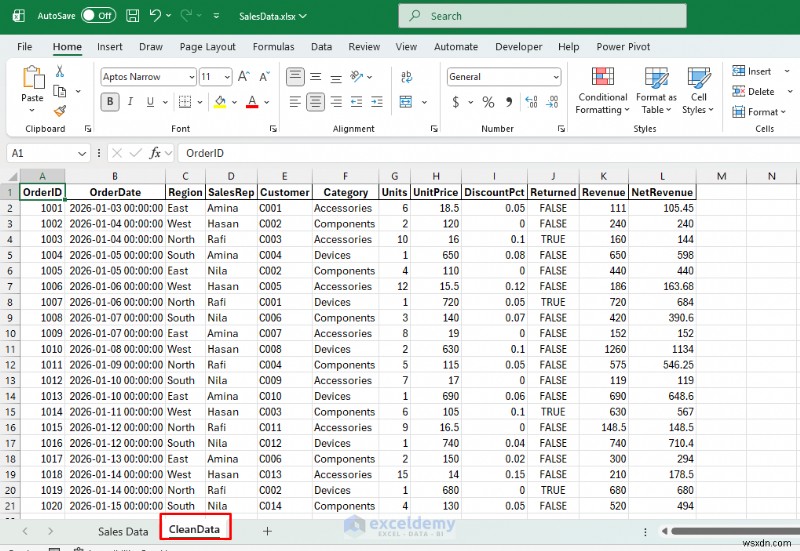
आपको एक नई शीट मिलेगी जिसमें एक साफ डेटासेट होगा जो पिवट, चार्ट या लुकअप को नहीं तोड़ेगा। एक्सेल में, आप साफ डेटा से पिवट/चार्ट का उपयोग जारी रख सकते हैं, यह जानते हुए कि यह हर रन में सुसंगत है।
2. स्वचालित रूप से सारांश बनाएं (दोहराने योग्य रिपोर्ट)
एक्सेल की पंक्ति सीमाएं हैं और जटिल गणनाओं के साथ यह धीमा हो सकता है। पायथन का पैंडास लाइब्रेरी बड़े डेटासेट को कुशलतापूर्वक संभालता है और गणना बहुत तेजी से करता है।
पैंडास के साथ, आप लाखों रिकॉर्ड वाले डेटासेट के साथ काम कर सकते हैं, जटिल ग्रुपिंग और एकत्रीकरण ऑपरेशन कर सकते हैं, और सांख्यिकीय विश्लेषण निष्पादित कर सकते हैं जो एक्सेल में अव्यावहारिक हो सकते हैं। पायथन पिवट-शैली के सारांश उत्पन्न कर सकता है और उन्हें एक्सेल में निर्यात कर सकता है। मान लीजिए आप क्षेत्र और श्रेणी के अनुसार एक त्वरित सारांश चाहते हैं, लेकिन आप हर बार पिवट को पुनर्निर्माण नहीं करना चाहते।
import pandas as pd
file_path = "SalesData.xlsx"
clean_sheet = "CleanData"
out_sheet = "Summary"
df = pd.read_excel(file_path, sheet_name=clean_sheet)
summary = (
    df.groupby(["Region", "Category"], as_index=False)
    .agg(
        Orders=("OrderID", "count"),
        Units=("Units", "sum"),
        NetRevenue=("NetRevenue", "sum"),
        Returns=("Returned", "sum")
    )
)
with pd.ExcelWriter(file_path, engine="openpyxl", mode="a", if_sheet_exists="replace") as writer:
    summary.to_excel(writer, sheet_name=out_sheet, index=False)
print(f"✅ Saved '{out_sheet}' sheet inside: {file_path}")
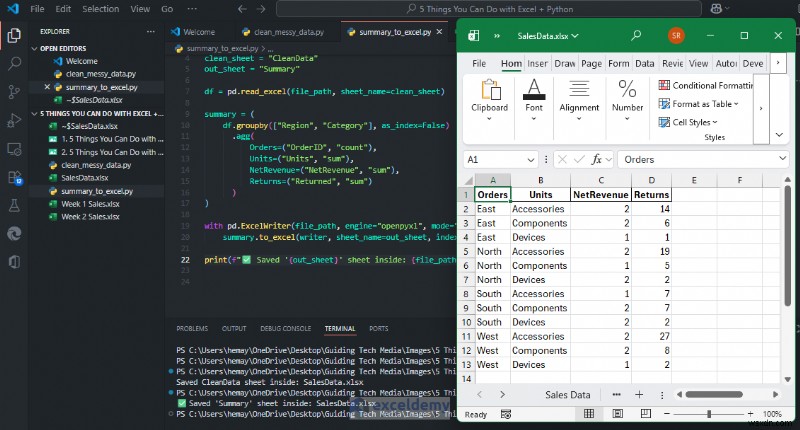
आपको क्षेत्र के अनुसार राजस्व सारांश मिलेगा—एक तैयार-से-साझा पिवट-शैली शीट जो जब भी आप स्क्रिप्ट को फिर से चलाते हैं तो अपडेट होती है।
3. एक्सेल डेटा से चार्ट उत्पन्न करें (मैन्युअल फॉर्मेटिंग के बिना)
चार्ट अक्सर रिपोर्टिंग का सबसे समय लेने वाला हिस्सा होते हैं। एक्सेल मानक चार्ट प्रदान करता है, लेकिन पायथन के विज़ुअलाइज़ेशन लाइब्रेरी जैसे मैटलप्लॉटलीब, सीबॉर्न, और प्लॉटली कहीं अधिक लचीलापन और परिष्कार प्रदान करते हैं। आप कस्टम विज़ुअलाइज़ेशन उत्पन्न कर सकते हैं जो आपके डेटा बदलने पर स्वचालित रूप से अपडेट होते हैं, इंटरैक्टिव डैशबोर्ड बना सकते हैं जिन्हें उपयोगकर्ता एक्सप्लोर कर सकते हैं, या प्रकाशन-गुणवत्ता वाले ग्राफिक्स बना सकते हैं जिनमें हर तत्व पर सटीक नियंत्रण होता है।
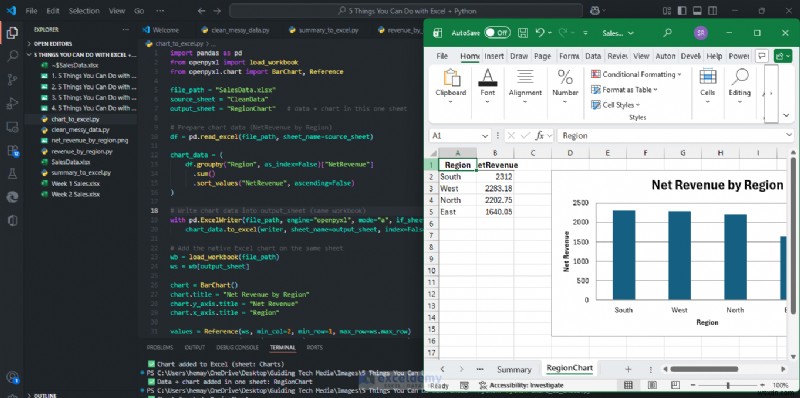
आइए क्षेत्र के अनुसार प्रदर्शन की कल्पना करें (क्षेत्र के अनुसार NetRevenue)।
import pandas as pd
from openpyxl import load_workbook
from openpyxl.chart import BarChart, Reference

file_path = "SalesData.xlsx"
source_sheet = "CleanData"
output_sheet = "RegionChart"

# Prepare chart data (NetRevenue by Region)
df = pd.read_excel(file_path, sheet_name=source_sheet)
chart_data = (
    df.groupby("Region", as_index=False)["NetRevenue"]
    .sum()
    .sort_values("NetRevenue", ascending=False)
)

# Write chart data into output_sheet (same workbook)
with pd.ExcelWriter(file_path, engine="openpyxl", mode="a", if_sheet_exists="replace") as writer:
    chart_data.to_excel(writer, sheet_name=output_sheet, index=False)

# Add the native Excel chart on the same sheet
wb = load_workbook(file_path)
ws = wb[output_sheet]
chart = BarChart()
chart.title = "Net Revenue by Region"
chart.y_axis.title = "Net Revenue"
chart.x_axis.title = "Region"
values = Reference(ws, min_col=2, min_row=1, max_row=ws.max_row)
labels = Reference(ws, min_col=1, min_row=2, max_row=ws.max_row)
chart.add_data(values, titles_from_data=True)
chart.set_categories(labels)
ws.add_chart(chart, "D2")  # place chart to the right of the data table
wb.save(file_path)
print(f"✅ Chart Created: {output_sheet}")
अब आपके पास क्षेत्र के अनुसार राजस्व सारांश के साथ एक बार चार्ट है।
4. कई एक्सेल फाइलों को एक मास्टर टेबल में मर्ज करें
साप्ताहिक, मासिक या त्रैमासिक डेटा को विभिन्न स्रोतों से मर्ज करना आम बात है। अलग-अलग लोगों या टीमों से एक्सेल फाइलों को मर्ज करना धीमा और त्रुटि-प्रवण होता है। पायथन उन्हें सेकंडों में जोड़ सकता है और स्रोत फाइल को ट्रैक कर सकता है।
आइए Weekly Reports/ नामक फ़ोल्डर में साप्ताहिक फाइलों को मर्ज करें (सभी समान कॉलम के साथ)।
import pandas as pd
from pathlib import Path

base_folder = Path(__file__).resolve().parent
folder = base_folder / "Weekly Reports"
files = sorted(folder.glob("*.xlsx"))
files = [f for f in files if not f.name.startswith("~$")]  # ignore Excel lock files

print("Looking in:", folder)
print("Files found:", [f.name for f in files])

frames = []
for f in files:
    temp = pd.read_excel(f)
    temp["SourceFile"] = f.name
    frames.append(temp)

master = pd.concat(frames, ignore_index=True)
master.to_excel(base_folder / "master_report.xlsx", index=False)
print("Saved: master_report.xlsx")
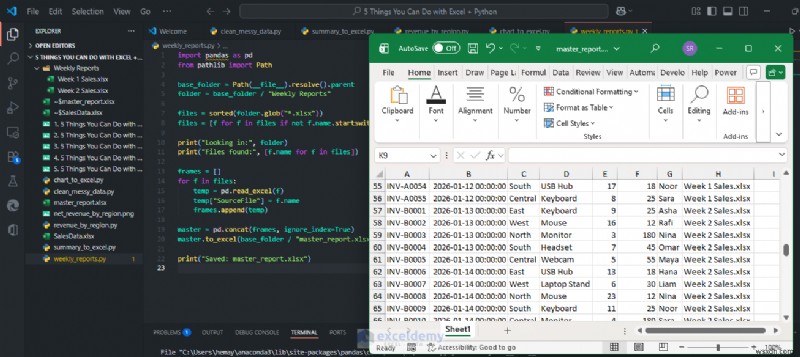
आपको ऑडिटिंग के लिए SourceFile कॉलम के साथ एक समेकित तालिका मिलेगी। हर हफ्ते, आपको बस स्क्रिप्ट चलाने की आवश्यकता है।
5. कुछ ऐसा पूर्वानुमान लगाएं जो एक्सेल आसानी से नहीं कर सकता (मशीन लर्निंग उदाहरण)
आप पैटर्न (छूट, श्रेणी, इकाइयां, मूल्य) का उपयोग करके वापसी जोखिम का अनुमान लगा सकते हैं, फिर संभावनाओं को वापस लिख सकते हैं ताकि एक्सेल उपयोगकर्ता फ़िल्टर और सॉर्ट कर सकें। पायथन ऐसे मशीन लर्निंग ऑपरेशन आसानी से कर सकता है।
हमारा एक छोटा डेटासेट है; फिर भी, यह वर्कफ़्लो दिखाता है।
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression

file_path = "SalesData.xlsx"
df = pd.read_excel(file_path, sheet_name="CleanData")

X = df[["Region", "SalesRep", "Category", "Units", "UnitPrice", "DiscountPct"]]
y = df["Returned"].astype(int)

cat_cols = ["Region", "SalesRep", "Category"]
num_cols = ["Units", "UnitPrice", "DiscountPct"]

preprocess = ColumnTransformer(
    transformers=[
        ("cat", OneHotEncoder(handle_unknown="ignore"), cat_cols),
        ("num", "passthrough", num_cols),
    ]
)

model = Pipeline(steps=[
    ("prep", preprocess),
    ("clf", LogisticRegression(max_iter=1000))
])

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model.fit(X_train, y_train)

# Predict probability of return for all rows
df["ReturnProb"] = model.predict_proba(X)[:, 1]

with pd.ExcelWriter(file_path, engine="openpyxl", mode="a", if_sheet_exists="replace") as writer:
    df.to_excel(writer, sheet_name="WithReturnRisk", index=False)
एक्सेल में, WithReturnRisk का पता लगाएं और ReturnProb को उच्च से निम्न तक फ़िल्टर करें यह देखने के लिए कि कौन से ऑर्डर जोखिम भरे लगते हैं।
एक्सेल में पायथन (यदि आपके एक्सेल में उपलब्ध है)
यदि आपके कंप्यूटर पर एक्सेल में पायथन (पूर्वावलोकन) है, तो आप सीधे एक सेल में पायथन चला सकते हैं और परिणाम को शीट पर वापस कर सकते हैं। (माइक्रोसॉफ्ट के एक्सेल में पायथन का अवलोकन देखें।) यहां एक सरल उदाहरण है जो एक छोटी रेंज पढ़ता है, टेक्स्ट साफ करता है, राजस्व की गणना करता है, और एक साफ तालिका लौटाता है।
- एक्सेल में, अपना डेटासेट दर्ज करें
- एक खाली सेल पर क्लिक करें
- फॉर्मूला टैब >> इन्सर्ट पायथन चुनें
- पायथन स्क्रिप्ट पेस्ट करें
import pandas as pd
# Read the Excel range A1:J21 (including headers)
df = xl("A1:J21", headers=True)

# Clean text columns
for col in ["Region", "SalesRep"]:
    df[col] = df[col].astype(str).str.strip().str.title()

# Fix data types
df["OrderDate"] = pd.to_datetime(df["OrderDate"], errors="coerce")
df["Units"] = pd.to_numeric(df["Units"], errors="coerce").fillna(0).astype(int)
df["UnitPrice"] = pd.to_numeric(df["UnitPrice"], errors="coerce").fillna(0.0)

# Add a calculated column
df["Revenue"] = df["Units"] * df["UnitPrice"]
df
यह DataFrame लौटाएगा, जो पायथन का टेबल ऑब्जेक्ट है। एक्सेल इसे टेबल पूर्वावलोकन (और एक कार्ड) के रूप में दिखाता है।
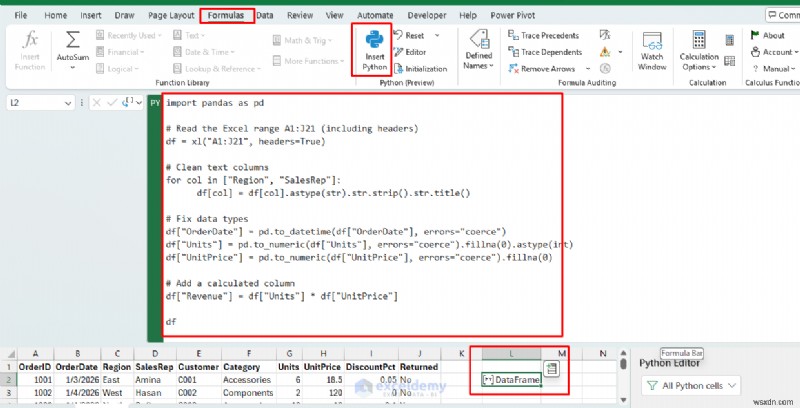
अब आउटपुट को सेल में "स्पिल" करें एक साफ टेबल के रूप में।
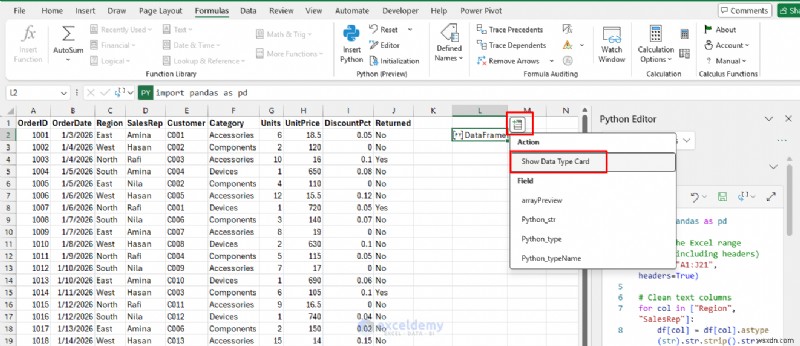
- इन्सर्ट डेटा पर क्लिक करें DataFrame से >> शो डेटाटाइप कार्ड चुनें टेबल का पूर्वावलोकन करने के लिए
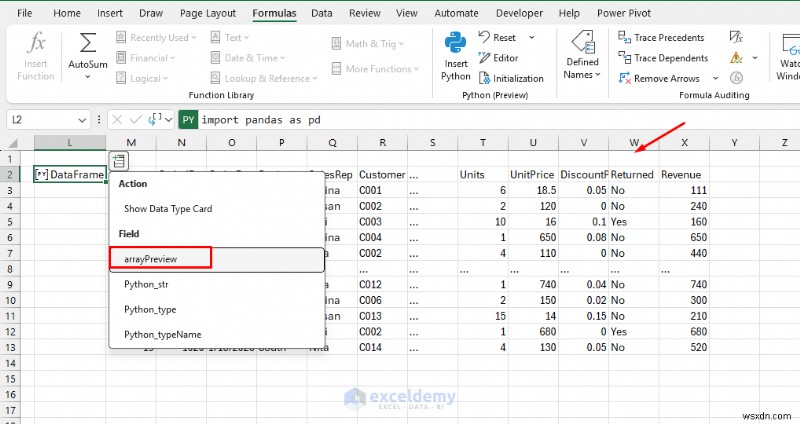
- arrayPreview चुनें टेबल को एक्सेल में लाने के लिए
- अब आपके पास मानकीकृत टेक्स्ट और एक नया Revenue कॉलम है
निष्कर्ष
यह लेख एक्सेल + पायथन के साथ आप 5 चीजें कर सकते हैं दिखाता है। पायथन के साथ एक्सेल अधिक शक्तिशाली हो जाता है; गन्दे डेटासेट को साफ करना, पिवट-शैली के सारांश उत्पन्न करना, चार्ट को स्वचालित करना, कई एक्सेल फाइलों को मर्ज करना, और सरल मशीन लर्निंग अंतर्दृष्टि जोड़ना आसान हो जाता है। एक्सेल और पायथन को मिलाने से वर्कफ़्लो सुव्यवस्थित होते हैं, डेटा आयात/निर्यात से लेकर ऑटोमेशन और विज़ुअलाइज़ेशन तक। छोटे स्क्रिप्ट से शुरू करें, और अधिक लाइब्रेरी के साथ प्रयोग करें।
मुफ्त एडवांस्ड एक्सेल अभ्यास समाधान के साथ प्राप्त करें!