यदि आप एक्सेल का बहुत उपयोग करते हैं, तो आप शायद उस स्थिति में आ चुके हैं जहां आपके पास एक सेल में एक नाम है और आपको नाम को अलग-अलग सेल्स में अलग करने की आवश्यकता है। यह एक्सेल में एक बहुत ही सामान्य समस्या है और आप शायद गूगल खोज कर सकते हैं और विभिन्न लोगों द्वारा लिखे गए 100 अलग-अलग मैक्रोज़ डाउनलोड कर सकते हैं जो इसे आपके लिए कर देंगे।
हालांकि, इस पोस्ट में, मैं आपको दिखाऊंगा कि सूत्र कैसे सेट करें ताकि आप इसे स्वयं कर सकें और वास्तव में समझ सकें कि क्या हो रहा है। यदि आप एक्सेल का बहुत उपयोग करते हैं, तो कुछ अधिक उन्नत फ़ंक्शंस सीखना शायद एक अच्छा विचार है ताकि आप अपने डेटा के साथ अधिक दिलचस्प चीजें कर सकें।
यदि आपको सूत्र पसंद नहीं हैं और एक त्वरित समाधान चाहते हैं, तो टेक्स्ट टू कॉलम्स अनुभाग पर नीचे स्क्रॉल करें, जो आपको सिखाता है कि एक्सेल फीचर का उपयोग करके वही काम कैसे करें। इसके अलावा, टेक्स्ट टू कॉलम्स फीचर तब भी बेहतर है जब आपके पास एक सेल में दो से अधिक आइटम हों जिन्हें आपको अलग करने की आवश्यकता हो। उदाहरण के लिए, यदि एक कॉलम में 6 फ़ील्ड एक साथ संयुक्त हैं, तो उपरोक्त सूत्रों का उपयोग करना वास्तव में गन्दा और जटिल हो जाएगा।
एक्सेल में नाम अलग करें
शुरू करने के लिए, आइए देखें कि नाम आमतौर पर एक्सेल स्प्रेडशीट में कैसे संग्रहीत किए जाते हैं। मैंने जो दो सबसे आम तरीके देखे हैं वे हैं firstname lastname केवल एक स्पेस के साथ और lastname, firstname एक कॉमा से अलग। जब भी मैंने मिडिल इनिशियल देखा है, यह आमतौर पर नीचे की तरह firstname midinitial lastname होता है:
कुछ सरल सूत्रों का उपयोग करके और उनमें से कुछ को मिलाकर, आप आसानी से पहले नाम, अंतिम नाम और मिडिल इनिशियल को एक्सेल में अलग-अलग सेल्स में अलग कर सकते हैं। पहले नाम के पहले भाग को निकालने से शुरू करते हैं। मेरे मामले में, हम दो फ़ंक्शंस का उपयोग करने जा रहे हैं: लेफ्ट और सर्च। तार्किक रूप से हमें यह करने की आवश्यकता है:
सेल में टेक्स्ट में स्पेस या कॉमा खोजें, स्थिति ढूंढें और फिर उस स्थिति के बाईं ओर के सभी अक्षरों को निकाल लें।
यहां एक सरल सूत्र है जो काम को सही ढंग से करता है: =LEFT(NN, SEARCH(” “, NN) – 1), जहां NN वह सेल है जिसमें नाम संग्रहीत है। -1 स्ट्रिंग के अंत में अतिरिक्त स्पेस या कॉमा को हटाने के लिए है।
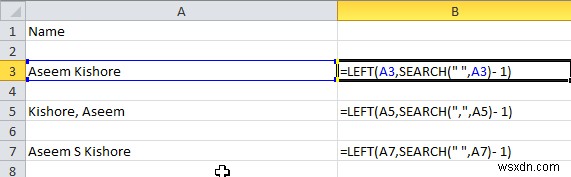
जैसा कि आप देख सकते हैं, हम लेफ्ट फ़ंक्शन से शुरू करते हैं, जो दो आर्गुमेंट लेता है: स्ट्रिंग और स्ट्रिंग की शुरुआत से आप कितने कैरेक्टर्स लेना चाहते हैं। पहले मामले में, हम डबल कोट्स का उपयोग करके और उनके बीच एक स्पेस डालकर स्पेस खोजते हैं। दूसरे मामले में, हम स्पेस के बजाय कॉमा ढूंढ रहे हैं। तो मेरे द्वारा उल्लिखित 3 परिदृश्यों का परिणाम क्या है?
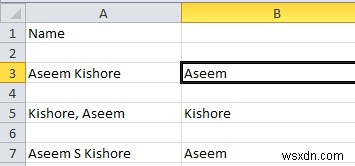
हमें पंक्ति 3 से पहला नाम, पंक्ति 5 से अंतिम नाम और पंक्ति 7 से पहला नाम मिला। बढ़िया! तो इस आधार पर कि आपका डेटा कैसे संग्रहीत है, आपने अब या तो पहला नाम या अंतिम नाम निकाल लिया है। अब अगले भाग के लिए। यहां हमें तार्किक रूप से अब क्या करने की आवश्यकता है:
– सेल में टेक्स्ट में स्पेस या कॉमा खोजें, स्थिति ढूंढें और फिर स्ट्रिंग की कुल लंबाई से स्थिति घटाएं। यहां सूत्र कैसा दिखेगा:
=RIGHT(NN,LEN(NN) -SEARCH(” “,NN))
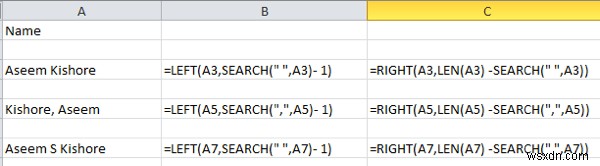
तो अब हम राइट फ़ंक्शन का उपयोग करते हैं। यह दो आर्गुमेंट भी लेता है: स्ट्रिंग और स्ट्रिंग के अंत से बाएं जाते हुए आप कितने कैरेक्टर्स लेना चाहते हैं। तो हम स्ट्रिंग की लंबाई घटा स्पेस या कॉमा की स्थिति चाहते हैं। यह हमें पहले स्पेस या कॉमा के दाईं ओर सब कुछ देगा।
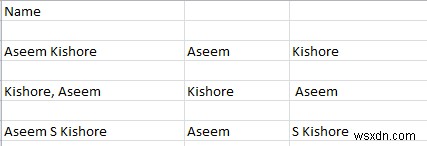
बढ़िया, अब हमारे पास नाम का दूसरा भाग है! पहले दो मामलों में, आप बहुत ज्यादा हो चुके हैं, लेकिन अगर नाम में मिडिल इनिशियल है, तो आप देख सकते हैं कि परिणाम में अभी भी मिडिल इनिशियल के साथ अंतिम नाम शामिल है। तो हम सिर्फ अंतिम नाम कैसे प्राप्त करें और मिडिल इनिशियल से छुटकारा पाएं? आसान! बस वही सूत्र फिर से चलाएं जिसे हमने नाम के दूसरे भाग को प्राप्त करने के लिए इस्तेमाल किया था।
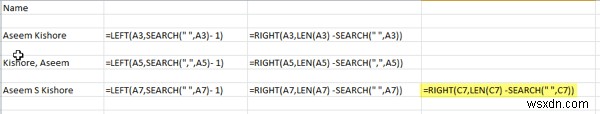
तो हम बस एक और राइट कर रहे हैं और इस बार संयुक्त मिडिल इनिशियल और अंतिम नाम सेल पर सूत्र लागू कर रहे हैं। यह मिडिल इनिशियल के बाद स्पेस ढूंढेगा और फिर स्ट्रिंग के अंत से स्पेस की स्थिति घटाकर लंबाई के कैरेक्टर्स ले लेगा।
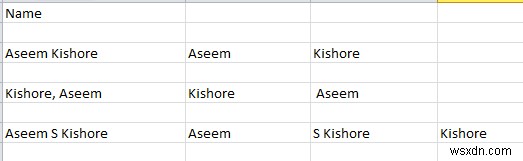
तो वहां आपके पास है! आपने अब एक्सेल में कुछ सरल सूत्रों का उपयोग करके पहले नाम और अंतिम नाम को अलग-अलग कॉलम में विभाजित कर लिया है! जाहिर है, हर किसी का टेक्स्ट इस तरह फॉर्मेट नहीं होगा, लेकिन आप इसे आसानी से अपनी आवश्यकताओं के अनुरूप संपादित कर सकते हैं।
टेक्स्ट टू कॉलम्स
संयुक्त टेक्स्ट को एक्सेल में अलग-अलग कॉलम में अलग करने का एक और आसान तरीका भी है। इसे टेक्स्ट टू कॉलम्स कहा जाता है और यह बहुत अच्छी तरह से काम करता है। यदि आपके पास एक कॉलम है जिसमें दो से अधिक डेटा के टुकड़े हैं तो यह बहुत अधिक कुशल है।
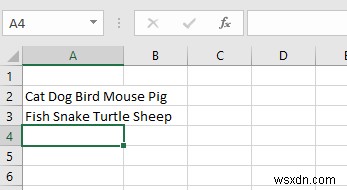
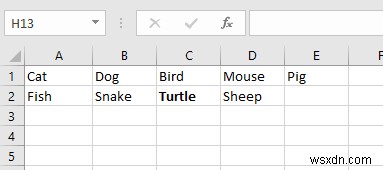
उदाहरण के लिए, नीचे मेरे पास कुछ डेटा है जहां एक पंक्ति में 4 डेटा के टुकड़े हैं और दूसरी पंक्ति में 5 डेटा के टुकड़े हैं। मैं इसे क्रमशः 4 कॉलम और 5 कॉलम में विभाजित करना चाहता हूं। जैसा कि आप देख सकते हैं, उपरोक्त सूत्रों का उपयोग करना अव्यावहारिक होगा।
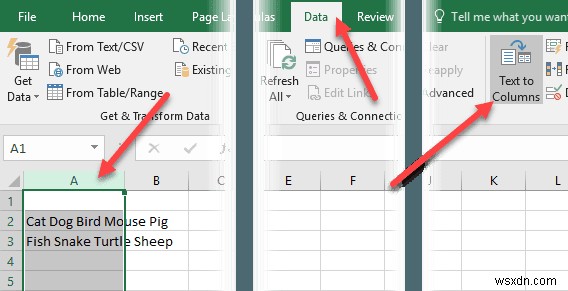
एक्सेल में, पहले उस कॉलम का चयन करें जिसे आप अलग करना चाहते हैं। फिर, आगे बढ़ें और डेटा टैब पर क्लिक करें और फिर टेक्स्ट टू कॉलम्स पर क्लिक करें।
यह टेक्स्ट टू कॉलम्स विज़ार्ड लाएगा। चरण 1 में, आप चुनते हैं कि फ़ील्ड डिलीमिटेड है या फिक्स्ड विड्थ। हमारे मामले में, हम डिलीमिटेड चुनेंगे।
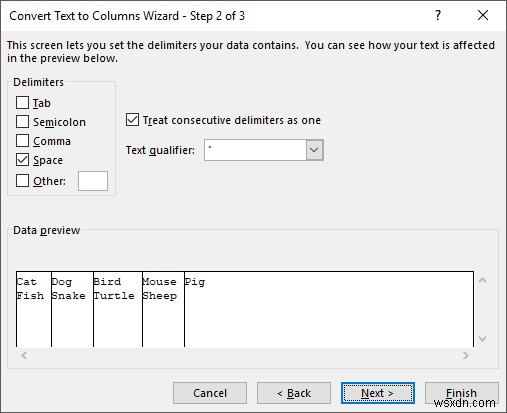
अगली स्क्रीन पर, आप डिलीमीटर चुनेंगे। आप टैब, सेमीकोलन, कॉमा, स्पेस चुन सकते हैं या एक कस्टम टाइप कर सकते हैं।
अंत में, आप कॉलम के लिए डेटा फॉर्मेट चुनते हैं। आमतौर पर, जनरल अधिकांश प्रकार के डेटा के लिए ठीक काम करेगा। यदि आपके पास डेट्स जैसा कुछ विशिष्ट है, तो वह फॉर्मेट चुनें।
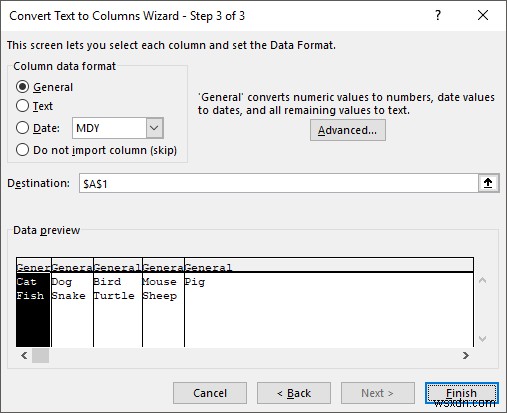
फिनिश पर क्लिक करें और देखें कि आपका डेटा जादुई रूप से कॉलम में कैसे अलग हो जाता है। जैसा कि आप देख सकते हैं, एक पंक्ति पांच कॉलम में बदल गई और दूसरी चार कॉलम में। टेक्स्ट टू कॉलम्स फीचर बहुत शक्तिशाली है और आपका जीवन बहुत आसान बना सकता है।
यदि आपको मेरे द्वारा ऊपर बताए गए फॉर्मेट में नहीं होने वाले नामों को अलग करने में समस्या आ रही है, तो अपने डेटा के साथ एक कमेंट पोस्ट करें और मैं मदद करने की कोशिश करूंगा। आनंद लें!