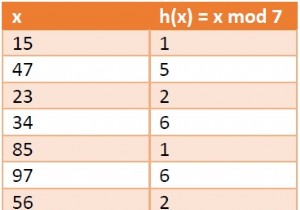
यहाँ हम विभाजन के साथ हैशिंग पर चर्चा करेंगे। इसके लिए हम हैश फ़ंक्शन का उपयोग करते हैं:
h(x) = x mod m
इस हैश फ़ंक्शन का उपयोग करने के लिए हम एक सरणी A[0, … m – 1] बनाए रखते हैं। जहाँ सरणी का प्रत्येक तत्व लिंक्ड सूची के हेड का पॉइंटर होता है। लिंक्ड सूची Li जिसे सरणी तत्व A[i] द्वारा इंगित किया जाता है, उन सभी तत्वों x को रखती है जैसे कि h(x) = i। इस तकनीक को चेनिंग द्वारा हैशिंग (hashing by chaining) के रूप में जाना जाता है।
ऐसी हैश टेबल में, यदि हम एक तत्व x सम्मिलित करना चाहते हैं, तो इसमें O(1) समय लगेगा। हम इंडेक्स i = h(x) की गणना करते हैं। फिर x को सूची Li में जोड़ते (append या prepend) हैं। यदि हम किसी तत्व को खोजना या हटाना चाहते हैं, तो वह प्रक्रिया इतनी आसान नहीं है। हमें इंडेक्स i = h(x) ढूंढना होगा। फिर सूची Li को पार करना होगा। जब तक हम वांछित मान तक नहीं पहुँच जाते या सूची समाप्त नहीं हो जाती। यह संक्रिया सूची Li के आकार के अनुरूप समय लेती है। यदि हमारा समुच्चय S में 0, m, 2m, 3m, …, nm तत्व हैं, तो L0 में संग्रहीत सभी तत्व खोजने और हटाने में रैखिक समय लेंगे।
इस प्रकार की स्थिति बहुत दुर्लभ है। उदाहरण के लिए, यदि S सार्वभौमिक समुच्चय U में समान रूप से और स्वतंत्र रूप से वितरित हैं, और u, m का गुणक है, तो प्रत्येक सूची Li का अपेक्षित आकार केवल n/m है। इस मामले में खोज और हटाने में O(1 + α) समय लगता है। उल्लिखित परिदृश्य से बचने के लिए, हमें m को बुद्धिमानी से चुनना होगा। आमतौर पर, हम m को 2 की घात के रूप में लेने से बचते हैं। m को एक अभाज्य संख्या (prime) के रूप में लेना अनुशंसित है जो 2 की घात के बहुत करीब न हो।