डेटा प्री-प्रोसेसिंग मूल रूप से सभी डेटा (जो विभिन्न संसाधनों या एकल संसाधन से एकत्र किया गया है) को एक सामान्य प्रारूप में या समान डेटासेट में इकट्ठा करने का कार्य है (डेटा के प्रकार के आधार पर)। चूंकि वास्तविक दुनिया का डेटा कभी भी आदर्श नहीं होता, इसलिए संभावना है कि डेटा में लापता सेल, त्रुटियां, आउटलायर, कॉलम में विसंगतियां, और बहुत कुछ हो। कभी-कभी, इमेज सही ढंग से संरेखित नहीं हो सकती हैं, या स्पष्ट नहीं हो सकती हैं या बहुत बड़े आकार की हो सकती हैं। प्री-प्रोसेसिंग का लक्ष्य इन विसंगतियों और त्रुटियों को दूर करना है।
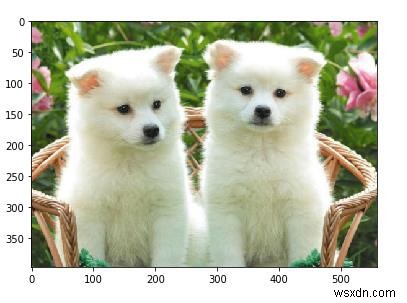
इमेज का रिज़ॉल्यूशन प्राप्त करने के लिए, 'शेप' नामक एक बिल्ट-इन फ़ंक्शन का उपयोग किया जाता है। इमेज पढ़ने के बाद, पिक्सेल मान एक ऐरे के रूप में संग्रहीत होते हैं। यह ऐरे Numpy ऐरे के अलावा कुछ नहीं है। एक बार इमेज पढ़ ली जाए और ऐरे में बदल जाए, तो इस इमेज पर शेप फ़ंक्शन कहा जा सकता है ताकि इसके रिज़ॉल्यूशन को समझा जा सके।
आइए scikit-learn लाइब्रेरी का उपयोग करके एक इमेज अपलोड करने और कंसोल पर इमेज का रिज़ॉल्यूशन प्राप्त करने का उदाहरण लेते हैं -
उदाहरण
from skimage import io
path = "path to puppy.PNG"
img = io.imread(path)
print("इमेज पढ़ी जा रही है")
io.imshow(img)
print("इमेज कंसोल पर प्रिंट हुई")
print("इमेज का रिज़ॉल्यूशन है")
print(img.shape)
आउटपुट
इमेज पढ़ी जा रही है
इमेज कंसोल पर प्रिंट हुई
इमेज का रिज़ॉल्यूशन है (397, 558, 4)
व्याख्या
- आवश्यक लाइब्रेरी आयात की गई हैं।
- वह पथ परिभाषित किया गया है जहां इमेज संग्रहीत है।
- 'imread' फ़ंक्शन का उपयोग पथ पर जाकर इमेज पढ़ने के लिए किया जाता है।
- 'imshow' फ़ंक्शन का उपयोग कंसोल पर इमेज प्रदर्शित करने के लिए किया जाता है।
- इमेज का रिज़ॉल्यूशन प्राप्त करने के लिए 'शेप' फ़ंक्शन का उपयोग किया जाता है।
- आउटपुट का तीसरा मान 4 दिखाता है, जिसका अर्थ है कि इसमें 4 चैनल हैं - R, G, B और अल्फा मान।
- डेटा कंसोल पर प्रदर्शित होता है।