Scikit-learn, जिसे आमतौर पर sklearn के नाम से जाना जाता है, Python में एक लाइब्रेरी है जिसका उपयोग मशीन लर्निंग एल्गोरिदम को लागू करने के लिए किया जाता है।
यह एक ओपन-सोर्स लाइब्रेरी है इसलिए इसका उपयोग मुफ्त में किया जा सकता है। शक्तिशाली और मजबूत, क्योंकि यह सांख्यिकीय मॉडलिंग करने के लिए विभिन्न प्रकार के टूल प्रदान करता है। इसमें एक शक्तिशाली और स्थिर Python इंटरफेस की मदद से वर्गीकरण, रिग्रेशन, क्लस्टरिंग, डायमेंशनलिटी रिडक्शन, और बहुत कुछ शामिल है। यह लाइब्रेरी Numpy, SciPy और Matplotlib लाइब्रेरी पर निर्मित है।
इसे 'pip' कमांड का उपयोग करके नीचे दिखाए अनुसार इंस्टॉल किया जा सकता है -
pip install scikit-learn
यह लाइब्रेरी डेटा मॉडलिंग पर केंद्रित है।
Scikit-learn में कई मॉडल उपयोग किए जाते हैं, और उनमें से कुछ को नीचे संक्षेप में प्रस्तुत किया गया है।
सुपरवाइज्ड लर्निंग एल्गोरिदम
सुपरवाइज्ड लर्निंग एल्गोरिदम को एक निश्चित तरीके से व्यवहार करना सिखाया जाता है। एक निश्चित वांछनीय आउटपुट को दिए गए इनपुट पर मैप किया जाता है जिससे मानव पर्यवेक्षण प्रदान होता है। यह इनपुट डेटासेट में मौजूद फीचर्स (वेरिएबल्स) को लेबल करके, डेटा को फीडबैक प्रदान करके (क्या आउटपुट एल्गोरिदम द्वारा सही ढंग से भविष्यवाणी की गई थी, और यदि नहीं तो सही भविष्यवाणी क्या होनी चाहिए) और इसी तरह किया जा सकता है।
एक बार एल्गोरिदम ऐसे इनपुट डेटा पर पूरी तरह से प्रशिक्षित हो जाने पर, इसे समान प्रकार के डेटा के लिए सामान्यीकृत किया जा सकता है। यदि प्रशिक्षित मॉडल में अच्छे प्रदर्शन मेट्रिक्स हैं तो यह पहले कभी न देखे गए इनपुट के लिए परिणामों की भविष्यवाणी करने की क्षमता प्राप्त कर लेगा। यह एक महंगा लर्निंग एल्गोरिदम है क्योंकि मनुष्यों को भौतिक रूप से इनपुट डेटासेट को लेबल करने की आवश्यकता होती है जिससे अतिरिक्त लागत जुड़ जाती है।
Sklearn रैखिक रिग्रेशन, सपोर्ट वेक्टर मशीन, डिसीजन ट्री, और इसी तरह को लागू करने में मदद करता है।
अनसुपरवाइज्ड लर्निंग
यह सुपरवाइज्ड लर्निंग के विपरीत है, यानी इनपुट डेटासेट लेबल नहीं किया गया है, जिससे शून्य मानव पर्यवेक्षण इंगित होता है। एल्गोरिदम ऐसे अनलेबल्ड डेटा से सीखता है, पैटर्न निकालता है, भविष्यवाणियां करता है, डेटा में अंतर्दृष्टि देता है और अपने दम पर अन्य ऑपरेशन करता है। अधिकांश समय, वास्तविक दुनिया का डेटा असंरचित और अनलेबल्ड होता है।
Sklearn क्लस्टरिंग, फैक्टर एनालिसिस, प्रिंसिपल कंपोनेंट एनालिसिस, न्यूरल नेटवर्क, और इसी तरह को लागू करने में मदद करता है।
क्लस्टरिंग
समान डेटा को एक संरचना में समूहित किया जाता है और कोई भी शोर (आउटलायर या असामान्य डेटा) इस क्लस्टर के बाहर आ जाएगा जिसे बाद में समाप्त या नजरअंदाज किया जा सकता है।
क्रॉस वैलिडेशन
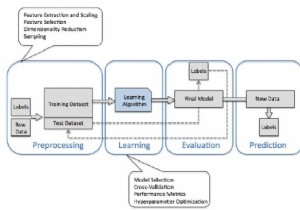
यह एक प्रक्रिया है जिसमें मूल डेटासेट को दो भागों में विभाजित किया जाता है - 'ट्रेनिंग डेटासेट' और 'टेस्टिंग डेटासेट'। जब क्रॉस-वैलिडेशन का उपयोग किया जाता है तो 'वैलिडेशन डेटासेट' की आवश्यकता समाप्त हो जाती है। 'क्रॉस-वैलिडेशन' विधि की कई विविधताएं हैं। सबसे अधिक उपयोग की जाने वाली क्रॉस-वैलिडेशन विधि 'k' फोल्ड क्रॉस-वैलिडेशन है।
डायमेंशनलिटी रिडक्शन
डायमेंशनलिटी रिडक्शन उन तकनीकों के बारे में बताता है जिनका उपयोग डेटासेट में फीचर्स की संख्या को कम करने के लिए किया जाता है। यदि किसी डेटासेट में फीचर्स की संख्या अधिक है, तो एल्गोरिदम को मॉडल करना अक्सर मुश्किल होता है। यदि इनपुट डेटासेट में बहुत सारे वेरिएबल हैं, तो मशीन लर्निंग एल्गोरिदम के प्रदर्शन में काफी गिरावट आ सकती है।
फीचर स्पेस में बड़ी संख्या में डायमेंशन होने के लिए बड़ी मात्रा में मेमोरी की आवश्यकता होती है, और इसका मतलब है कि सभी डेटा को स्पेस (डेटा की पंक्तियों) पर उपयुक्त रूप से प्रस्तुत नहीं किया जा सकता है। इसका मतलब है, मशीन लर्निंग एल्गोरिदम का प्रदर्शन प्रभावित होगा, और इसे 'डायमेंशनलिटी का अभिशाप' के रूप में भी जाना जाता है। इसलिए डेटासेट में इनपुट फीचर्स की संख्या को कम करने का सुझाव दिया जाता है। इसलिए नाम 'डायमेंशनलिटी रिडक्शन'।