इस लेख में, हम Scikit-learn में लर्निंग मॉडल बिल्डिंग के बारे में सीखेंगे: एक Python मशीन लर्निंग लाइब्रेरी।
यह एक मुफ्त मशीन लर्निंग लाइब्रेरी है। यह रैंडम फॉरेस्ट, वेक्टर मशीन और k-निकटतम पड़ोसी जैसे विभिन्न एल्गोरिदम का समर्थन करता है जिसमें NumPy और SciPy के साथ सीधा कार्यान्वयन होता है।
डेटासेट आयात करना
import pandas url = "अपना URL यहाँ निर्दिष्ट करें" data = pandas.read_csv(url)
डेटा एक्सप्लोरेशन और सफाई
हम रिकॉर्ड को अपनी आवश्यकताओं के अनुसार निर्दिष्ट/फ़िल्टर करने के लिए head मेथड का उपयोग कर सकते हैं।
data.head() data.head(n=4) # रिकॉर्ड को 4 तक सीमित करना
हम डेटासेट के अंतिम कुछ रिकॉर्ड भी लागू कर सकते हैं
data.tail() data.tail(n=4) # रिकॉर्ड को 4 तक सीमित करना
अब डेटा विज़ुअलाइज़ेशन का चरण आता है
इसके लिए, हम अपने डेटा को विज़ुअलाइज़ करने के लिए Seaborn मॉड्यूल और Matplotlib का उपयोग करते हैं
import seaborn as sns import matplotlib.pyplot as plt sns.set(style="whitegrid", color_codes=True) # एक काउंटप्लॉट बनाएं sns.countplot('Route To Market', data=sales_data, hue='Opportunity Result')डेटा प्रीप्रोसेसिंग
from sklearn import preprocessing le = preprocessing.LabelEncoder() # कॉलम को न्यूमेरिक मानों में बदलें encoded_value = le.fit_transform(कॉलम नामों की सूची) print(encoded_value)
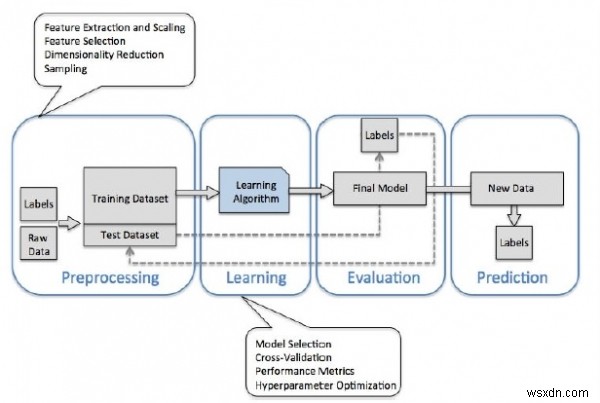
अंत में हम डेटासेट को प्रशिक्षित करके मॉडल बिल्डिंग के चरण तक पहुँचते हैं।
निष्कर्ष
इस लेख में, हमने Python में उपलब्ध एक लाइब्रेरी Scikit-learn में मॉडल बिल्डिंग के बारे में सीखा।