हम Seaborn लाइब्रेरी का उपयोग करेंगे, जो डेटा विज़ुअलाइज़ करने में मदद करती है। जब रिग्रेशन मॉडल बनाए जाते हैं, तो मल्टीकॉलीनियरिटी की जांच की जाती है। ऐसा इसलिए क्योंकि हमें सभी विभिन्न सतत चर के संयोजनों के बीच मौजूद सहसंबंध को समझने की आवश्यकता होती है। यदि चर के बीच मल्टीकॉलीनियरिटी मौजूद है, तो हमें यह सुनिश्चित करना होगा कि इसे डेटा से हटा दिया जाए। वास्तविक दुनिया में डेटा आमतौर पर नॉन-लीनियर होता है।
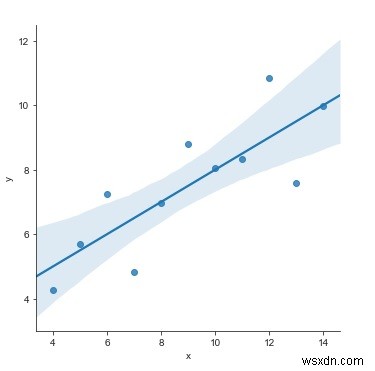
हमें ऐसे नॉन-लीनियर डेटा को मॉडल में फिट करने के तंत्र खोजने की आवश्यकता होती है। हम इसे विज़ुअलाइज़ करने के लिए एन्सकॉम्ब के डेटासेट का उपयोग करेंगे। 'implot' फंक्शन का उपयोग इस नॉन-लीनियर डेटा के साथ किया जाता है।
यहां उदाहरण है:
उदाहरण
import pandas as pd
import seaborn as sb
from matplotlib import pyplot as plt

my_df = sb.load_dataset('anscombe')
sb.lmplot(x="x", y="y", data=my_df.query("dataset == 'I'"))
plt.show()
आउटपुट
व्याख्या
- आवश्यक पैकेज आयात किए जाते हैं।
- इनपुट डेटा 'anscombe' है जिसे seaborn लाइब्रेरी से लोड किया जाता है।
- यह डेटा एक डेटाफ्रेम में स्टोर होता है।
- 'load_dataset' फंक्शन का उपयोग आइरिस डेटा लोड करने के लिए किया जाता है।
- इस डेटा को 'implot' फंक्शन का उपयोग करके विज़ुअलाइज़ किया जाता है।
- यहां, डेटाफ्रेम को पैरामीटर के रूप में सप्लाई किया जाता है।
- साथ ही, x और y मान निर्दिष्ट किए जाते हैं।
- यह डेटा कंसोल पर प्रदर्शित होता है।