Seaborn एक लाइब्रेरी है जो डेटा विज़ुअलाइज़ करने में मदद करती है। यह कस्टमाइज़्ड थीम और हाई-लेवल इंटरफेस के साथ आती है।
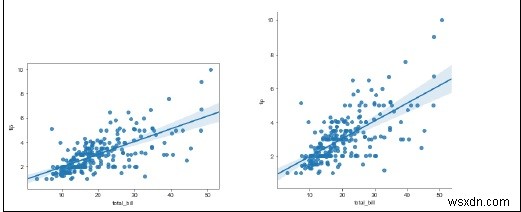
जब रिग्रेशन मॉडल बनाए जाते हैं, तो मल्टीकॉलीनियरिटी की जांच की जाती है। ऐसा इसलिए क्योंकि हमें सभी विभिन्न सतत चर के संयोजनों के बीच मौजूद सहसंबंध को समझने की आवश्यकता होती है। यदि चर के बीच मल्टीकॉलीनियरिटी मौजूद है, तो हमें यह सुनिश्चित करना होगा कि इसे डेटा से हटा दिया जाए। यह वह जगह है जहां 'regpot' और 'implot' फंक्शन काम आते हैं। वे रैखिक प्रतिगमन में चर के बीच रैखिक संबंध को विज़ुअलाइज़ करने में मदद करते हैं।
'regplot' फंक्शन चर 'x' और 'y' के लिए मान विभिन्न प्रारूपों में स्वीकार करता है, और इसमें नम्पाई सरणी, पांडास सीरीज ऑब्जेक्ट्स, पांडास डेटाफ्रेम से चर या मान के संदर्भ शामिल हैं।
दूसरी ओर, 'implot' फंक्शन के लिए उपयोगकर्ता को डेटा के लिए एक विशिष्ट पैरामीटर पास करना आवश्यक होता है, और चर 'x' और 'y' के मान स्ट्रिंग होने चाहिए। इस प्रकार के डेटा प्रारूप को लॉन्ग-फॉर्म डेटा के रूप में जाना जाता है। यहां उदाहरण है:
उदाहरण
import seaborn as sb
from matplotlib import pyplot as plt

my_df = sb.load_dataset('tips')
sb.regplot(x="total_bill", y="tip", data=my_df)
sb.lmplot(x="total_bill", y="tip", data=my_df)
plt.show()
आउटपुट
व्याख्या
- आवश्यक पैकेज आयात किए जाते हैं।
- इनपुट डेटा 'tips' है जिसे seaborn लाइब्रेरी से लोड किया जाता है।
- यह डेटा एक डेटाफ्रेम में स्टोर होता है।
- 'load_dataset' फंक्शन का उपयोग आइरिस डेटा लोड करने के लिए किया जाता है।
- इस डेटा को 'regplot' फंक्शन का उपयोग करके विज़ुअलाइज़ किया जाता है।
- इस डेटा को 'implot' फंक्शन का उपयोग करके विज़ुअलाइज़ किया जाता है।
- यहां, डेटाफ्रेम को पैरामीटर के रूप में सप्लाई किया जाता है।
- साथ ही, x और y मान निर्दिष्ट किए जाते हैं।
- यह डेटा कंसोल पर प्रदर्शित होता है।