ऑगमेंटेशन का उपयोग अतिरिक्त ट्रेनिंग डेटा जोड़कर ओवरफिटिंग को कम करने के लिए किया जा सकता है। यह 'RandomFlip' लेयर का उपयोग करने वाले सीक्वेंशियल मॉडल को बनाकर किया जाता है।
और पढ़ें: टेंसरफ्लो क्या है और केरस टेंसरफ्लो के साथ न्यूरल नेटवर्क बनाने में कैसे काम करता है?
हम केरस सीक्वेंशियल API का उपयोग करेंगे, जो एक सीक्वेंशियल मॉडल बनाने में सहायक है जिसका उपयोग लेयर के सादे स्टैक के साथ काम करने के लिए किया जाता है, जहां प्रत्येक लेयर में ठीक एक इनपुट टेंसर और एक आउटपुट टेंसर होता है।
एक न्यूरल नेटवर्क जिसमें कम से कम एक लेयर होती है, कन्वोल्यूशनल लेयर के रूप में जानी जाती है। हम कन्वोल्यूशनल न्यूरल नेटवर्क का उपयोग लर्निंग मॉडल बनाने के लिए कर सकते हैं।
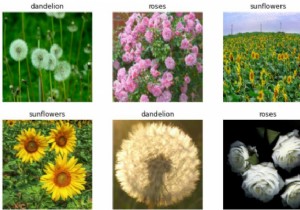
केरस सीक्वेंशियल मॉडल का उपयोग करके एक इमेज क्लासिफायर बनाया जाता है, और डेटा preprocessing.image_dataset_from_directory का उपयोग करके लोड किया जाता है। डेटा डिस्क से कुशलतापूर्वक लोड किया जाता है। ओवरफिटिंग की पहचान की जाती है और इसे कम करने के लिए तकनीकें लागू की जाती हैं। इन तकनीकों में डेटा ऑगमेंटेशन और ड्रॉपआउट शामिल हैं। 3700 फूलों की इमेज हैं। इस डेटासेट में 5 सब डायरेक्टरी हैं, और प्रति क्लास एक सब डायरेक्टरी है। वे हैं: डेज़ी, डैंडेलियन, गुलाब, सनफ्लावर, और ट्यूलिप।
हम नीचे दिए गए कोड को चलाने के लिए Google Colaboratory का उपयोग कर रहे हैं। Google Colab या कोलेबोरेटरी ब्राउज़र पर पायथन कोड चलाने में मदद करता है और इसके लिए शून्य कॉन्फ़िगरेशन और GPU (ग्राफिकल प्रोसेसिंग यूनिट्स) तक मुफ्त पहुंच की आवश्यकता होती है। कोलेबोरेटरी को जुपिटर नोटबुक के शीर्ष पर बनाया गया है।
जब ट्रेनिंग उदाहरणों की संख्या कम होती है, तो मॉडल ट्रेनिंग उदाहरणों से शोर या अवांछित विवरण सीखता है। यह नए उदाहरणों पर मॉडल के प्रदर्शन को नकारात्मक रूप से प्रभावित करता है।
ओवरफिटिंग के कारण, मॉडल नए डेटासेट पर अच्छी तरह से सामान्यीकरण नहीं कर पाएगा। ओवरफिटिंग से बचने के कई तरीके हैं। हम डेटा ऑगमेंटेशन का उपयोग करके ओवरफिटिंग को दूर करेंगे। डेटा ऑगमेंटेशन मौजूदा उदाहरणों से रैंडम ट्रांसफॉर्मेशन की मदद से उन्हें ऑगमेंट करके अतिरिक्त ट्रेनिंग डेटा जनरेट करता है जो विश्वसनीय दिखने वाली इमेज उत्पन्न करेगा।
यह मॉडल को डेटा के अधिक पहलुओं से अवगत कराने में मदद करता है, जिससे मॉडल को बेहतर ढंग से सामान्यीकरण करने में मदद मिलती है। निम्नलिखित एक उदाहरण है:
उदाहरण
print("ओवरफिटिंग को खत्म करने के लिए डेटा ऑगमेंटेशन का उपयोग")
data_augmentation = keras.Sequential([
    layers.experimental.preprocessing.RandomFlip("horizontal", input_shape=(img_height, img_width, 3)),
    layers.experimental.preprocessing.RandomRotation(0.1),
    layers.experimental.preprocessing.RandomZoom(0.1),
])
कोड क्रेडिट - https://www.tensorflow.org/tutorials/images/classification
आउटपुट
ओवरफिटिंग को खत्म करने के लिए डेटा ऑगमेंटेशन का उपयोग
व्याख्या
डेटा ऑगमेंटेशन को tf.keras.layers.experimental.preprocessing से लेयर का उपयोग करके लागू किया जा सकता है।
ये लेयर अन्य लेयर की तरह मॉडल के अंदर शामिल होते हैं, और GPU पर चलते हैं।
यह ओवरफिटिंग को खत्म या कम करने के लिए किया जाता है।