'matplotlib' लाइब्रेरी की मदद से टेंसरफ्लो का उपयोग करके पायथन में ट्रेनिंग परिणाम विज़ुअलाइज़ किए जा सकते हैं। 'plot' मेथड का उपयोग कंसोल पर डेटा प्लॉट करने के लिए किया जाता है।
और पढ़ें: टेंसरफ्लो क्या है और केरस टेंसरफ्लो के साथ न्यूरल नेटवर्क बनाने में कैसे काम करता है?
हम केरस सीक्वेंशियल API का उपयोग करेंगे, जो एक सीक्वेंशियल मॉडल बनाने में सहायक है जिसका उपयोग लेयर के सादे स्टैक के साथ काम करने के लिए किया जाता है, जहां प्रत्येक लेयर में ठीक एक इनपुट टेंसर और एक आउटपुट टेंसर होता है।
एक न्यूरल नेटवर्क जिसमें कम से कम एक लेयर होती है, कन्वोल्यूशनल लेयर के रूप में जानी जाती है। हम कन्वोल्यूशनल न्यूरल नेटवर्क का उपयोग लर्निंग मॉडल बनाने के लिए कर सकते हैं।
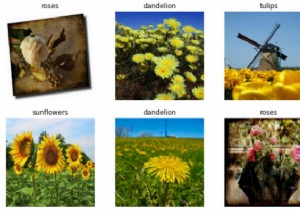
केरस सीक्वेंशियल मॉडल का उपयोग करके एक इमेज क्लासिफायर बनाया जाता है, और डेटा preprocessing.image_dataset_from_directory का उपयोग करके लोड किया जाता है। डेटा डिस्क से कुशलतापूर्वक लोड किया जाता है। ओवरफिटिंग की पहचान की जाती है और इसे कम करने के लिए तकनीकें लागू की जाती हैं। इन तकनीकों में डेटा ऑगमेंटेशन और ड्रॉपआउट शामिल हैं। 3700 फूलों की इमेज हैं। इस डेटासेट में 5 सब डायरेक्टरी हैं, और प्रति क्लास एक सब डायरेक्टरी है। वे हैं: डेज़ी, डैंडेलियन, गुलाब, सनफ्लावर, और ट्यूलिप।
हम नीचे दिए गए कोड को चलाने के लिए Google Colaboratory का उपयोग कर रहे हैं। Google Colab या कोलेबोरेटरी ब्राउज़र पर पायथन कोड चलाने में मदद करता है और इसके लिए शून्य कॉन्फ़िगरेशन और GPU (ग्राफिकल प्रोसेसिंग यूनिट्स) तक मुफ्त पहुंच की आवश्यकता होती है। कोलेबोरेटरी को जुपिटर नोटबुक के शीर्ष पर बनाया गया है।
उदाहरण
print("सटीकता की गणना")
acc = history.history['accuracy']
val_acc = history.history['val_accuracy']
print("लॉस की गणना")
loss = history.history['loss']
val_loss = history.history['val_loss']
epochs_range = range(epochs)
print("परिणाम विज़ुअलाइज़ किए जा रहे हैं")
plt.figure(figsize=(8, 8))
plt.subplot(1, 2, 1)
plt.plot(epochs_range, acc, label='Training Accuracy')
plt.plot(epochs_range, val_acc, label='Validation Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')
plt.subplot(1, 2, 2)
plt.plot(epochs_range, loss, label='Training Loss')
plt.plot(epochs_range, val_loss, label='Validation Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.show()
कोड क्रेडिट - https://www.tensorflow.org/tutorials/images/classification
आउटपुट
सटीकता की गणना
लॉस की गणना
परिणाम विज़ुअलाइज़ किए जा रहे हैं
व्याख्या
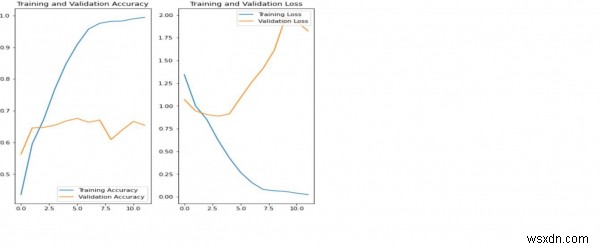
उपरोक्त प्लॉट इंगित करते हैं कि ट्रेनिंग सटीकता और वैलिडेशन सटीकता सिंक में नहीं हैं।
मॉडल ने वैलिडेशन डेटासेट पर केवल लगभग 60 प्रतिशत सटीकता हासिल की है।
इसे ओवरफिटिंग के रूप में जाना जाता है।
ट्रेनिंग सटीकता समय के साथ रैखिक रूप से बढ़ी है, लेकिन वैलिडेशन सटीकता ट्रेनिंग प्रक्रिया में लगभग 60 प्रतिशत पर रुक गई है।
जब ट्रेनिंग उदाहरणों की संख्या कम होती है, तो मॉडल ट्रेनिंग उदाहरणों से शोर या अवांछित विवरण सीखता है।
यह नए उदाहरणों पर मॉडल के प्रदर्शन को नकारात्मक रूप से प्रभावित करता है।
ओवरफिटिंग के कारण, मॉडल नए डेटासेट पर अच्छी तरह से सामान्यीकरण नहीं कर पाएगा।
ओवरफिटिंग से बचने के कई तरीके हैं। हम डेटा ऑगमेंटेशन का उपयोग करके ओवरफिटिंग को दूर करेंगे।