इस लेख में, हम Python 3.x या उससे पहले के संस्करणों का उपयोग करके मशीन लर्निंग की मूल बातें सीखेंगे।
सबसे पहले, हमें मशीन लर्निंग वातावरण स्थापित करने के लिए मौजूदा लाइब्रेरी का उपयोग करने की आवश्यकता है
>>> pip install numpy >>> pip install scipy >>> pip install matplotlib >>> pip install scikit-learn
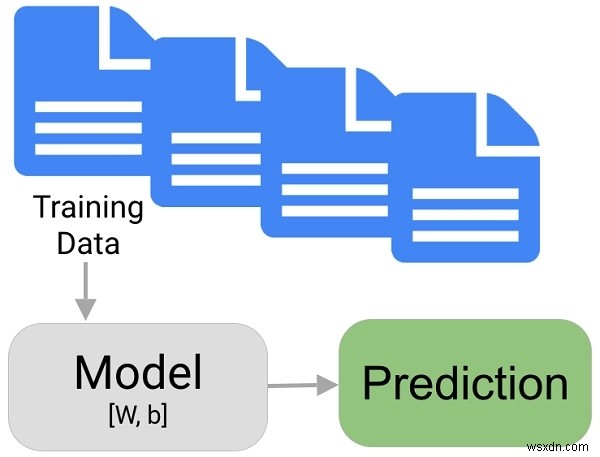
मशीन लर्निंग अनुभवों और तथ्यों के अध्ययन से संबंधित है और प्रदान किए गए इरादों के आधार पर भविष्यवाणी की जाती है। डेटाबेस जितना बड़ा होगा, मशीन लर्निंग मॉडल उतना ही बेहतर होगा।
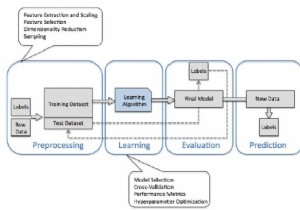
मशीन लर्निंग का प्रवाह
- डेटा की सफाई
- डेटासेट फीड करना
- मॉडल प्रशिक्षित करना
- डेटासेट का परीक्षण
- मॉडल लागू करना
अब आइए पहचानें कि किस लाइब्रेरी का उपयोग किस उद्देश्य के लिए किया जाता है -
NumPy - विशाल, बहुआयामी सूचियों और मैट्रिक्स के लिए समर्थन जोड़ता है, साथ ही इन इनपुट सरणियों पर संचालन करने के लिए गणितीय फ़ंक्शन का एक विस्तृत संग्रह।
SciPy - वैज्ञानिक/गणितीय कंप्यूटिंग के लिए उपयोग की जाने वाली एक मुफ्त और ओपन-सोर्स Python लाइब्रेरी। इसमें एल्गोरिदम के अनुकूलन, डेटा के एकीकरण, इंटरपोलेशन, कुछ विशेष फ़ंक्शन और रैखिक बीजगणित के लिए मॉड्यूल शामिल हैं।
Matplotlib - चार्ट और आंकड़े बनाने के लिए उपयोग की जाने वाली एक लाइब्रेरी। यह डेटा को प्लॉट करने की अनुमति देता है ताकि मॉडल में बेहतर अंतर्दृष्टि प्राप्त की जा सके।
Scikit-learn - इसमें विभिन्न वर्गीकरण, क्लस्टरिंग और रिग्रेशन एल्गोरिदम हैं जो डेटा को एक अच्छी तरह से परिभाषित तरीके से वितरित और व्यवस्थित करते हैं।
अब scikit-learn की मदद से एक बुनियादी मशीन लर्निंग मॉडल बनाते हैं। यहां हम ski-kit learn में उपलब्ध इनबिल्ट डेटासेट यानी iris और digits डेटासेट लेंगे।
from sklearn import datasets iris = datasets.load_iris() digits = datasets.load_digits()
अब डेटासेट से डेटा देखने के लिए हम उपयोग करते हैं
print(digits.data)
[[ 0. 0. 5. ... 0. 0. 0.] [ 0. 0. 0. ... 10. 0. 0.] [ 0. 0. 0. ... 16. 9. 0.] ... [ 0. 0. 1. ... 6. 0. 0.] [ 0. 0. 2. ... 12. 0. 0.] [ 0. 0. 10. ... 12. 1. 0.]]
.target फ़ंक्शन हमें उन चीजों को देखने की अनुमति देता है जिन्हें हम चाहते हैं कि हमारा मॉडल सीखे
digits.target
array([0, 1, 2, ..., 8, 9, 8])
digits डेटासेट के आकार तक पहुँचने के लिए हम उपयोग करते हैं
digits.images[0]
array([[ 0., 0., 5., 13., 9., 1., 0., 0.], [ 0., 0., 13., 15., 10., 15., 5., 0.], [ 0., 3., 15., 2., 0., 11., 8., 0.], [ 0., 4., 12., 0., 0., 8., 8., 0.], [ 0., 5., 8., 0., 0., 9., 8., 0.], [ 0., 4., 11., 0., 1., 12., 7., 0.], [ 0., 2., 14., 5., 10., 12., 0., 0.], [ 0., 0., 6., 13., 10., 0., 0., 0.]])
अब आइए सीखने और भविष्यवाणी के भाग पर चलते हैं
from sklearn import svm clf = svm.SVC(gamma=0.001, C=100.)
यहां SVC सपोर्ट वेक्टर क्लासिफिकेशन है जो हमारे मॉडल के लिए एक इनबिल्ट एस्टिमेटर के रूप में कार्य करता है
clf.fit(digits.data[:-1], digits.target[:-1]) SVC(C=100.0, cache_size=200, class_weight=None, coef0=0.0, decision_function_shape='ovr', degree=3, gamma=0.001, kernel='rbf', max_iter=-1, probability=False, random_state=None, shrinking=True, tol=0.001, verbose=False)
सबसे पहले हमें fit मेथड का उपयोग करके मॉडल को डेटासेट के साथ फीड करना होगा ताकि हमारा मॉडल सीख सके। यहां हम अंतिम छवि को छोड़कर सभी छवियों को प्रशिक्षण डेटा के रूप में फीड करते हैं जिसका उपयोग हम परीक्षण उद्देश्य के लिए करेंगे।
अब चूंकि हमारा मॉडल प्रशिक्षित है, हम .predict फ़ंक्शन का उपयोग करके परीक्षण डेटा के आउटपुट की भविष्यवाणी कर सकते हैं
clf.predict(digits.data[-1:]) array([8])
अब चूंकि हमारा मॉडल प्रशिक्षित है, हम अपने मॉडल की दक्षता और समय-चक्र की गणना कर सकते हैं
निष्कर्ष
इस लेख में, हमने Python में इसे लागू करने के लिए उपयोग की जाने वाली कुछ बुनियादी लाइब्रेरी और मशीन लर्निंग की कुछ मूल बातों के बारे में सीखा।