यदि हम श्रेणियों के भीतर मौजूद डेटा की तुलना करना चाहते हैं, तो बॉक्स प्लॉट काम आते हैं। यह एक तरीका है जिसमें डेटासेट में डेटा वितरण को क्वार्टाइल की मदद से समझा जा सकता है। इसमें ऊर्ध्वाधर रेखाएं होती हैं जो बॉक्स से फैली होती हैं। इन एक्सटेंशन को व्हिस्कर्स (whiskers) के नाम से जाना जाता है। ये व्हिस्कर्स बताते हैं कि डेटा ऊपरी और निचले क्वार्टाइल के बाहर कैसे बदलता है। इसीलिए बॉक्स प्लॉट को व्हिस्कर प्लॉट के नाम से भी जाना जाता है। डेटा में आउटलेयर्स को व्यक्तिगत बिंदुओं के रूप में प्लॉट किया जाता है।
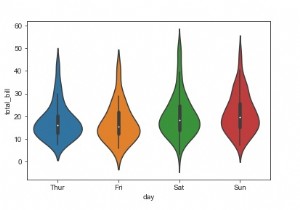
वायलिन प्लॉट बॉक्स प्लॉट और कर्नेल डेंसिटी एस्टीमेट (KDE) का संयोजन है। यह विश्लेषण करना और समझना आसान बनाता है कि डेटा कैसे वितरित किया गया है। वायलिन का चौड़ा भाग डेटा के उच्च घनत्व को इंगित करता है। वायलिन का संकीर्ण भाग डेटा के निम्न घनत्व को इंगित करता है।
बॉक्सप्लॉट के भीतर इंटर-क्वार्टाइल रेंज और डेटा का उच्च घनत्व भाग हर श्रेणी में एक ही क्षेत्र में आता है।
violinplot फंक्शन का सिंटैक्स
seaborn.violinplot(x, y, data, ...)
आइए समझते हैं कि वायलिन प्लॉट का उपयोग डेटा प्लॉट करने के लिए कैसे किया जा सकता है।
उदाहरण
import pandas as pd
import seaborn as sb
from matplotlib import pyplot as plt

my_df = sb.load_dataset('tips')
sb.violinplot(x="day", y="total_bill", data=my_df)
plt.show()
आउटपुट
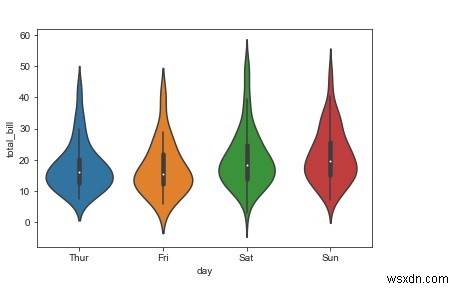
व्याख्या
- आवश्यक पैकेज आयात किए जाते हैं।
- इनपुट डेटा 'iris_data' है जिसे scikit learn लाइब्रेरी से लोड किया जाता है।
- यह डेटा एक डेटाफ्रेम में स्टोर होता है।
- 'load_dataset' फंक्शन का उपयोग आइरिस डेटा लोड करने के लिए किया जाता है।
- इस डेटा को 'violinplot' फंक्शन का उपयोग करके विज़ुअलाइज़ किया जाता है।
- यहां, डेटाफ्रेम को पैरामीटर के रूप में सप्लाई किया जाता है।
- साथ ही, x और y मान निर्दिष्ट किए जाते हैं।
- यह डेटा कंसोल पर प्रदर्शित होता है।