डेटा प्री-प्रोसेसिंग का अर्थ है डेटा की सफाई, अमान्य डेटा, शोर को हटाना, प्रासंगिक मानों के साथ डेटा को बदलना आदि। इसका मतलब हमेशा टेक्स्ट डेटा नहीं होता; यह इमेज या वीडियो प्रोसेसिंग भी हो सकता है।
डेटा प्री-प्रोसेसिंग मूल रूप से सभी डेटा को (जो विभिन्न संसाधनों या एकल संसाधन से एकत्र किया गया है) एक सामान्य प्रारूप या यूनिफॉर्म डेटासेट में इकट्ठा करने के कार्य को संदर्भित करता है (डेटा के प्रकार के आधार पर)। चूंकि वास्तविक दुनिया का डेटा कभी आदर्श नहीं होता, इसलिए संभावना है कि डेटा में गायब सेल, त्रुटियां, आउटलायर, कॉलम में विसंगतियां, और बहुत कुछ हो।
कभी-कभी, इमेज सही ढंग से संरेखित नहीं हो सकतीं, या स्पष्ट नहीं हो सकतीं या बहुत बड़ी हो सकती हैं। प्री-प्रोसेसिंग का लक्ष्य इन विसंगतियों और त्रुटियों को दूर करना है।
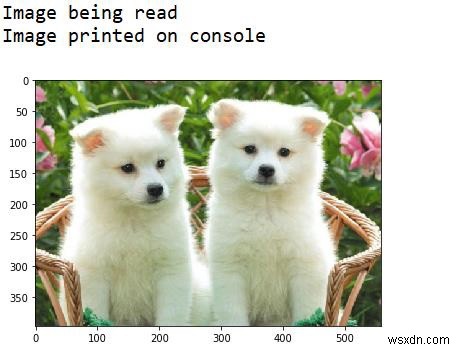
आइए scikit-learn लाइब्रेरी का उपयोग करके इमेज अपलोड करने और कंसोल पर देखने का उदाहरण लेते हैं।
उदाहरण
from skimage import io
path = "path to puppy.PNG"
img = io.imread(path)
print("Image being read")
io.imshow(img)
print("Image printed on console")
आउटपुट
व्याख्या
- आवश्यक लाइब्रेरी आयात की जाती हैं।
- वह पथ परिभाषित किया जाता है जहां इमेज स्टोर है।
- 'imread' फंक्शन का उपयोग पथ पर जाकर इमेज पढ़ने के लिए किया जाता है।
- इमेज पढ़ने के बाद, पिक्सेल मान सरणी के रूप में स्टोर हो जाते हैं।
- यह सरणी एक नम्पाई (NumPy) सरणी के अलावा कुछ नहीं है।
- इमेज पढ़ी जाती है और सरणी में बदल जाती है।
- 'imshow' फंक्शन का उपयोग कंसोल पर इमेज प्रदर्शित करने के लिए किया जाता है।
- डेटा कंसोल पर प्रदर्शित होता है।