डेटा प्री-प्रोसेसिंग मूल रूप से सभी डेटा (जो विभिन्न संसाधनों या एकल संसाधन से एकत्र किया गया है) को एक सामान्य प्रारूप में या समान डेटासेट में इकट्ठा करने का कार्य है (डेटा के प्रकार के आधार पर)।
चूंकि वास्तविक दुनिया का डेटा कभी भी आदर्श नहीं होता, इसलिए संभावना है कि डेटा में लापता सेल, त्रुटियां, आउटलायर, कॉलम में विसंगतियां, और बहुत कुछ हो।
कभी-कभी, इमेज सही ढंग से संरेखित नहीं हो सकती हैं, या स्पष्ट नहीं हो सकती हैं या बहुत बड़े आकार की हो सकती हैं। प्री-प्रोसेसिंग का लक्ष्य इन विसंगतियों और त्रुटियों को दूर करना है।
इमेज के पिक्सेल प्राप्त करने के लिए, 'फ्लैटन' नामक एक बिल्ट-इन फ़ंक्शन का उपयोग किया जाता है। इमेज पढ़ने के बाद, पिक्सेल मान डेटाफ्रेम के रूप में संग्रहीत होते हैं। 'फ्लैटन' फ़ंक्शन का उपयोग RGB इमेज के तीन आयामों को एक आयाम में बदलने और पिक्सेल के मान को डेटाफ्रेम में प्राप्त करने के लिए किया जाता है।
पूरे डेटाफ्रेम को प्रिंट करने के बजाय, डेटाफ्रेम के आयाम प्रिंट किए जाते हैं। आइए scikit-learn लाइब्रेरी का उपयोग करके एक इमेज अपलोड करने और इमेज में मौजूद पिक्सेल को डेटाफ्रेम के रूप में प्राप्त करने का उदाहरण लेते हैं -
उदाहरण
from skimage import io
import pandas as pd
path = "path to puppy.PNG"
img = io.imread(path)
print("इमेज पढ़ी जा रही है")
io.imshow(img)
print("इमेज कंसोल पर प्रिंट हुई")
my_df = pd.DataFrame(img.flatten())
print("इमेज पिक्सेल के आयाम हैं")
print(my_df.shape)
आउटपुट
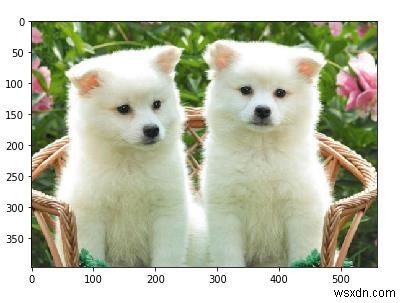
इमेज पढ़ी जा रही है
इमेज कंसोल पर प्रिंट हुई
इमेज पिक्सेल के आयाम हैं (886104, 1)
व्याख्या
आवश्यक लाइब्रेरी आयात की गई हैं।
वह पथ परिभाषित किया गया है जहां इमेज संग्रहीत है।
'imread' फ़ंक्शन का उपयोग पथ पर जाकर इमेज पढ़ने के लिए किया जाता है।
'imshow' फ़ंक्शन का उपयोग कंसोल पर इमेज प्रदर्शित करने के लिए किया जाता है।
'फ्लैटन' फ़ंक्शन का उपयोग RGB इमेज के तीन आयामों को एक आयाम में बदलने और पिक्सेल के मान को डेटाफ्रेम में प्राप्त करने के लिए किया जाता है।
डेटाफ्रेम को प्रिंट करने के बजाय जिसमें बहुत अधिक पंक्तियां हैं, डेटाफ्रेम के आयाम प्रदर्शित किए जाते हैं।
डेटाफ्रेम को 'print(my_df)' का उपयोग करके देखा जा सकता है।
आउटपुट इमेज पिक्सेल मानों वाला एक डेटाफ्रेम है जो कंसोल पर प्रिंट होता है।