Computer >> कंप्यूटर ट्यूटोरियल >  >> प्रोग्रामिंग >> Python

पैंडास डेटाफ्रेम में दो संख्यात्मक कॉलम के बीच सहसंबंध


हम कॉलम के युग्मवार सहसंबंध की गणना करने के लिए pandas.DataFrame.corr का उपयोग कर सकते हैं, NULL मानों को छोड़कर। सहसंबंध गुणांक दो चरों के बीच रैखिक संबंध की ताकत को दर्शाता है। गुणांक -1 और 1 के बीच होता है।

पैंडास डेटाफ्रेम में दो संख्यात्मक कॉलम के बीच सहसंबंध प्राप्त करने के लिए, हम निम्नलिखिक चरण अपना सकते हैं:

  • फिगर आकार सेट करें और सबप्लॉट्स के बीच और आसपास पैडिंग समायोजित करें।
  • दो-आयामी, आकार-परिवर्तनीय, संभावित विषम सारणीबद्ध डेटा का पैंडास डेटाफ्रेम बनाएं।
  • दोनों कॉलम के मानों की तुलना करें और col1.corr(col2) का उपयोग करके सहसंबंध गुणांक की गणना करें।
  • कंसोल पर सहसंबंध गुणांक प्रिंट करें।
  • फिगर प्रदर्शित करने के लिए show() मेथड का उपयोग करें।

उदाहरण

import pandas as pd
from matplotlib import pyplot as plt
plt.rcParams["figure.figsize"] = [7.00, 3.50]
plt.rcParams["figure.autolayout"] = True
df = pd.DataFrame({'lab': [1, 2, 3], 'value': [3, 4, 5]})
col1 = df['lab']
col2 = df['value']
plt.plot(col1, col2)
print("The correlation coefficient is: ", col1.corr(col2))
plt.show()

आउटपुट

यह निम्नलिखिक आउटपुट उत्पन्न करेगा:

The correlation coefficient is: 1.0

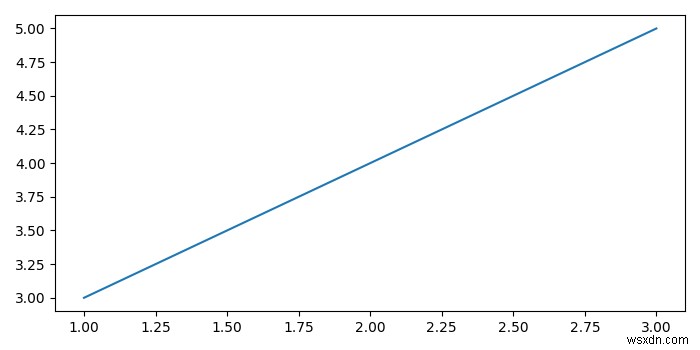
पैंडास डेटाफ्रेम में दो संख्यात्मक कॉलम के बीच सहसंबंधपैंडास डेटाफ्रेम में दो संख्यात्मक कॉलम के बीच सहसंबंध

यहां, सहसंबंध गुणांक 1.0 है जो पूर्ण सहसंबंध दर्शाता है। इसलिए, हमें एक सीधी रेखा मिलती है क्योंकि सभी बिंदु एक सीधी रेखा पर स्थित हैं।
  1. पायथन - पैंडास DataFrame में कॉलम के नाम स्पष्ट रूप से नामित करें पायथन - पैंडास DataFrame में कॉलम के नाम स्पष्ट रूप से नामित करें

    कॉलम के नाम स्पष्ट रूप से नामित करने के लिए read_csv() विधि के names पैरामीटर का उपयोग करें। मान लीजिए हमारी CSV फ़ाइल बिना हेडर्स के Microsoft Excel में खुली है:आइए CSV फ़ाइल से डेटा लोड करें और names पैरामीटर का उपयोग करके हेडर कॉलम जोड़ें:pd.read_csv(C:\\Users\\amit_\\Desktop\\TeamData.csv, names

  1. पायथन - पैंडास DataFrame से एकाधिक कॉलम का चयन कैसे करें पायथन - पैंडास DataFrame से एकाधिक कॉलम का चयन कैसे करें

    मान लीजिए हमारी CSV फ़ाइल की सामग्री Microsoft Excel में निम्नलिखित है:सबसे पहले, CSV फ़ाइल से डेटा पैंडास DataFrame में लोड करें:dataFrame = pd.read_csv(C:\\Users\\amit_\\Desktop\\SalesData.csv)एकाधिक कॉलम रिकॉर्ड का चयन करने के लिए वर्गाकार ब्रैकेट का उपयोग करें। ब्रैकेट में कॉलम का उल्लेख करें और

  1. पायथन पैंडास - डेटाफ्रेम में एकाधिक डेटा कॉलम कैसे प्लॉट करें पायथन पैंडास - डेटाफ्रेम में एकाधिक डेटा कॉलम कैसे प्लॉट करें

    एकाधिक कॉलम प्लॉट करने के लिए, हम बार ग्राफ का उपयोग करेंगे। plot() मेथड का उपयोग करें और kind पैरामीटर को बार ग्राफ के लिए bar पर सेट करें। पहले आवश्यक लाइब्रेरी आयात करें: import pandas as pd import matplotlib.pyplot as mp टीम रिकॉर्ड के साथ हमारा डेटा निम्नलिखित है: data = [[Australia, 2500, 202