Python में अनंत को बड़े फाइनाइट नंबर से बदलें लेकिन NaN मान भरें
NumPy का numpy.nan_to_num() फंक्शन NaN को शून्य (या कस्टम मान) से और अनंत (infinity) को बड़े फाइनाइट नंबर्स से बदलता है। nan पैरामीटर से NaN के लिए कस्टम रिप्लेसमेंट मान निर्दिष्ट कर सकते हैं।
posinf: +∞ के लिए रिप्लेसमेंट (डिफ़ॉल्ट: dtype का मैक्स फाइनाइट मान)।
neginf: -∞ के लिए रिप्लेसमेंट (डिफ़ॉल्ट: dtype का मिन फाइनाइट मान)।
उदाहरण: कस्टम NaN मान के साथ
import numpy as np

# inf, -inf, nan, और सामान्य मानों वाला ऐरे
arr = np.array([np.inf, -np.inf, np.nan, -128, 128])

print("मूल ऐरे:\n", arr)
print("\nडायमेंशन्स:", arr.ndim)
print("डेटा टाइप:", arr.dtype)
print("आकार:", arr.shape)

# NaN को 11111 से बदलें, inf को डिफ़ॉल्ट बड़े मान से
result = np.nan_to_num(arr, nan=11111)
print("\nपरिणाम (nan=11111):\n", result)
आउटपुट
मूल ऐरे:
 [ inf -inf nan -128. 128.]
डायमेंशन्स: 1
डेटा टाइप: float64
आकार: (5,)
परिणाम (nan=11111):
 [ 1.79769313e+308 -1.79769313e+308 1.11110000e+004 -1.28000000e+002 1.28000000e+002]
व्याख्या
मूल मान
बदला गया मान
नियम
+∞ (np.inf)
1.79769313e+308
float64 का मैक्स फाइनाइट (posinf डिफ़ॉल्ट)
-∞ (-np.inf)
-1.79769313e+308
float64 का मिन फाइनाइट (neginf डिफ़ॉल्ट)
NaN
11111.0
कस्टम nan=11111 पैरामीटर
-128
-128.0
कोई बदलाव नहीं
128
128.0
कोई बदलाव नहीं
सभी पैरामीटर्स के साथ पूर्ण नियंत्रण
result = np.nan_to_num(
    arr,
    nan=0.0,           # NaN → 0
    posinf=1e10,       # +∞ → 1e10
    neginf=-1e10,      # -∞ → -1e10
    copy=False         # इन-प्लेस यदि संभव
)
डिफ़ॉल्ट व्यवहार (कोई पैरामीटर नहीं)
result_default = np.nan_to_num(arr)
# NaN → 0.0
# +∞ → dtype मैक्स (float64 के लिए ~1.8e308)
# -∞ → dtype मिन (float64 के लिए ~-1.8e308)
व्यावहारिक उपयोग
ML प्रीप्रोसेसिंग: प्रशिक्षण से पहले NaN/inf साफ करें।
विज़ुअलाइज़ेशन: प्लॉटिंग के लिए अनंत मानों को फाइनाइट बनाएं।
न्यूमेरिकल स्थिरता: गणना में ओवरफ्लो/NaN प्रसार रोकें।
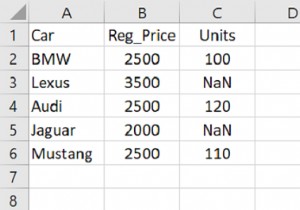
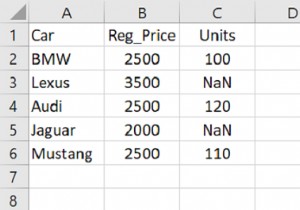
NaN मानों को बदलने के लिए fillna() विधि का उपयोग करें। मान लीजिए हमारी CSV फ़ाइल Microsoft Excel में कुछ NaN मानों के साथ खुली है:सबसे पहले, आवश्यक लाइब्रेरी आयात करें:import pandas as pdCSV फ़ाइल से डेटा पैंडास DataFrame में लोड करें:dataFrame = pd.read_csv(C:\\Users\\amit_\\Desktop\\SalesData.csv)
NaN मान भरने के लिए interpolate() मेथड का उपयोग करें। मान लीजिए निम्नलिखित हमारी CSV फ़ाइल है जिसे माइक्रोसॉफ्ट एक्सेल में कुछ NaN मानों के साथ खोला गया है:
CSV फ़ाइल से डेटा लोड करके पैंडास डेटाफ्रेम में डालें:
dataFrame = pd.read_csv(C:\\Users\\amit_\\Desktop\\SalesData.csv)
interpolate() के साथ
परिचय
एक डेटाफ्रेम के मान को दूसरे डेटाफ्रेम के मान से बदलने के लिए, पैंडास में replace() मेथड का उपयोग करें।
चरण-दर-चरण कार्यान्वयन
1. पहला डेटाफ्रेम बनाएं
import pandas as pd
dataFrame1 = pd.DataFrame({Car: [Audi, Lamborghini], Place: [US, UK], Units: [200, 500]})
2. दूसरा डेटाफ्रेम बनाएं
data