(ज्यादातर) Linux और FOSS के साथ एक नॉनफिक्शन इतिहास पुस्तक लिखना
अपडेट: 14 मार्च, 2025
मैं 30 साल से अधिक समय से किताबें लिख रहा हूँ। मैंने 2011 में उन्हें प्रकाशित करना शुरू किया। अब तक, मैंने 21 किताबें जंगल में छोड़ दी हैं। कुल मिलाकर, फिक्शन लिखना सुपर आसान है। आप बस अपने खुद के सिर का उपयोग करते हैं। कर्नेल क्रैश विश्लेषण, समस्या समाधान, नैतिकता, या करियर सहायता पर मेरे तकनीकी कार्य भी अपेक्षाकृत सरल थे। हाल ही में, हालांकि, मैंने अपनी सबसे महत्वाकांक्षी परियोजना पूरी की। एक सैन्य इतिहास पुस्तक।
नॉनफिक्शन कठिन है। आप इसे विंग नहीं कर सकते, अपने अनुभव या कल्पना का उपयोग नहीं कर सकते। आपको संदर्भों के साथ काम करना होगा, टन और टन, अन्य किताबें पढ़नी होंगी, आपको उद्धरणों का उपयोग करना होगा, और इसी तरह। खैर, पिछले तीन महीनों के लिए, मैंने खुद को इस अल्ट्रा-जटिल प्रयास में डुबो दिया। अब, यह हो गया। पुस्तक 90K शब्दों की है, इसमें प्रत्येक में लगभग 35 आंकड़े और टेबल्स हैं, साथ ही लगभग 700 उद्धरण। इसमें Matlab जैसे ऑक्टेव में लिखे गए एक विशिष्ट युद्ध परिदृश्य के लिए सिमुलेशन कोड का एक टुकड़ा भी शामिल है। और मैंने यह सब काम Linux और Linux टूल्स का उपयोग करके किया। खैर, 90% काम। मुझे और बताएं। पंद्रह मिलियन शब्दों की बेल्ट के नीचे एक अनुभवी लेखक के दृष्टिकोण से Linux।
क्यों Linux और ओपन-सोर्स टूल्स?
मैं एक विचारधारावादी नहीं हूँ। मैं एक व्यावहारिक व्यक्ति हूँ। और मेरा व्यावहारिक दृष्टिकोण है, यदि संभव हो तो, Windows का उपयोग पूरी तरह से बंद कर दूं, या कम से कम, उपयोग को जितना संभव हो उतना कम कर दूं। मैंने यह योजना कुछ समय पहले घोषित की थी, और कुल मिलाकर, यह गेमिंग और सॉफ़्टवेयर दोनों मोर्चों पर वास्तव में अच्छा चल रहा है। मैं Linux के साथ इस माइग्रेशन को पूरा करने की कोशिश कर रहा हूँ। वास्तव में, मेरे पास कई मशीनें हैं जो मुख्य रूप से Kubuntu के इस या उस संस्करण को चला रही हैं।
समीकरण में सबसे कमजोर कड़ी हमेशा कंप्यूटर गेम और ऑफिस का काम रहे हैं। Steam ने अद्भुत Proton लेयर के साथ इसे काफी हद तक हल कर दिया है। लेकिन ऑफिस मुश्किल है। मैं अपनी सभी किताबें LibreOffice में लिखता हूँ, और वर्षों से ऐसा कर रहा हूँ। अंतिम चरण, हालांकि, सबसे कठिन है। जब भी मुझे अंतिम पांडुलिपि प्रकाशकों को भेजने की आवश्यकता होती है, वे हमेशा DOCX मांगते हैं। कोई अपवाद नहीं।
उस अंत तक, मुझे Microsoft Office का सहारा लेना होगा। मेरे पास एक नेटिव Office 2016 इंस्टॉल है, साथ ही एक Windows 10 वर्चुअल मशीन में सेटअप Office 2010, जिसे ऑफ़लाइन रखा गया है। तो वह हमेशा एक विकल्प है। लेकिन फिर, वास्तविक लेखन प्रक्रिया के बारे में क्या?
जैसा कि मैंने आपको बताया, LibreOffice काम करता है। लेकिन प्रोग्राम की अपनी कई खामियां हैं। मैंने वहां मौजूद लगभग हर एक संस्करण की समीक्षा की है। अनुभव असंगत रहा है, गुणवत्ता और संगतता का एक रोलरकोस्टर, महान से औसत वापस महान तक जा रहा है। मैं आपको पिछले दशक से एक दर्जन से अधिक समीक्षाओं के लिंक से परेशान नहीं करूंगा। यदि आप रुचि रखते हैं तो आप मेरा ऑफिस सेक्शन देख सकते हैं। 24.2 रिलीज़, जिसे मैंने आखिरी बार परीक्षण किया था, वास्तव में काफी ठोस है, और मुझे आशा है कि यह केवल सुधरता रहेगा।
फिर भी, मुझे हमेशा इस बात से समस्या रही है कि LibreOffice स्टाइल और नेविगेशन को कैसे संभालता है। बहुत सारे बेकार माउस क्लिक और एक्शन। कोई नई बात नहीं। कुल मिलाकर, इन "बग्स" के अस्तित्व ने कभी भी एक बड़ी समस्या नहीं पैदा की है। फिक्शन लिखना ज्यादातर अनफॉर्मेटेड है। आप बस शब्दों का एक गुच्छा डालते हैं, और आप हो गए। नॉनफिक्शन पेचीदा है।
टेबल्स, आंकड़े, स्रोत कोड, संदर्भ, फुटनोट्स, संक्षिप्ताक्षर, कई सामग्री तालिकाओं, और अन्य तत्वों का उपयोग सभी स्टाइल पर भारी उपयोग और निर्भरता और पांडुलिपि में लगातार ऊपर और नीचे नेविगेशन का मतलब है। फिर, आमतौर पर, किसी को अपने शोध के हिस्से के रूप में कुछ दर्जन या सौ किताबें पढ़ने की आवश्यकता होती है, दोगुने दस्तावेज़ों को क्रॉस-रेफरेंस करना, एनोटेशन जोड़ना, उद्धरण जोड़ना, और फिर कुछ। ये सभी एक अनूठी चुनौती पेश करते हैं जो आप शायद ही कभी फिक्शन में देखते हैं। लेकिन वे नॉनफिक्शन, विशेष रूप से इतिहास की रोटी और मक्खन हैं।
खैर, अपनी लेखन "चुनौती" को और कठिन बनाने के लिए, मैंने Linux और संबंधित प्रोग्राम का उपयोग करके जितना संभव हो उतना करने की कोशिश करने का फैसला किया। हालांकि, मैंने इस या उस कॉफी शॉप में लट्टे पीते हुए अपने फोन पर बहुत सारा पढ़ना भी किया (हाँ, मैं एक फैशनेबल गिट हूँ), और जो भी निष्कर्ष मैंने वहां खोजे, उन्हें अपने डेस्कटॉप पर कॉपी/शेयर करना पड़ा। काम का वह हिस्सा विशुद्ध रूप से फ्री सॉफ़्टवेयर नहीं है, लेकिन कुछ फ्री सॉफ़्टवेयर तत्व हैं। वैसे भी, मुझे बताएं कि यह सब कैसे गया।
LibreOffice Writer
अच्छी चीजों से शुरू करते हैं। मेरी अंतिम पुस्तक 134 MB की है, यह 310 पेज लंबी है, और इसमें उपरोक्त कई आंकड़े, टेबल्स, उद्धरण, और अन्य फैंसी तत्व शामिल हैं। दस्तावेज़ को खोलना और/या सहेजना लगभग तीन सेकंड लेता है। कुल मिलाकर, Writer यह सब ठीक से संभालता है, बिना किसी हकलाहट या लैग या इसी तरह के मुद्दों के। लंबाई और जटिलता कोई समस्या नहीं है।
नेविगेशन टैब उपयोगी है। यह कई अद्भुत चीजें दिखाता है, जिसमें आपकी सभी छवियों और आंकड़ों की सूची (अलग से), आपकी सभी टेबल्स, यहां तक कि आपके सभी फुटनोट्स और एंडनोट्स, साथ ही आपके द्वारा चिह्नित कोई भी संक्षिप्ताक्षर शामिल हैं। आप इनका उपयोग सामग्री तालिकाओं को अधिक आसानी से जनरेट करने के लिए कर सकते हैं। एक हद तक। कमियों पर बाद में।
मैंने साइडबार को कई कारणों से शक्तिशाली लेकिन अनाड़ी पाया:
- नेविगेशन और स्टाइल एक साथ नहीं दिखाए जा सकते। Word में, नेविगेशन बाईं ओर स्थित है, स्टाइल दाईं ओर। यहां, यह एक फलक है, और आपको उनके बीच जुगलबंदी करनी होगी। यह बेकार है, और यह आपकी स्थितिजन्य जागरूकता को कम करता है (देखें, मैं यहां सैन्य शब्दजाल का उपयोग कर रहा हूँ)।
- स्टाइल सूची और नेविगेशन मार्कर दोनों आपके दस्तावेज़ में जहां आप हैं, और क्या चयनित है, के आधार पर कूदते हैं। यह भी बेकार है, क्योंकि मान लीजिए आप टेक्स्ट के एक टुकड़े को एक नए अद्वितीय स्टाइल के साथ चिह्नित करना चाहते हैं। Writer इन्हें सूची के नीचे जोड़ देगा। लेकिन अधिकांश टेक्स्ट सामान्य "Body" स्टाइल का उपयोग करता है, जो सूची के बहुत शीर्ष पर दिखाया जाता है। तो, हर बार, आपको स्क्रॉल करना होगा, नया स्टाइल चुनें, टेक्स्ट के दूसरे भाग का चयन करें, सूची कूदती है, दोहराएं। इसके अलावा, स्टाइल डबल क्लिक के साथ लागू होते हैं। बेकार।
- मुझे फुटनोट्स को संदर्भों की सूची में निर्यात करने का कोई आसान तरीका नहीं मिला।
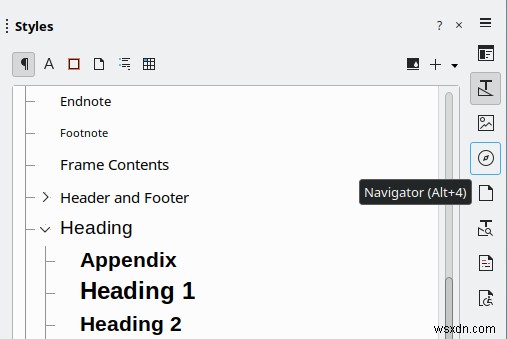
आप एक ही समय में स्टाइल और नेविगेटर दोनों नहीं देख सकते।
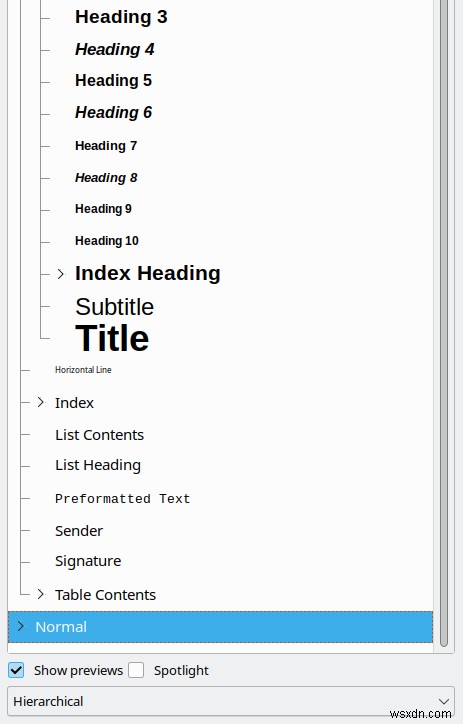
स्टाइल के माध्यम से स्क्रॉल करना मुश्किल हो सकता है।
अन्य मुद्दे भी थे। टेबल्स और आंकड़ों को सामग्री तालिकाओं में सही ढंग से दिखाने के लिए कैप्शन की आवश्यकता होती है, भले ही आप अपने स्वयं के स्टाइल का उपयोग करें। फिगर कैप्शन हमेशा पूरी तरह से प्रदर्शित होते हैं, इसलिए आप सामग्री तालिका के लिए पहला वाक्य नहीं कह सकते, और बाद में दस्तावेज़ में अधिक विस्तृत व्याख्या नहीं रख सकते। इसने मुझे वास्तव में छोटे कैप्शन का उपयोग करने के लिए मजबूर किया जो बात को याद करते हैं। मुझे पुस्तक में Image reference नामक एक पूरा सेक्शन जोड़ना पड़ा, जिसमें अधिक विस्तृत कैप्शन थे।
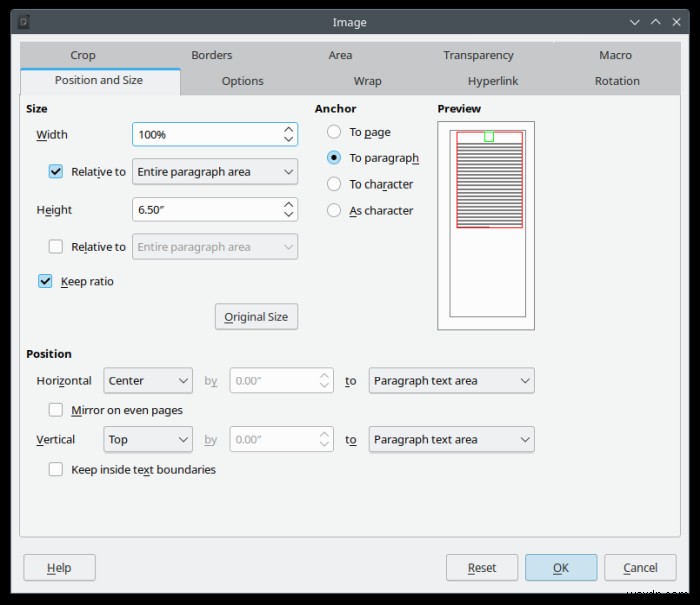
इमेज जोड़ना थोड़ा मेह था। हर बार, इमेज फ्लोट, सेंटर अलाइनमेंट पर सेट होती थी। क्यों? नोवरैप लेफ्ट-अलाइन विकल्प का उपयोग क्यों नहीं? मुझे हर एक इमेज को पेज की चौड़ाई में रीस्केल करना पड़ा, और सुनिश्चित करना पड़ा कि अनुपात सही ढंग से संरक्षित हैं। इसमें बहुत समय लगा, और मैं इन सेटिंग्स को आसानी से एक नए स्टाइल में निर्यात नहीं कर सका।
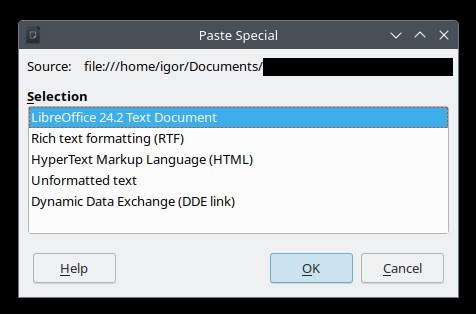
मैं पेस्ट फ़ंक्शन को भी थोड़ा अनाड़ी पाता हूँ। मान लीजिए आप अतिरिक्त फॉर्मेटिंग के साथ आने वाले टेक्स्ट के एक टुकड़े को कॉपी करते हैं। एक साधारण Ctrl + V सब कुछ पेस्ट करता है। Ctrl + Shift + V एक छोटी विंडो दिखाता है जहां आप चुन सकते हैं कि आप किस तरह का पेस्ट चाहते हैं। Ctrl + Shift + Alt + V अनफॉर्मेटेड पेस्ट करता है। अब, मैं इन दो शॉर्टकट को उल्टा पसंद करूंगा। क्योंकि यह प्रक्रिया को कठिन, धीमा बनाता है।
ये सभी प्रतीत होता है छोटी चीजें हैं, लेकिन जब आपको इनमें से 1,000 करने की आवश्यकता होती है, तो वे जुड़ जाते हैं। विशेष रूप से, कॉपी और पेस्ट विकल्प मेरे लिए मुश्किल था, खासकर उद्धरण और फुटनोट्स के साथ काम करते समय। मुझे अपना इंडेक्स मैन्युअल रूप से बनाना पड़ा, और प्रत्येक पेस्ट एक दर्द था।
Okular
Plasma का PDF प्रोग्राम Okular है। कुल मिलाकर, यह एक अच्छा टूल है, लेकिन मैंने इसे इतिहास पुस्तक पर अपने काम में गंभीर रूप से कम पाया। सबसे पहले, यह अपेक्षाकृत धीमा था। Firefox दस्तावेज़ों को लोड करने में Okular को उन्हीं फ़ाइलों को प्रदर्शित करने में लगे समय का लगभग 1/5वां हिस्सा लेता था। खोज फ़ंक्शन का उपयोग करके, Firefox वांछित स्ट्रिंग्स को अधिक तेज़ी से ढूंढता था, और यह मेल खाने वाली प्रविष्टियों की संख्या भी दिखाता था। Okular की खोज धीमी थी, और यह प्रदर्शित नहीं करता कि उसे कितने परिणाम मिले, एक या तिरानवे।
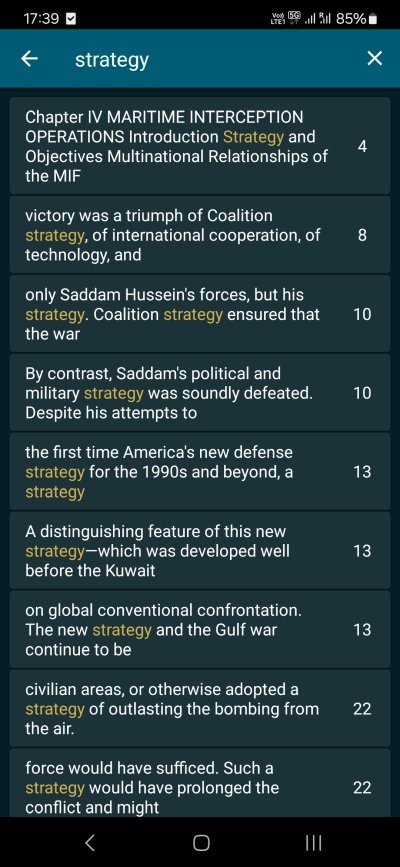
इस संबंध में, Microsoft Office इसे बहुत बेहतर करता है। Word आपको सभी प्रविष्टियाँ दिखाता है, लेकिन कुछ 20-30 शब्द भी जो खोज को लपेटते हैं, ताकि आप जो खोज रहे हैं उसे अधिक आसानी से चुन सकें। और फोन पर, मैं अपनी किताबों के लिए प्यारे Readera ऐप का उपयोग कर रहा था, और यहां भी, खोज आपको "आसपास के" शब्द देती है, इसलिए आपके पास अधिक संदर्भ है, और सटीक खोज प्रविष्टि का पता लगाना आसान है। इस पर जल्द ही और अधिक।
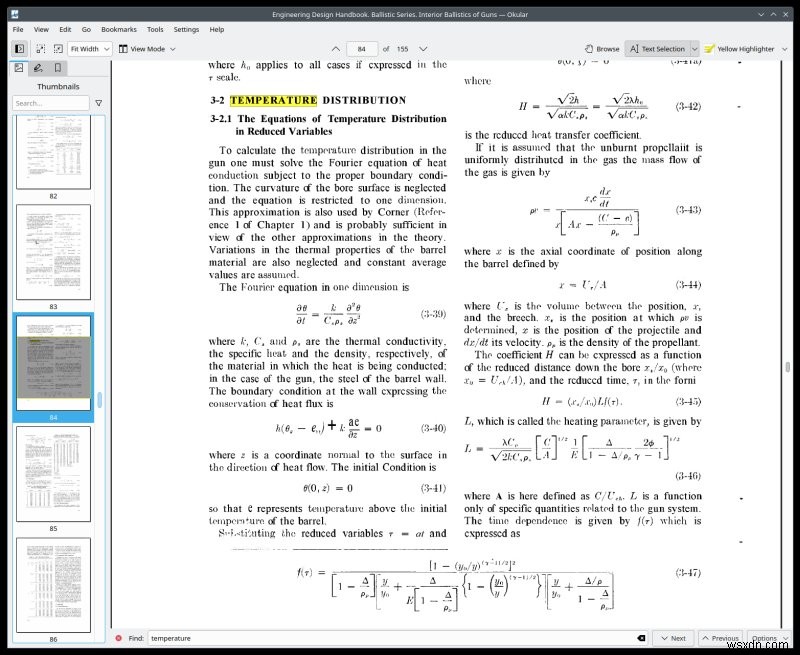
Okular की पेज नंबर और/या सेक्शन द्वारा नंबरिंग और नेविगेशन भी कभी-कभी अनाड़ी होती है। यह हमेशा वैसा काम नहीं करता जैसा मैंने उम्मीद की थी। यह मुश्किल था। यह देखते हुए कि मैंने लगभग 200 किताबें और लगभग दोगुनी रिपोर्ट और मोनोग्राफ पढ़े, सभी PDF फॉर्मेट में, Okular पर मेरी भारी निर्भरता ने मेरी उत्पादकता को थोड़ा नुकसान पहुंचाया।
यदि आपको एक साथ बहुत सारी फ़ाइलों के साथ काम करने की आवश्यकता है, तो आप एक और पहेली का सामना करते हैं। डिफ़ॉल्ट रूप से, Okular हर फ़ाइल को एक अलग इंस्टेंस में खोलता है। बुरा नहीं, लेकिन उनके माध्यम से जाना मुश्किल हो सकता है। मैंने Plasma के टास्क मैनेजर में Okular (और केवल Okular) को अनग्रुप करके इसे हल किया। इस पर बाद में और अधिक, लेकिन यह एक सुंदर और अनूठी चीज़ है जो केवल Plasma कर सकता है।
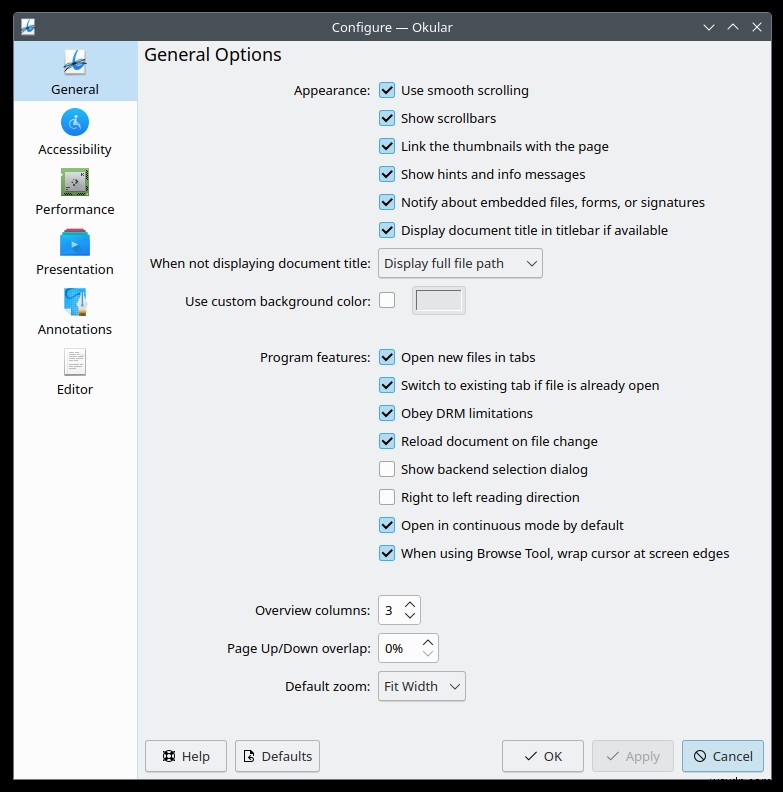
समस्या का दूसरा भाग यह है कि Okular शीर्षक के लिए जो भी मेटाडेटा ढूंढ सकता है उसका उपयोग करता है, इसलिए आप हमेशा यह नहीं बता सकते कि आप कौन सा दस्तावेज़ देख रहे हैं। आपको फ़ाइलों को मैन्युअल रूप से नाम बदलना होगा। और फिर, आप टैब का भी उपयोग कर सकते हैं। हाँ, Okular में एक टैब्ड इंटरफ़ेस है! लेकिन यह अजीब है। एक, यह आपको किसी भी क्षण खुले दस्तावेज़ों में कोई दृश्यता नहीं देता। दो, यदि आप कई इंस्टेंस और टैब के मिश्रण का उपयोग करते हैं, तो Okular हमेशा सबसे हालिया (अंतिम चयनित) इंस्टेंस में टैब जोड़ देगा, इसलिए आपके टैब हर जगह बिखरे होंगे। यदि आप किसी भी समय प्रोग्राम के एक से अधिक इंस्टेंस को खुले रहने की अनुमति देते हैं तो आपको वास्तव में टैब का उपयोग नहीं करना चाहिए। मेह।
GIMP, GwenView, Octave, Kate ...
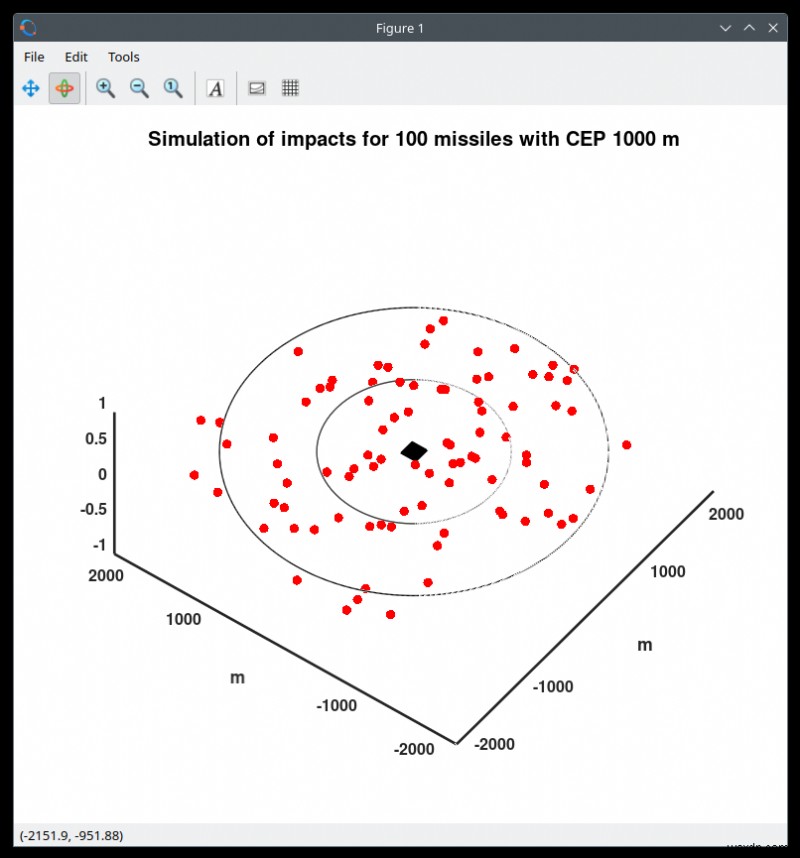
कुछ बुनियादी इमेज प्रोसेसिंग के लिए, GIMP ने काफी अच्छा किया - रोटेशन, पर्सपेक्टिव फिक्स, DPI, ऐसी चीजें। GwenView ने भी बिना किसी समस्या के सभी अलग-अलग इमेज फाइलों को संभाला। Octave, आह। जब भी मैं इसका उपयोग करता हूँ, मैं खुद को याद दिलाता हूँ कि Matlab जैसे प्रोग्राम डेटा विश्लेषण के लिए किसी भी "पारंपरिक" प्रोग्रामिंग भाषा से कितने बेहतर हैं। बीस साल पहले जब मैंने मेडिकल इंडस्ट्री में बहुत सारी इमेज और सिग्नल प्रोसेसिंग की थी, तब मैंने जो ज्ञान जमकर इस्तेमाल किया था, उस पर ब्रश करना भी मजेदार है। Octave बस मजेदार था। मुझे सांख्यिकी पैकेज (आर्काइव से) इंस्टॉल करना पड़ा, लेकिन इसके अलावा, चीजें ठोस थीं।
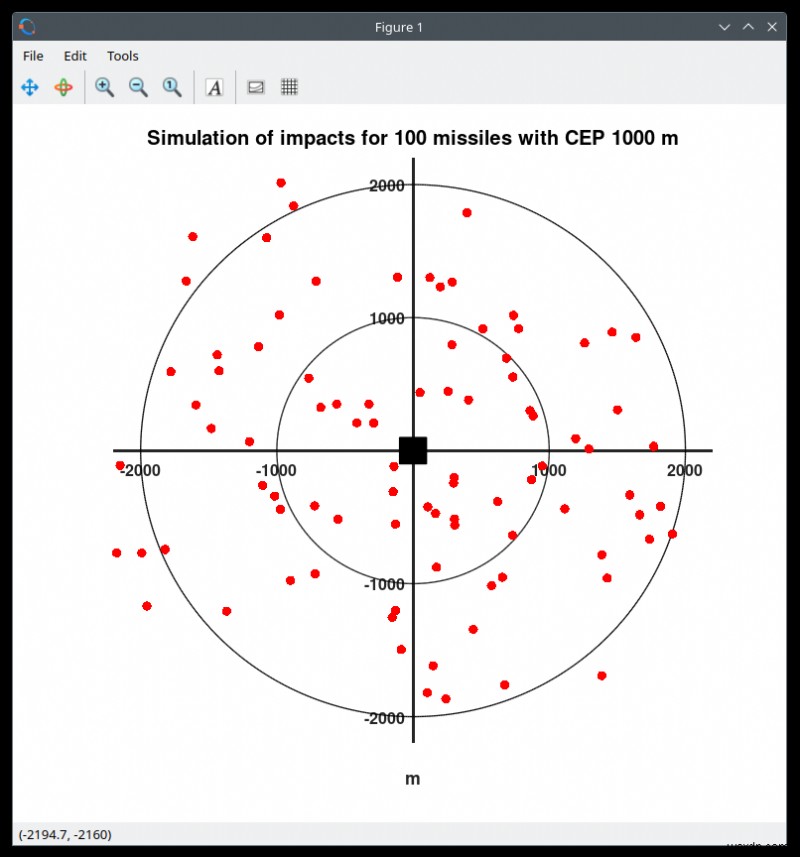
और आप 2D ग्राफ़ को भी स्वतंत्र रूप से घुमा सकते हैं। शानदार!
Kate ने उचित रूप से अच्छा व्यवहार किया। इसने खाली बफ़र्स को सहेजा, लेकिन खोज और बदलें अधिक कुशल हो सकते थे। खोज स्ट्रिंग्स को फ़ाइलों से अधिक आसानी से सहसंबंधित करना अच्छा होगा, लेकिन कुल मिलाकर, यह एक छोटी सी शिकायत है।
Plasma डेस्कटॉप
कुल मिलाकर, मेरी बहुत कम शिकायतें हैं। लेकिन कुछ छोटी-मोटी समस्याएं थीं। कभी-कभी, आइकन-ओनली टास्कबार कई खुले LibreOffice दस्तावेज़ों के लिए एक संकेतक (+ चिह्न) नहीं दिखाता था, और कभी-कभी यह दिखाता था, और केवल इस विशिष्ट प्रोग्राम के लिए। मैंने आपको हाल ही में दिखाया कि विभिन्न प्रोग्राम्स के लिए सेलेक्टिव ग्रुपिंग का उपयोग कैसे करें, और यह एक वास्तविक टाइम सेवर है।
डेस्कटॉप को डिफ़ॉल्ट रूप से स्टार्टअप पर आपके सत्र को पुनर्स्थापित करने के लिए कॉन्फ़िगर किया गया है। यह बहुत अच्छा काम करता है, लेकिन सभी प्रोग्राम्स के लिए नहीं। उदाहरण के लिए, LibreOffice, फिर से। यदि मैंने कोई दस्तावेज़ खुला छोड़ दिया, तो अगले सिस्टम रीबूट और स्टार्टअप पर, LibreOffice शिकायत करेगा कि यह क्रैश हो गया था, और फ़ाइलों को पुनर्प्राप्त करने का प्रयास करेगा। चिंताजनक। इसी तरह, GIMP सत्रों में दस्तावेज़ों को संरक्षित नहीं करता। क्या यह एक GTK चीज़ हो सकती है? मुझे यकीन नहीं है, लेकिन मैं खुश नहीं हूँ।
फिर से LibreOffice-वार, मुझे अलग-अलग विंडो आकार और स्थिति के साथ अलग-अलग दस्तावेज़ खोलने का कोई तरीका नहीं मिला, उदाहरण के लिए: एक को बाएं फ्लश रखें, डेस्कटॉप की आधी चौड़ाई, दूसरे को दाएं फ्लश रखें, और इसकी चौड़ाई डेस्कटॉप के दो तिहाई पर सेट करें, उदाहरण के लिए। शायद यह एक सामान्य Plasma सीमा है, लेकिन अगर इसके आसपास कोई तरीका होता तो अच्छा होता।
Kubuntu में मेरे द्वारा उपयोग किए गए विभिन्न Linux प्रोग्राम्स में, LibreOffice, Okular और GIMP सभी एक बार क्रैश हुए। मैं LibreOffice दस्तावेज़ों को ठीक से पुनर्प्राप्त करने में सक्षम था, लेकिन यह अभी भी डरावना था। GIMP का डेटा खो गया था। Okular में, मैं केवल फ़ाइलें देख रहा था (केवल पढ़ने के लिए), इसलिए कोई बड़ी बात नहीं।
ऑनलाइन सामान, नॉन-फ्री सामान, फोन और डेस्कटॉप कनेक्टिविटी
अब, कुछ अन्य चीजों के बारे में बात करते हैं जो मुझे करनी थीं, या बल्कि, करना चुना था। इस खंड में कुछ मालिकाना बिट्स और टुकड़े भी शामिल हैं, जैसे खोज और यहां और वहां पढ़ने के उपकरण के रूप में मेरे फोन का उपयोग। हम Android, Android के लिए Firefox (UBlock Origin के साथ, निश्चित रूप से), साथ ही वास्तविक किताब और दस्तावेज़ पढ़ने के लिए Readera की बात कर रहे हैं। फिर, मैं Android के स्टॉक Notes ऐप में नोट्स लूंगा, जिसे मैं बाद में KDE Connect का उपयोग करके अपने Linux डेस्कटॉप पर सिंक करूंगा। ओपन सोर्स और नॉन का मिश्रण। आइए विस्तार से बताएं।
खोज
कुल मिलाकर, वर्षों से, ऑनलाइन खोज सेवाएं गुणवत्ता और सटीकता में काफी गिर गई हैं। काफी। एक समय, आप वास्तव में जो चाहते थे उसे खोज सकते थे, और आपको वह मिल जाएगा, न कि जो सबसे अधिक लाभदायक लगता है उसकी एक अर्ध-क्यूरेटेड सूची। आज, यदि आप एक खोज क्वेरी टाइप करते हैं, यहां तक कि उद्धरण चिह्नों और site: क्वालिफायर के साथ, आपको अभी भी अक्सर यादृच्छिक कचरा, Youtube वीडियो के लिंक, और समान मिलेगा।
कुल मिलाकर, मैंने दो खोज इंजनों का उपयोग किया: Google और Bing। Google कुल मिलाकर औसत था, बहुत सारे "AI" सारांश के साथ जो बस उस चीज़ को उद्धृत करते हैं जो इसे शीर्ष परिणाम माना जाता है से गलत चीज़। जब टेक्स्ट की बात आई तो Bing ने और भी बुरा किया। हालांकि, Bing की इमेज खोज मेरी राय में Google से बेहतर है। हालांकि, दोनों को पुरानी छवियों, 60 और 70 के दशक की चीजों, यहां तक कि उन चीजों को खोजने में संघर्ष करना पड़ा जो सार्वजनिक डोमेन में हैं और विभिन्न सरकारी साइटों पर उपलब्ध हैं। Google ने उनको खोजने में थोड़ा बेहतर किया, लेकिन इमेज मिलान (फोटो द्वारा खोज) के साथ बहुत बुरा।
दिलचस्प बात यह है कि Google सामान्य खोजों के लिए खराब था लेकिन यह गूढ़ क्वेरीज़ के साथ अच्छा था जिनका कोई व्यावसायिक मूल्य नहीं है। वहां, इसने वास्तव में अपेक्षित अस्पष्ट संदर्भ और अजीब PDF और समान लौटाए। उदाहरण के लिए, यदि आप "World War II B-17 bomber ordnance CEP pattern Europe" जैसा कुछ टाइप करते हैं, तो आप जो चाहते हैं वह मिल जाएगा। Bing इस संबंध में थोड़ा बुरा था।
अनुवाद
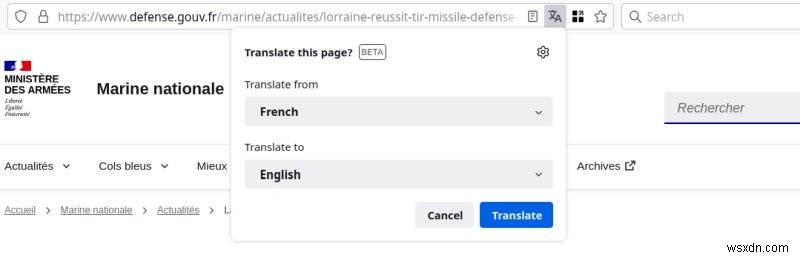
मैंने Firefox के बिल्ट-इन अनुवाद का उपयोग करने का चुनाव किया। यह क्लाउड-संचालित नहीं है, इसलिए यह एक बड़ा बोनस है। कुल मिलाकर, अनुवाद वास्तव में अच्छी तरह से काम करते थे। सबसे अच्छा हिस्सा है, आप अभी भी उन्हीं पेजों पर रहते हैं, URL नहीं बदलते, और यदि आप अपना नेविगेशन जारी रखते हैं, तो Firefox उस बिंदु से आगे ऑटो-अनुवाद करेगा। बहुत साफ और उपयोगी।
किताब पढ़ना, एनोटेशन, उद्धरण
Readera वास्तव में एक अच्छा ऐप है। उन कुछ मोबाइल उत्पादों में से एक जो वास्तव में अपने वजन के लायक मेगाबाइट्स में हैं। इसकी लाइब्रेरी में लगभग 200 किताबें लोड होने के साथ, मैं वास्तव में देख सकता था कि क्या यह मेरे लक्ष्यों को प्राप्त करने में मदद कर रहा था, अर्थात् उत्पादकता और आसान डेटा संगठन।
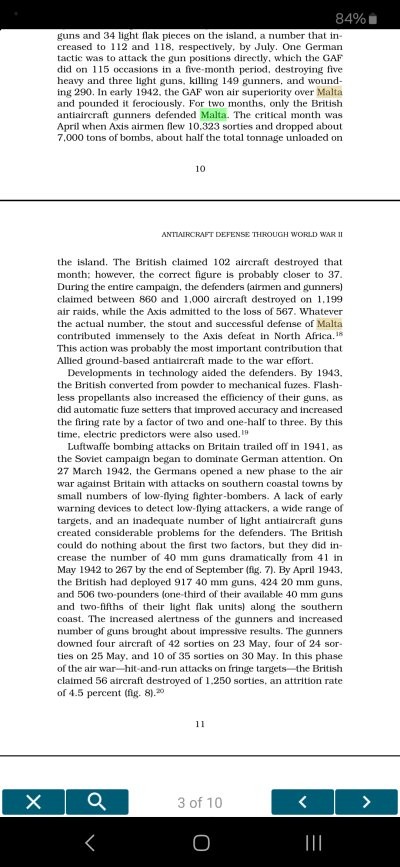
ठीक है, मैं किताबों को टैग्स द्वारा कैटलॉग करने में सक्षम था, इसलिए इससे कुछ मदद मिली। खोज उत्कृष्ट है। फिर, मैं कभी-कभी टेक्स्ट के टुकड़ों को हाइलाइट करता था, जिन्हें आप तब अनुवाद कर सकते हैं, ज़ोर से पढ़ सकते हैं, शेयर कर सकते हैं, या दस्तावेज़ में जोड़े गए उद्धरण के रूप में सहेज सकते हैं। एकमात्र समस्या यह है कि आपको प्रोग्राम के भुगतान किए गए संस्करण की आवश्यकता है ताकि आप अपने सभी उद्धरणों को एक बड़े एग्रीगेटेड व्यू में देख सकें। अन्यथा, आपको यह देखने के लिए प्रत्येक फ़ाइल खोलनी होगी कि क्या देता है, जो बात को याद करता है।
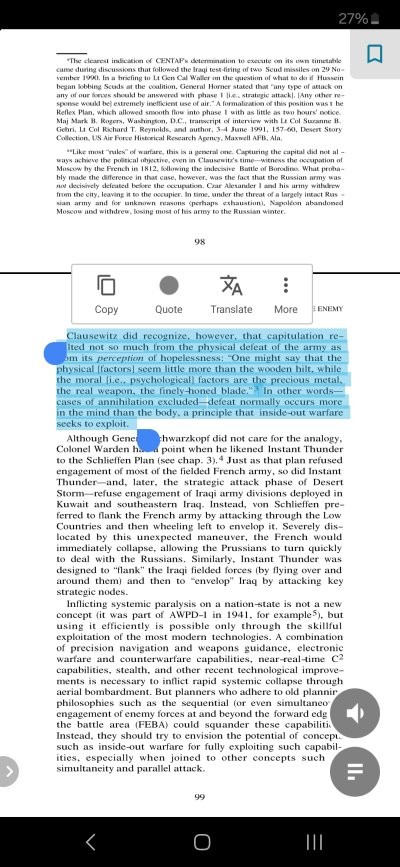

KDE Connect पर जाना काम कर सकता है, लेकिन जब मैं एक अलग नेटवर्क पर हूँ तो नहीं। इस पर जल्द ही और अधिक।
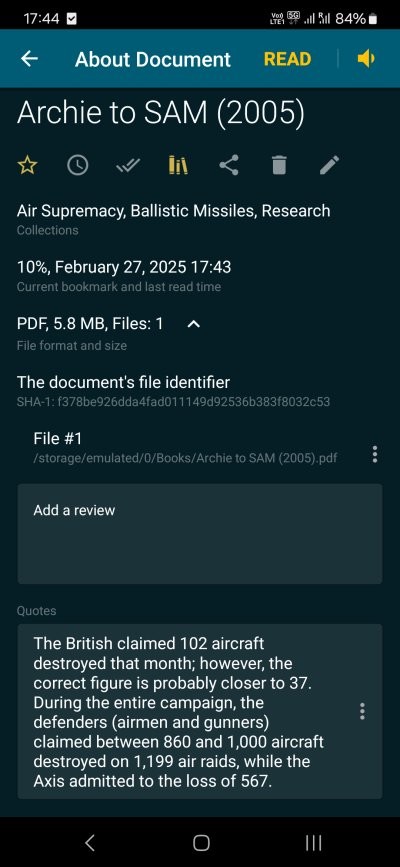
उत्कृष्ट उद्धरण-रखने की कार्यक्षमता।
इसके बजाय, मैं कभी-कभी एक अधिक सटीक हाइलाइटर के स्थान पर पेजों का स्क्रीनशॉट लेता था, लेकिन मेरे Samsung A54 पर ऐप मुझे वास्तव में ज्यादा नहीं बताता। ऐप का नाम, तारीख और समय, बस इतना ही। समय के साथ, मैं Readera के एडिट मोड में जाने से पहले स्नैप करके अपने नोट-कीपिंग स्क्रीनशॉट संग्रह में सुधार करूंगा, लेकिन फिर भी, आप हमेशा दस्तावेज़ का शीर्षक नहीं जान पाएंगे, या जिस पेज पर आप हैं उसे देख पाएंगे। अक्सर, मुझे एक मैन्युअल इंडेक्स रखने का सहारा लेना पड़ा, उदाहरण के लिए: एक नोट जो कहता है किताब X, पेज Y, स्क्रीनशॉट लेने का कारण, या क्यों एक विशेष उद्धरण या संदर्भ उपयोगी है। एक बार जब आपके पास इनमें से कुछ सौ हो जाते हैं, तो चीजों पर नज़र रखना काफी कठिन हो जाता है। लेकिन, यह प्रबंधनीय है। मुझे लगता है कि कई सौ किसी भी चीज़ पर नज़र रखना आसान नहीं है, अवधि।
मुझे यकीन है कि चीजों को करने के अधिक सुव्यवस्थित तरीके हैं। समस्या यह है, जब आप पढ़ रहे होते हैं, तो आप वास्तव में पढ़ना चाहते हैं, खासकर यदि आप एक या दो किताबें एक दिन में पढ़ना चाहते हैं। हर बार जब आपको रुकना पड़ता है और नोट बनाना पड़ता है तो यह एक विकर्षण है। फोन पर, यह स्पर्श इंटरफेस की सरल प्रकृति के कारण अतिरिक्त अनाड़ी है। कुल मिलाकर, यह अच्छा चला, और मुझे जो कर रहा हूँ उस पर नज़र रखने के लिए केवल छह अन्य ऐप्स का सहारा लिए बिना।
फोन और डेस्कटॉप सिंक
KDE Connect दर्ज करें। यह वास्तव में अच्छा काम करता था। KDE Connect, जिसे मैंने हाल ही में अपने लेख में उल्लेख किया था कि अपने स्थानीय, ऑफ़लाइन संगीत (MP3 और क्या नहीं) को iPhone पर कैसे सिंक करें, एक उत्कृष्ट, बहुउद्देशीय फोन सिंकिंग टूल है। यह आपको संपर्क, फ़ाइलें, क्लिपबोर्ड साझा करने, वॉल्यूम नियंत्रित करने, फोन रिंग करने, और टन अन्य सुविधाओं की अनुमति देता है। मुझे क्लिपबोर्ड टूल वास्तव में पसंद है। फोन पर, मैं बस अपने नोट्स की सामग्री को मार्क और कॉपी करूंगा, और KDE Connect के माध्यम से क्लिपबोर्ड शेयर करूंगा। फिर, मेरे Plasma डेस्कटॉप पर, मैं बस नोट्स ले सकता था। हो गया।
शेयर करने का एक नकारात्मक पहलू यह है कि यदि आप URLs को KDE Connect पर भेजते हैं, तो यह स्वचालित रूप से उन्हें ब्राउज़र में खोलने का प्रयास करेगा। इसलिए यदि आप कहते हैं 100 लिंक भेजते हैं, तो यह थोड़ा बोझ बन जाता है। टेक्स्ट का सरल शेयरिंग अधिक समझदार विकल्प लगता है। या कम से कम एक चेतावनी पॉप अप करें। ओह, हाँ, आपको अधिकांश चीजों के लिए नोटिफिकेशन की अनुमति देनी होगी।
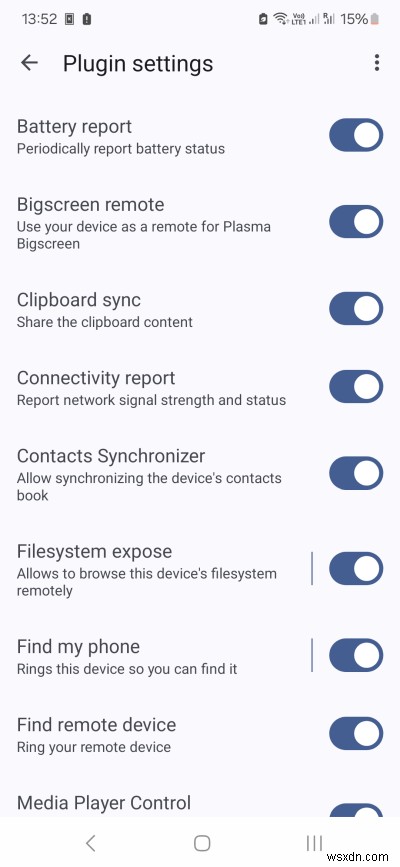
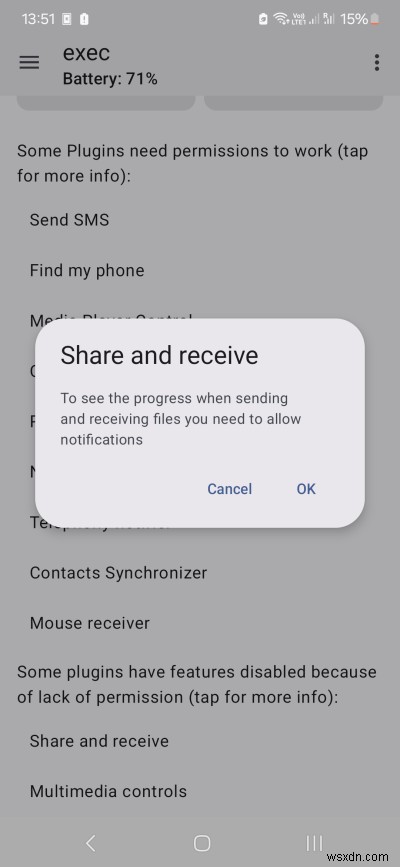
लेकिन फिर, बहुत अंतिम चरण...
आप इसे पसंद नहीं करने जा रहे हैं, लेकिन यह ODT फ़ाइल को Word में खोलना होगा, और इसे DOCX में बदलना होगा, ताकि मैं इसे एजेंटों और प्रकाशकों को भेज सकूं। यह पूरी श्रृंखला में सबसे कमजोर कड़ी बनी हुई है। कुल मिलाकर, मुझे LibreOffice के साथ काम करने में उचित मज़ा आया, लेकिन मैं इसके odt->docx रूपांतरण का उपयोग करने का जोखिम नहीं उठा सकता। यह सामान्य फिक्शन के लिए कुछ हद तक ठीक हो सकता है, जिसमें कोई टेबल या इमेज या कोई फैंसी फॉर्मेटिंग नहीं है। यहां? हम्म।
निष्कर्ष
इससे पहले कि आप कुछ भी कहें, हाँ मुझे पता है कि वहां "लेखन केंद्रित" ऐप्स और प्रोग्राम हैं। मुझे यह भी पता है कि मैंने कुछ चीजें अधिक कुशलता से की हो सकती हैं, और यहां, वास्तव में, मैं ईमेल के माध्यम से आपकी टिप्पणियों और सुझावों की सराहना करूंगा। बस याद रखें कि मैंने जानबूझकर खुद को सॉफ़्टवेयर में उलझने से बचाया, या छोटे, वृद्धिशील लाभों के लिए अपने शस्त्रागार में आधा दर्जन टूल जोड़ने से। मेरा लक्ष्य लिखना था, और मैंने तीन महीनों में लगभग 100K शब्द लिखे। नॉनफिक्शन के लिए, यह बहुत है। सामान्य तौर पर, यह एक बहुत तेज गति है। इसका मतलब है कि मेरा वर्कफ़्लो सभी चीजों को ध्यान में रखते हुए काफी अच्छा था।
कुछ अनाड़ी बिट्स थे। मेरा सामान्य अवलोकन है, हाँ, आप मुफ्त टूल्स के साथ जटिल किताबें लिख सकते हैं। मुझे याद दिलाने की जरूरत नहीं, मुझे पता है कि LaTeX और LyX मौजूद हैं, मैंने उनके बारे में टन लिखा है। मुझे पता है कि आप LaTeX से सीधे ईबुक भी बना सकते हैं। मैं एक साधारण वर्ड प्रोसेसर का उपयोग करना चाहता था, क्योंकि मुझे प्रकाशन उद्योग के लोगों के साथ बातचीत करने की आवश्यकता है जिनके लिए Word THE Word है। यह वह जगह है जहां मेरी FOSS कहानी थोड़ी उलझ जाती है, लेकिन ऐसा लगता है कि इसके आसपास कोई रास्ता नहीं है।
LibreOffice Writer ने अच्छा किया। इसने बड़ी पांडुलिपि को ठीक से संभाला, लेकिन इसमें बहुत सारे उत्पादकता मुद्दे हैं, जैसे स्टाइल और नेविगेशन हैंडलिंग। मैंने वहां टन और टन माउस क्लिक बर्बाद किए। Okular थोड़ा मेह था। अन्य टूल्स ने उचित रूप से ठीक काम किया। बड़ा मुद्दा क्रॉस-प्रोग्राम डेटा शेयरिंग, उद्धरण और उद्धरणों को इंडेक्स करने में कठिनाई, और दस्तावेज़ों के अंदर और दस्तावेज़ों में सीमित खोज प्रतीत होता है। यदि कोई वहाँ बाहर इस लेख में कुछ उपयोगी डली देखता है, और इन्हें फ्री, ओपन-सोर्स लेखन टूल्स को और भी बेहतर बनाने के लिए लागू किया जा सकता है, तो बढ़िया।
अब, इस नॉनफिक्शन काम पर वास्तविक अपडेट के लिए बने रहें, ताकि मैं वास्तव में इसका नाम प्रकट कर सकूं, आपको कुछ विवरण दे सकूं, और ऊपर की छवियों में जानकारी को खाली करने जैसी चीजें करना बंद कर सकूं। फिर से, एजेंट और प्रकाशक कुछ चीजों के बारे में काफी उधम मचाते हैं, तो वहां। तो सरल उत्तर है, हाँ, आप इसे Linux और FOSS के साथ कर सकते हैं। लगभग 90%। ध्यान रखें, दोस्तों।
चीयर्स।