एल्गोरिदम विश्लेषण में हम ऑपरेशन और चरणों को गिनते हैं। यह मूल रूप से उचित है जब कंप्यूटर किसी ऑपरेशन को करने में डेटा लाने से अधिक समय लेता है जिसकी उस ऑपरेशन के लिए आवश्यकता होती है। आजकल ऑपरेशन करने की लागत मेमोरी से डेटा लाने की लागत से काफी कम है।
कई एल्गोरिदम का रन टाइम ऑपरेशन की संख्या के बजाय मेमोरी रेफरेंस की संख्या (कैश मिस की संख्या) से प्रभावित होता है। इसलिए, जब हम कुछ एल्गोरिदम डिजाइन करने का प्रयास करेंगे, तो हमें न केवल ऑपरेशन की संख्या बल्कि मेमोरी एक्सेस की संख्या को कम करने पर ध्यान केंद्रित करना होगा। साथ ही उन एल्गोरिदम को डिजाइन करने पर ध्यान केंद्रित करना होगा जो मेमोरी लेटेंसी को छिपाते हैं।
मान लें एक सरल कंप्यूटर मॉडल है जिसमें कंप्यूटर की मेमोरी में L1 कैश, L2 कैश, और मुख्य मेमोरी शामिल है। हम ALU का उपयोग करके रजिस्टर (R) में मौजूद डेटा पर अंकगणितीय और तार्किक ऑपरेशन करते हैं
इसका ब्लॉक डायग्राम नीचे है -
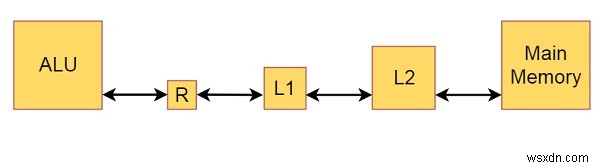
डायग्राम से हम मेमोरी और कैश के आकार के बारे में कुछ ज्ञान भी प्राप्त कर सकते हैं। मुख्य मेमोरी मूल रूप से सैकड़ों या हजारों MB होती है। जहां L2 कैश MBs का कुछ अंश होता है और L1 कैश कुछ KB होते हैं। रजिस्टर का आकार कुछ बिट्स होता है। जब हम एक प्रोग्राम निष्पादित करते हैं, तो सभी डेटा मेमोरी में होता है। यदि हम ADD जैसे कुछ ऑपरेशन जोड़ते हैं, तो पहली संख्या रजिस्टर में संग्रहीत होगी, रजिस्टर में डेटा जोड़ा जाता है, फिर परिणाम मेमोरी में लिखा जाता है।
मान लें एक साइकिल वह समय है जो रजिस्टर में पहले से मौजूद डेटा को जोड़ने के लिए आवश्यक होगा। L1 कैश से रजिस्टर में डेटा लोड करने के लिए आवश्यक समय इस मॉडल में दो साइकिल मान लें। यदि आवश्यक डेटा L1 कैश में नहीं हैं लेकिन L2 कैश में मौजूद हैं, तो हमें L1 कैश मिस मिलती है और आवश्यक डेटा L2 कैश से L1 कैश और रजिस्टर में 10 साइकिल में ले लिए जाते हैं। जब हमारे आवश्यक डेटा L2 कैश में भी नहीं होते, तो हमें L2 कैश मिस मिलती है और आवश्यक डेटा मुख्य मेमोरी से L2 कैश, L1 कैश, और रजिस्टर में 100 साइकिल में ले लिए जाएंगे। फिर राइट ऑपरेशन को एक साइकिल के रूप में गिना जाता है भले ही डेटा मुख्य मेमोरी में लिखा जाता है, क्योंकि हम अगले ऑपरेशन पर आगे बढ़ने से पहले पूर्ण लिखने की प्रतीक्षा नहीं करते हैं।