Computer >> कंप्यूटर ट्यूटोरियल >  >> प्रोग्रामिंग >> प्रोग्रामिंग

डेटा संरचना में बाइनरी हीप


हीप या बाइनरी हीप संतुलित बाइनरी ट्री डेटा संरचना का एक विशेष मामला है। यह कम्पलीट बाइनरी ट्री संरचना है। इसलिए l-1 स्तरों तक यह पूर्ण है, और l स्तर पर, सभी नोड्स बाएं से हैं। यहां रूट नोड की की की तुलना उसके बच्चों से की जाती है और तदनुसार व्यवस्थित किया जाता है। यदि a का चाइल्ड नोड b है तो -

key(a) ≥ key(b)

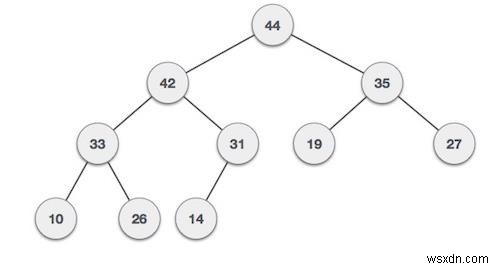
चूंकि पैरेंट का मान चाइल्ड से अधिक है, यह गुण मैक्स हीप उत्पन्न करता है। इस मानदंड के आधार पर, हीप दो प्रकार के हो सकते हैं: मैक्स हीप और मिन हीप।

ये क्रमशः मैक्स और मिन हीप के उदाहरण हैं -
डेटा संरचना में बाइनरी हीप


डेटा संरचना में बाइनरी हीप

  1. डेटा संरचना में R-ट्री (R-trees) डेटा संरचना में R-ट्री (R-trees)

    यहाँ हम R-ट्री (R-Trees) डेटा संरचना देखेंगे। R-ट्री का उपयोग विशेष डेटा इंडेक्स को कुशलतापूर्वक संग्रहीत करने के लिए किया जाता है। यह संरचना विशेष डेटा क्वेरी और भंडारण को रखने के लिए बहुत उपयोगी है। R-ट्री के कुछ वास्तविक जीवन अनुप्रयोग हैं: बहुआयामी जानकारी इंडेक्स करना गेम डेटा संभालना भू-स्था

  1. डेटा स्ट्रक्चर में बाइनरी ट्री ADT डेटा स्ट्रक्चर में बाइनरी ट्री ADT

    मूल अवधारणा (Basic Concept) बाइनरी ट्री को एक ऐसे ट्री के रूप में परिभाषित किया जाता है जिसमें कोई भी नोड दो से अधिक बच्चे (Children) नहीं रख सकता। किसी भी नोड की उच्चतम डिग्री (Degree) दो होती है। इसका अर्थ है कि बाइनरी ट्री की डिग्री शून्य, एक या दो हो सकती है। उपरोक्त आकृति में, बाइनरी ट्री मे

  1. हाफएज डेटा स्ट्रक्चर (Halfedge Data Structure) हाफएज डेटा स्ट्रक्चर (Halfedge Data Structure)

    परिचय (Introduction) टेम्पलेट पैरामीटर्स के लिए HDS या हाफएज डेटा स्ट्रक्चर (Halfedge Data Structure - संक्षिप्त HalfedgeDS) को एक एज-केंद्रित डेटा स्ट्रक्चर (Edge-centered Data Structure) के रूप में परिभाषित किया जाता है जो वर्टेक्स, एज और फेसेस (Vertices, Edges and Faces) की घटना जानकारी (Incidenc