डेटा विश्लेषण टूलपैक एक्सेल की सबसे अच्छी विशेषताओं में से एक है जब हमें उन्नत सांख्यिकीय विश्लेषण करने की आवश्यकता होती है। यदि आप एक्सेल में डेटा विश्लेषण टूलपैक का उपयोग करने के लिए कुछ विशेष तरकीबें ढूंढ रहे हैं, तो आप सही जगह पर आए हैं। एक्सेल में डेटा विश्लेषण टूलपैक का उपयोग करने के कई तरीके हैं। यह लेख एक्सेल डेटा विश्लेषण टूलपैक का उपयोग करने के तेरह उपयुक्त उदाहरणों पर चर्चा करेगा। यह सब सीखने के लिए पूरी गाइड का पालन करें।
एक्सेल में डेटा विश्लेषण टूलपैक सक्षम करने के चरण
एक्सेल डेटा विश्लेषण टूलपैक की सभी विशेषताओं का विश्लेषण करने से पहले, हमें यह दिखाना होगा कि इस टूलपैक को कैसे इंस्टॉल किया जाए। यहां हम डेटा विश्लेषण टूलपैक को एक्सेल में सक्षम करने का तरीका दिखाने जा रहे हैं। ऐसा करने के लिए आपको निम्नलिखित प्रक्रिया का पालन करना होगा।
📌 चरण:
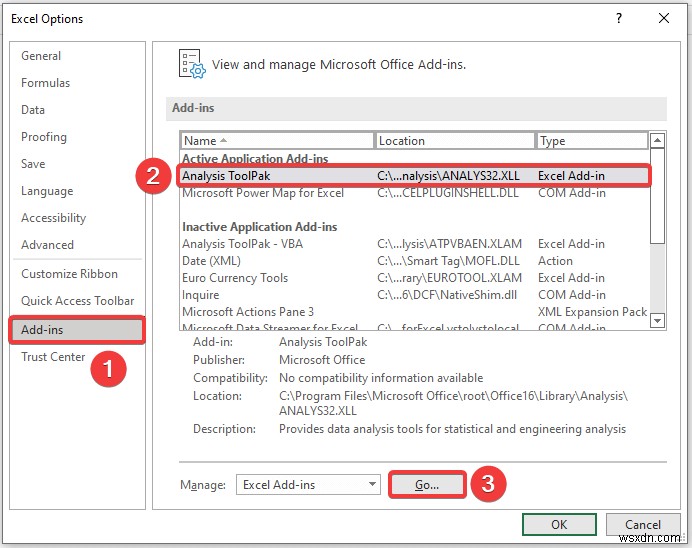
- सबसे पहले, फ़ाइल से विकल्प पर जाएं।
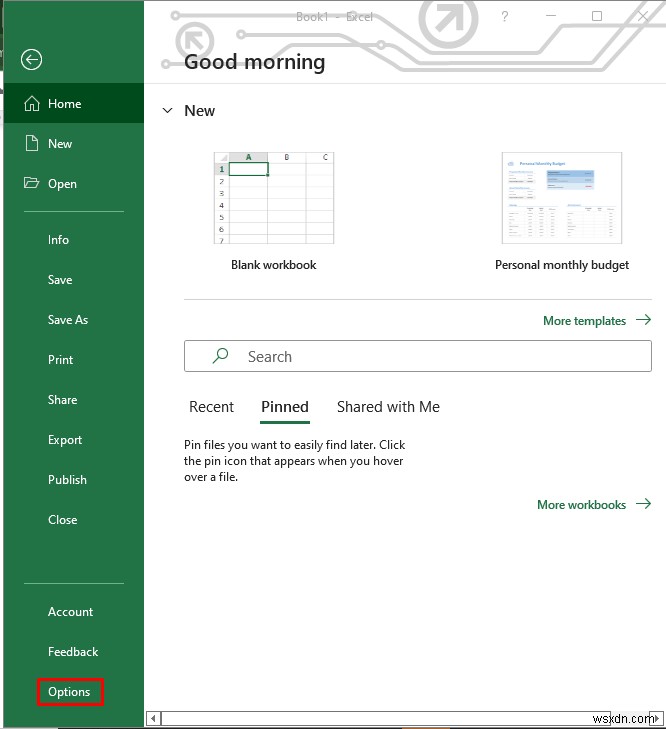
- फिर, ऐड-इन्स पर जाएं।
- यहां, प्रबंधित ड्रॉप-डाउन मेनू में एक्सेल ऐड-इन्स चुनें।
- और जाएं पर क्लिक करें।
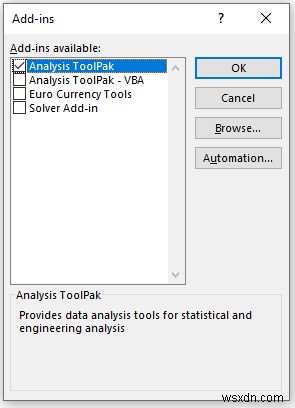
- फिर, एक नई विंडो दिखाई देगी।
- यहां, विकल्प विश्लेषण टूलपैक को चिह्नित करें। और ओके पर क्लिक करें। इस तरह आप एक्सेल डेटा विश्लेषण टूलपैक को सक्रिय कर पाएंगे।
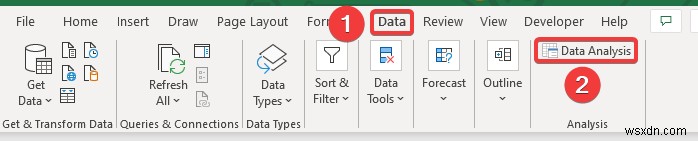
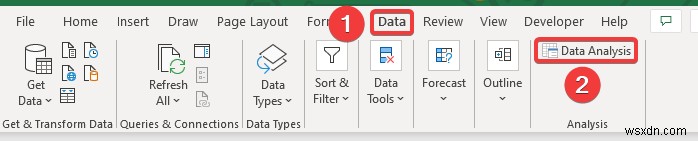
- अब, डेटा टैब में विश्लेषण मेनू पर जाएं। यहां आपको डेटा विश्लेषण विकल्प मिलेगा।
डेटा विश्लेषण टूलपैक की 13 शानदार विशेषताएं जिनका आप एक्सेल में उपयोग कर सकते हैं
हम एक्सेल में डेटा विश्लेषण टूलपैक का उपयोग करने के तेरह प्रभावी और मुश्किल तरीकों का उपयोग करेंगे। यहां, हम एक्सेल डेटा विश्लेषण टूलपैक की तेरह विशेषताओं को प्रदर्शित करेंगे। यह खंड तेरह तरीकों पर विस्तृत विवरण प्रदान करता है। आप अपने उद्देश्य के लिए उनमें से किसी एक का उपयोग कर सकते हैं, उनके पास अनुकूलन के मामले में लचीलेपन की एक विस्तृत श्रृंखला है। आपको इन सभी को सीखना और लागू करना चाहिए, क्योंकि वे आपकी सोच क्षमता और एक्सेल ज्ञान में सुधार करते हैं। हम यहां माइक्रोसॉफ्ट ऑफिस 365 संस्करण का उपयोग कर रहे हैं, लेकिन आप अपनी पसंद के अनुसार किसी अन्य संस्करण का उपयोग कर सकते हैं।
1. एनोवा विश्लेषण
एनोवा यह निर्धारित करने का पहला अवसर प्रदान करता है कि किन कारकों का दिए गए डेटा सेट पर महत्वपूर्ण प्रभाव पड़ता है। विश्लेषण पूरा होने के बाद, एक विश्लेषक उन पद्धतिगत कारकों पर अतिरिक्त विश्लेषण करता है जो डेटा सेट की असंगत प्रकृति को महत्वपूर्ण रूप से प्रभावित करते हैं। और वह अनुमानित प्रतिगमन विश्लेषण से संबंधित अतिरिक्त डेटा बनाने के लिए f-test में एनोवा विश्लेषण निष्कर्षों का उपयोग करता है। एनोवा विश्लेषण एक साथ कई डेटा सेट की तुलना करता है ताकि यह देखा जा सके कि क्या उनके बीच कोई संबंध है। एनोवा एक सांख्यिकीय विधि है जिसका उपयोग डेटासेट के भीतर देखे गए विचरण का विश्लेषण करने के लिए किया जाता है जिसे दो खंडों में विभाजित किया जाता है: 1) प्रणालीगत कारक और 2) यादृच्छिक कारक
एनोवा का सूत्र:
F=MSE / MST
यहां:
F = एनोवा गुणांक
MST = उपचार के कारण वर्गों का माध्य योग
MSE = त्रुटि के कारण वर्गों का माध्य योग
एनोवा दो प्रकार का होता है: एकल कारक और दो कारक। विधि विचरण विश्लेषण से संबंधित है।
- दो कारकों में, कई आश्रित चर होते हैं और एक कारक में, एक आश्रित चर होगा।
- एकल-कारक एनोवा एक एकल चर पर एक एकल कारक के प्रभाव की गणना करता है। और यह जांचता है कि सभी नमूना डेटा सेट समान हैं या नहीं।
- एकल-कारक एनोवा कई चरों के औसत माध्य के बीच सांख्यिकीय रूप से महत्वपूर्ण अंतर की पहचान करता है।
1.1 एकल कारक एनोवा विश्लेषण
यहां, हम दिखाएंगे कि एकल कारक एनोवा विश्लेषण कैसे करें। आइए पहले आपको हमारे एक्सेल डेटासेट से परिचित कराते हैं ताकि आप समझ सकें कि हम इस लेख के साथ क्या हासिल करने की कोशिश कर रहे हैं। हमारे पास कारकों के समूह को दिखाने वाला एक डेटासेट है। आइए एकल कारक एनोवा विश्लेषण करने के चरणों के माध्यम से चलते हैं।
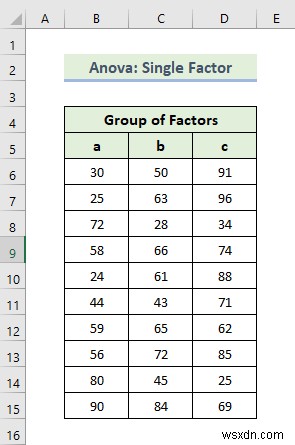
📌 चरण:
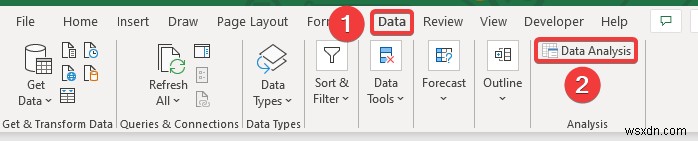
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
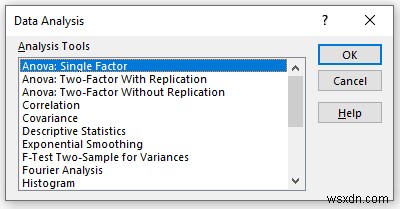
- जब डेटा विश्लेषण विंडो दिखाई दे, तो एनोवा: एकल कारक विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
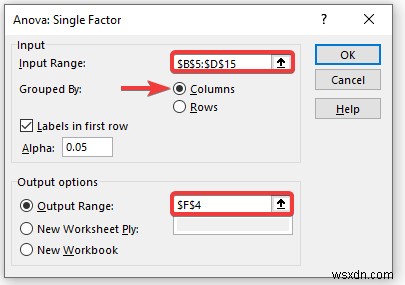
- अब, एनोवा: एकल कारक विंडो खुल जाएगी।
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर एनोवा विश्लेषण द्वारा निर्धारित करना चाहते हैं।
- पहली पंक्ति में लेबल नामक बॉक्स को चेक करें।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि आप लेबल के साथ इनपुट डेटा रेंज चुनते हैं तो पहली पंक्ति में लेबल को चेक करना होगा।
- फिर, ओके पर क्लिक करें।
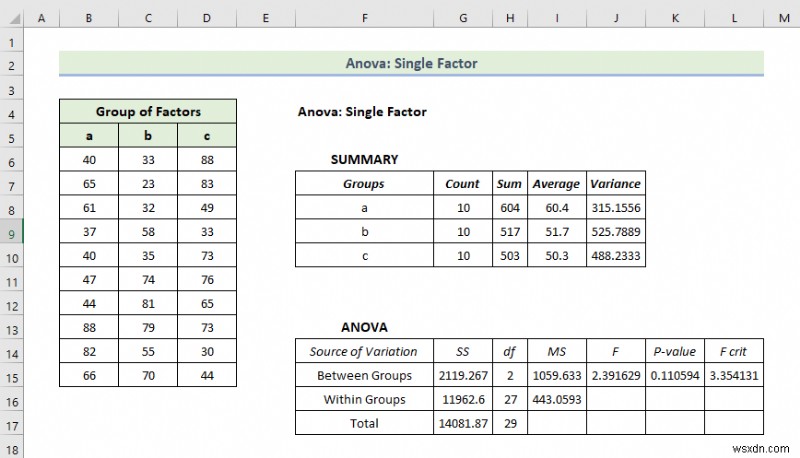
- परिणामस्वरूप, एनोवा परिणाम नीचे दिखाए अनुसार होंगे।
परिणाम की व्याख्या:
- सारांश तालिका में, आपको प्रत्येक समूह का औसत और विचरण मिलेगा। यहां आप देख सकते हैं कि औसत स्तर समूह a के लिए 60.4 है लेकिन विचरण 315.15 है जो अन्य समूहों की तुलना में बहुत कम है। इसका मतलब है कि समूह के सदस्य कम मूल्यवान हैं।
- यहां, एनोवा परिणाम उतने महत्वपूर्ण नहीं हैं क्योंकि आप केवल विचरण की गणना कर रहे हैं।
- यहां, P-मान कॉलम और मानों के बीच संबंध की व्याख्या करते हैं और 0.05 से अधिक हैं इसलिए यह सांख्यिकीय रूप से महत्वपूर्ण नहीं है। और कॉलम के बीच कोई संबंध भी नहीं होना चाहिए।
1.2 एनोवा: प्रतिकृति के साथ दो कारक
यहां, हम प्रतिकृति के साथ दो-कारक एनोवा विश्लेषण दिखाने जा रहे हैं। मान लीजिए आपके पास एक स्कूल के विभिन्न परीक्षा स्कोर पर कुछ डेटा है। उस स्कूल में दो शिफ्ट हैं। एक सुबह की शिफ्ट के लिए है दूसरी दिन की शिफ्ट के लिए। आप दो शिफ्ट के छात्रों के अंकों के बीच संबंध खोजने के लिए तैयार डेटा का डेटा विश्लेषण करना चाहते हैं। आइए प्रतिकृति के साथ दो-कारक एनोवा विश्लेषण करने के चरणों के माध्यम से चलते हैं।
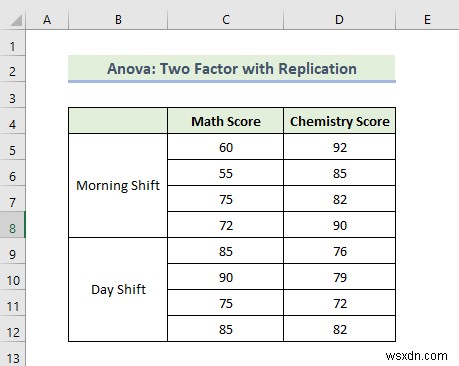
📌 चरण:
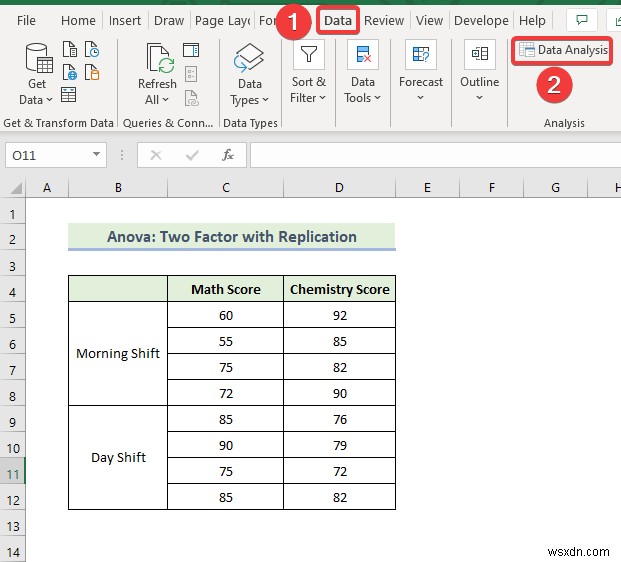
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
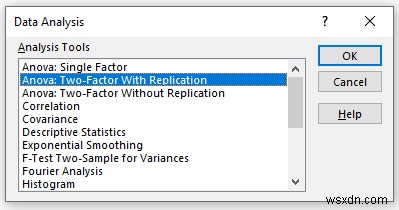
- जब डेटा विश्लेषण विंडो दिखाई दे, तो एनोवा: प्रतिकृति के साथ दो-कारक विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
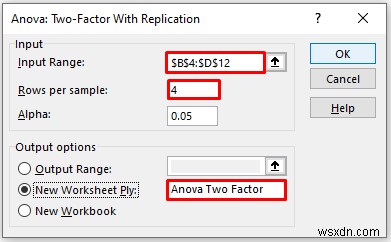
- अब, एक नई विंडो दिखाई देगी।
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर एनोवा विश्लेषण द्वारा निर्धारित करना चाहते हैं।
- अगला, प्रति नमूना पंक्तियाँ बॉक्स में 4 इनपुट करें क्योंकि आपके पास प्रति शिफ्ट 4 पंक्तियाँ हैं।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- फिर, ओके पर क्लिक करें।
- परिणामस्वरूप, आप एक नई वर्कशीट बनते हुए देखेंगे।
- और, दो-तरफा एनोवा परिणाम इस वर्कशीट में दिखाया गया है।
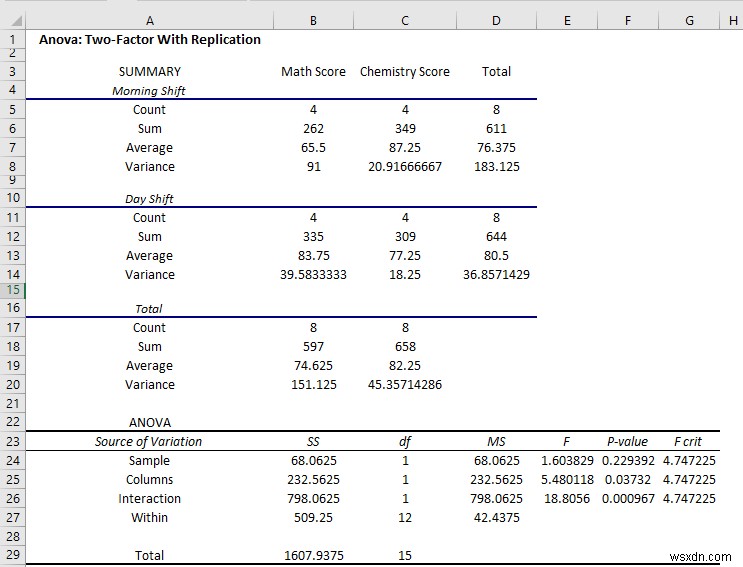
परिणाम की व्याख्या:
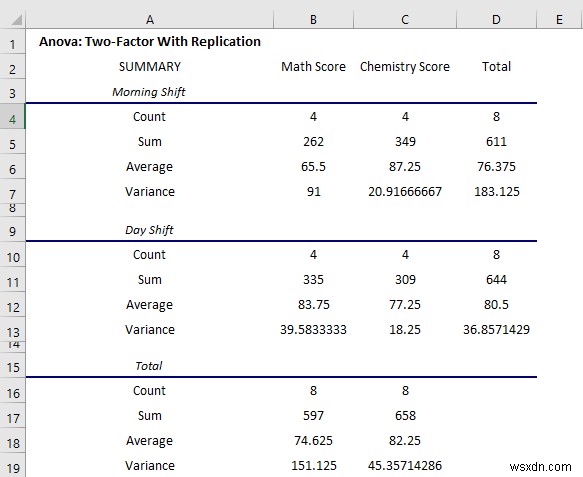
यहां, पहली तालिकाएं शिफ्ट का सारांश दिखा रही हैं। संक्षेप में:
- सुबह की शिफ्ट में गणित स्कोर का औसत 65.5 है लेकिन दिन की शिफ्ट में 83.75 है
- लेकिन जब रसायन विज्ञान परीक्षा में, सुबह की शिफ्ट में औसत स्कोर 87.25 है, लेकिन दिन की शिफ्ट में 77.25 है।
- विचरण सुबह की शिफ्ट में गणित परीक्षा में 91 पर बहुत अधिक है।
- आप सारांश में डेटा का पूरा अवलोकन प्राप्त करेंगे।
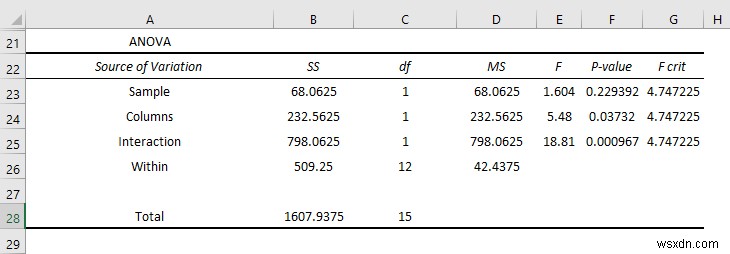
इसी तरह, आप एनोवा भाग में इंटरैक्शन और व्यक्तिगत प्रभावों को सारांशित कर सकते हैं। संक्षेप में:
- कॉलम का P-मान 0.037 है जो सांख्यिकीय रूप से महत्वपूर्ण है इसलिए आप कह सकते हैं कि परीक्षा में छात्रों के प्रदर्शन पर शिफ्ट का प्रभाव है। लेकिन मान अल्फा मान 0.05 के करीब है इसलिए प्रभाव कम महत्वपूर्ण है।
- लेकिन इंटरैक्शन का P-मान 0.000967 है जो अल्फा मान से बहुत कम है इसलिए यह सांख्यिकीय रूप से बहुत महत्वपूर्ण है और आप कह सकते हैं कि दोनों परीक्षाओं पर शिफ्ट का प्रभाव बहुत अधिक है।
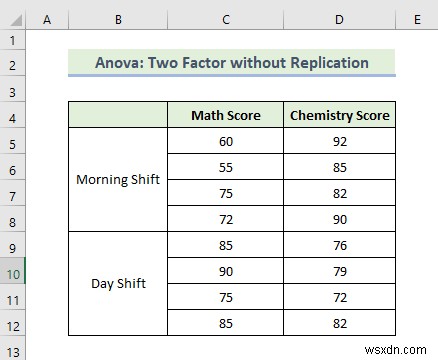
1.3 एनोवा: बिना प्रतिकृति के दो कारक
अब, हम बिना प्रतिकृति के दो कारक एनोवा विश्लेषण की विधि का पालन करके विचरण विश्लेषण करने जा रहे हैं। हम मान लीजिए आपके पास एक स्कूल के विभिन्न परीक्षा स्कोर पर कुछ डेटा है। उस स्कूल में दो शिफ्ट हैं। एक सुबह की शिफ्ट के लिए है दूसरी दिन की शिफ्ट के लिए। आप दो शिफ्ट के छात्रों के अंकों के बीच संबंध खोजने के लिए तैयार डेटा का डेटा विश्लेषण करना चाहते हैं। आइए बिना प्रतिकृति के दो कारक एनोवा विश्लेषण करने के चरणों के माध्यम से चलते हैं।
📌 चरण:
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
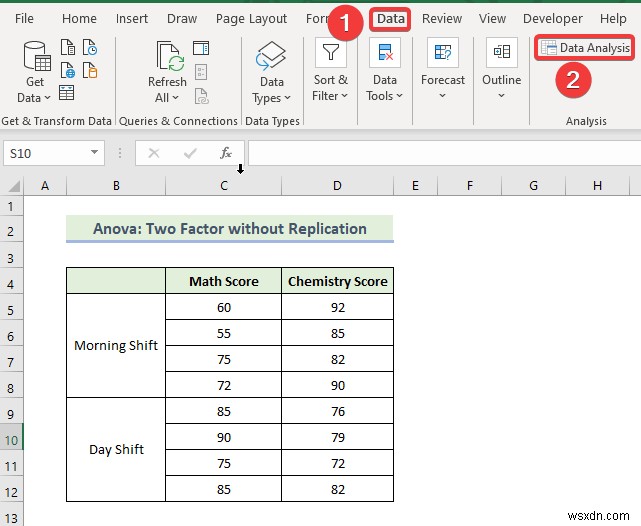
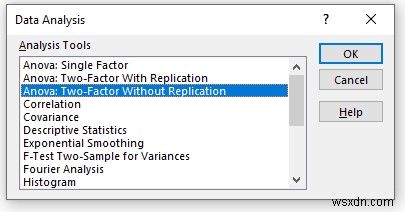
- जब डेटा विश्लेषण विंडो दिखाई दे, तो "एनोवा: बिना प्रतिकृति के दो-कारक" विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
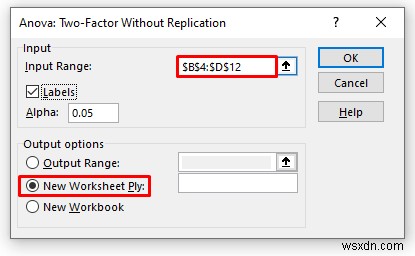
- अब, एक नई विंडो दिखाई देगी।
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर एनोवा विश्लेषण द्वारा निर्धारित करना चाहते हैं।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
- परिणामस्वरूप, आप एक नई वर्कशीट बनते हुए देखेंगे।
- परिणामस्वरूप, आपको नीचे दिखाए अनुसार दो-तरफा एनोवा परिणाम मिलेगा।
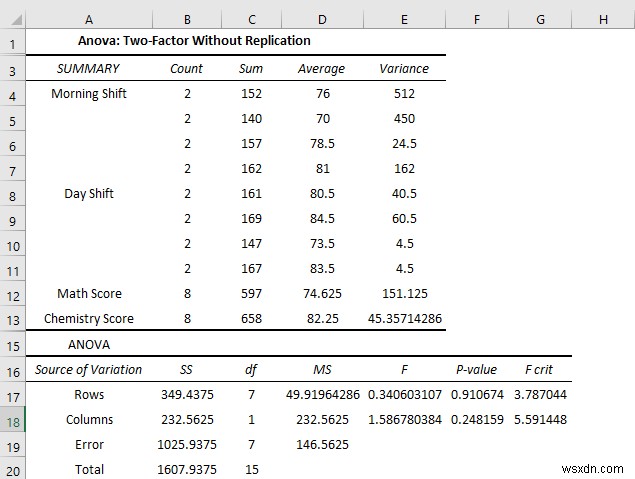
परिणाम की व्याख्या:
- सुबह की शिफ्ट में गणित स्कोर का औसत 65.5 है लेकिन दिन की शिफ्ट में 83.75 है
- लेकिन जब रसायन विज्ञान परीक्षा में, सुबह की शिफ्ट में औसत स्कोर 87 है लेकिन दिन की शिफ्ट में 77.25 है।
- कॉलम का P-मान 0.24 है जो सांख्यिकीय रूप से महत्वपूर्ण है इसलिए आप कह सकते हैं कि परीक्षा में छात्रों के प्रदर्शन पर शिफ्ट का प्रभाव है। लेकिन मान अल्फा मान 0.05 के करीब है इसलिए प्रभाव कम महत्वपूर्ण है।
और पढ़ें: एक्सेल में डेटा विश्लेषण कैसे जोड़ें (2 त्वरित चरणों के साथ)
2. सहसंबंध विश्लेषण
अब, हम एक सहसंबंध डेटा विश्लेषण करने जा रहे हैं जो एक्सेल डेटा विश्लेषण टूलपैक की एक शानदार विशेषता है। सांख्यिकी में, सहसंबंध या सहसंबंध गुणांक किसी अन्य के निरंतर उतार-चढ़ाव मात्रा के जवाब में दो चरों के बीच सुसंगतता दिखाने का पैरामीटर है। इसका मान -1 से +1 तक होता है। इसलिए, चर संबंधों को परिभाषित करने की इसकी तीन अवस्थाएं हैं। वे हैं:
- -1 नकारात्मक सहसंबंध इंगित करता है जिसका अर्थ है कि चर विपरीत दिशा में बदलते हैं।
- +1 सकारात्मक सहसंबंध इंगित करता है जिसका अर्थ है कि चर एक ही दिशा में बदलते हैं।
- 0 कोई सहसंबंध नहीं इंगित करता है जिसका अर्थ है कि अन्य चरों के मान बदलने पर किसी चर में किसी भी दिशा में कोई स्पष्ट गति नहीं होती है।
यहां, हमारे पास अलग-अलग समय अवधि में दो स्टॉक की कीमतों वाला एक डेटासेट है। आइए सहसंबंध डेटा विश्लेषण करने के चरणों के माध्यम से चलते हैं।
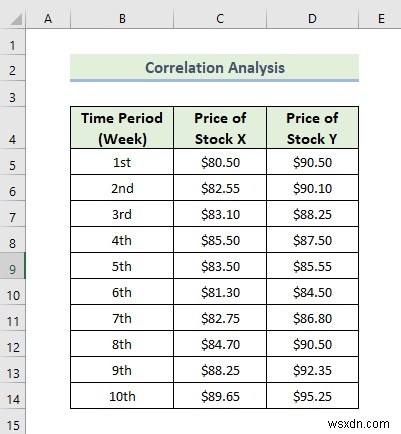
📌 चरण:
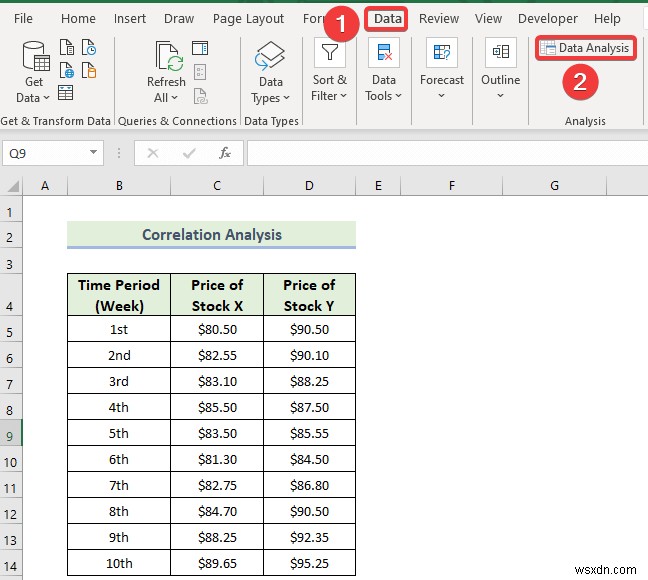
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
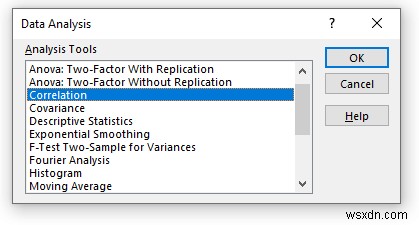
- जब डेटा विश्लेषण विंडो दिखाई दे, तो सहसंबंध विकल्प चुनें।
- अगला, ओके पर क्लिक करें।
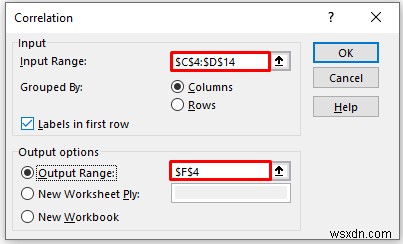
- अब, एक नई विंडो दिखाई देगी।
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर सहसंबंध की गणना करना चाहते हैं।
- अब, आपको समूहीकृत द्वारा विकल्प में स्तंभ विकल्प को चेक करना होगा।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो पहली पंक्ति में लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
- परिणामस्वरूप, आपको निम्न सहसंबंध परिणाम मिलेगा।
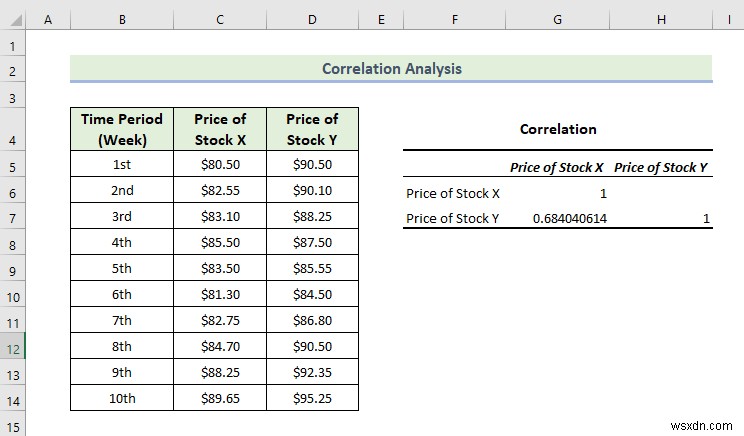
उपरोक्त गणना से, हम एक सकारात्मक सहसंबंध देख सकते हैं जिसका अर्थ है कि चर एक ही दिशा में बदलते हैं।
और पढ़ें: एक्सेल में टाइम सीरीज डेटा का विश्लेषण कैसे करें (आसान चरणों के साथ)
3. सहविचरण विश्लेषण
अब, हम सहविचरण डेटा विश्लेषण करने जा रहे हैं जो एक्सेल डेटा विश्लेषण टूलपैक की एक शानदार विशेषता है। दो चरों का सहविचरण इस बात का माप है कि उनमें से एक दूसरे को कैसे प्रभावित करता है। स्पष्ट रूप से, यह दो चरों के बीच विचलन का एक आवश्यक मूल्यांकन है। इसके अलावा, चरों को एक-दूसरे पर निर्भर नहीं होना पड़ता। आइए सहविचरण डेटा विश्लेषण करने के चरणों के माध्यम से चलते हैं।
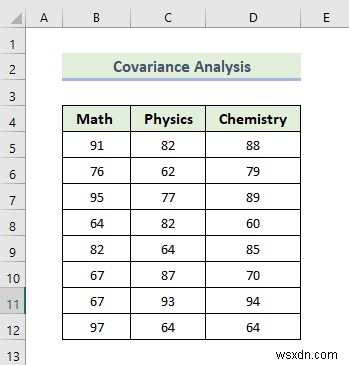
📌 चरण:
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
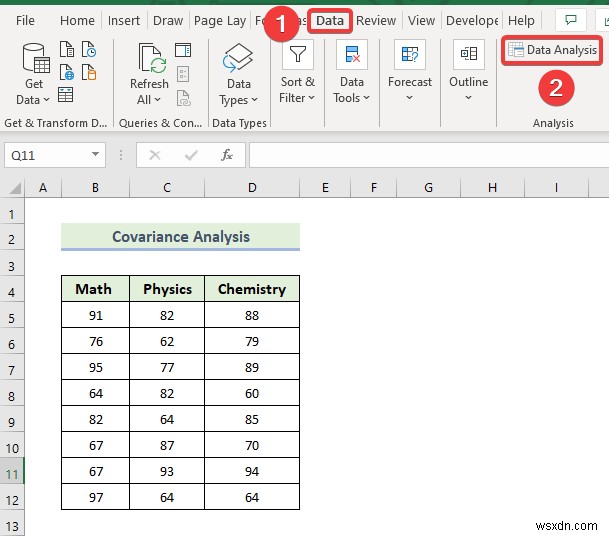
- जब डेटा विश्लेषण विंडो दिखाई दे, तो सहविचरण विकल्प चुनें।
- फिर, एंटर दबाएं।
- फिर, ओके पर क्लिक करें।
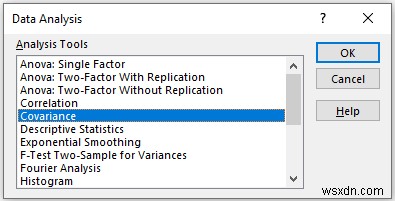
- अब, एक नई विंडो दिखाई देगी।
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर सहविचरण की गणना करना चाहते हैं।
- अब, आपको समूहीकृत द्वारा अनुभाग में स्तंभ विकल्प को चेक करना होगा।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो पहली पंक्ति में लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
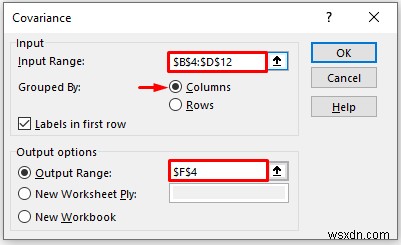
- परिणामस्वरूप, आपको निम्न सहविचरण परिणाम मिलेगा।
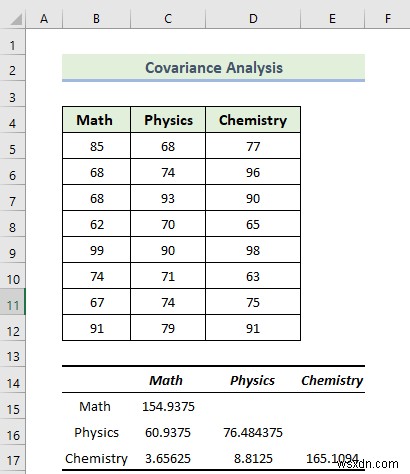
परिणाम की व्याख्या:
सहसंबंध मैट्रिक्स हमें कई चरों और एकल चरों के बीच संबंधों का आकलन करने की अनुमति देता है। निम्न छवि से हाइलाइट किया गया भाग प्रत्येक विषय के लिए विचरण इंगित करता है।
- गणित का विचरण 154.9375 है और भौतिकी का विचरण 76.484375 है। अगला, रसायन विज्ञान का विचरण 154.9375 है।
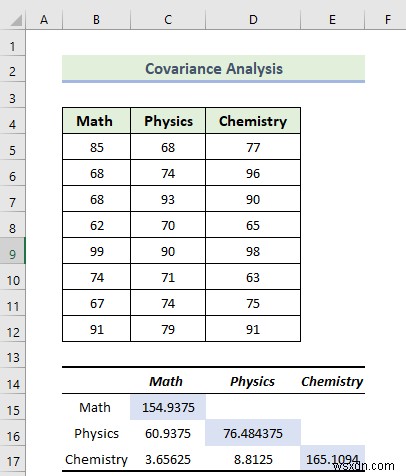
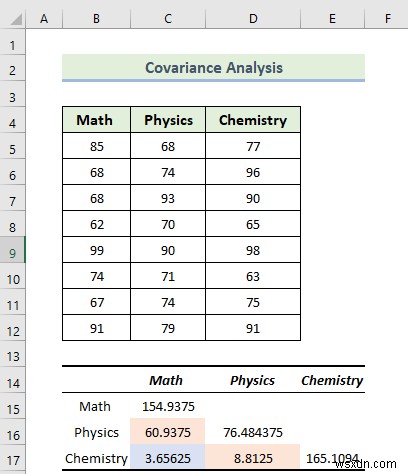
निम्न छवि से हाइलाइट किया गया भाग दो विषयों के बीच विचरण के मान इंगित करता है। गणित और भौतिकी, गणित और रसायन विज्ञान, और भौतिकी और इतिहास का विचरण मान क्रमशः 60.9375, 3.65625, और 8.8125 है। जब इस मामले में सहविचरण सकारात्मक होता है, तो यह इंगित करता है कि चर आनुपातिक हैं, अर्थात जब एक बढ़ता है, तो दूसरा भी साथ-साथ बढ़ता है।
और पढ़ें: [ठीक:] डेटा विश्लेषण एक्सेल में नहीं दिख रहा (2 प्रभावी समाधान)
4. वर्णनात्मक सांख्यिकी विश्लेषण
अब, हम वर्णनात्मक सांख्यिकी विश्लेषण कैसे करें, यह दिखाने जा रहे हैं। एक्सेल डेटा विश्लेषण टूलपैक हमें एक डेटासेट का विश्लेषण करके उसकी विशेषताओं को निर्धारित करने के लिए वर्णनात्मक सांख्यिकी विश्लेषण करने की अनुमति देता है। यहां, हमारे पास प्रत्येक छात्र के लिए भौतिकी स्कोर वाला एक डेटासेट है। आइए सहसंबंध डेटा विश्लेषण करने के चरणों के माध्यम से चलते हैं।
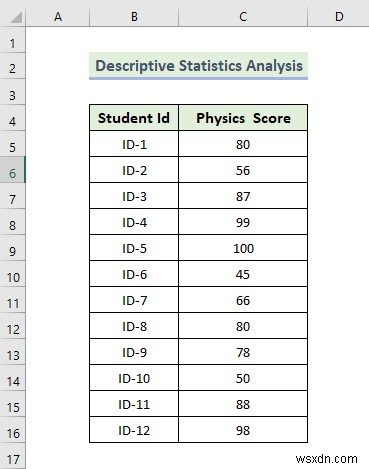
📌 चरण:
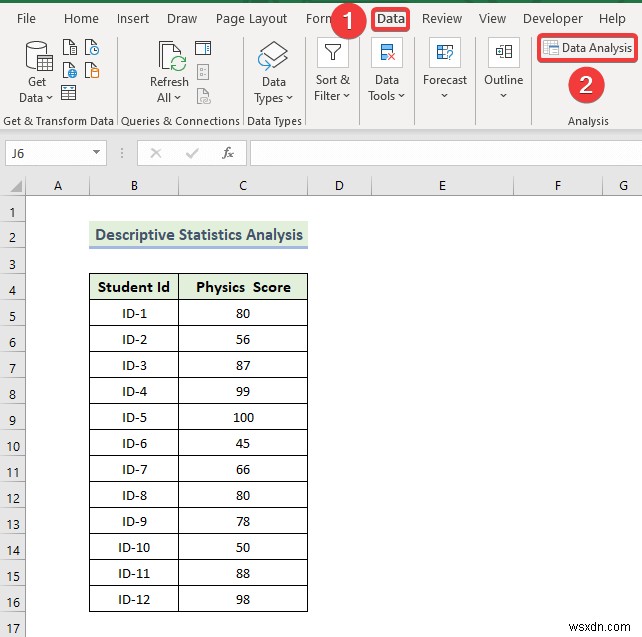
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
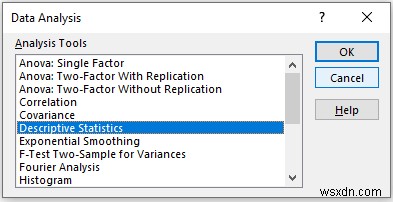
- जब डेटा विश्लेषण विंडो दिखाई दे, तो वर्णनात्मक सांख्यिकी विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
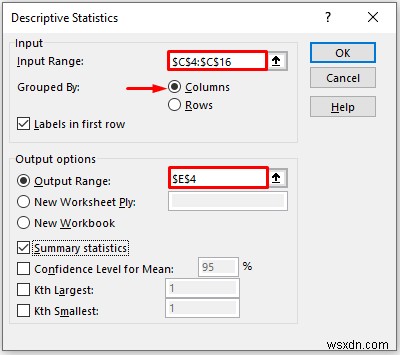
- अब, एक नई विंडो दिखाई देगी।
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर वर्णनात्मक सांख्यिकी की गणना करना चाहते हैं।
- अब, आपको समूहीकृत द्वारा अनुभाग में स्तंभ विकल्प को चेक करना होगा।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- फिर, सारांश सांख्यिकी चेक करें।
- फिर, ओके पर क्लिक करें।
- परिणामस्वरूप, आपको निम्न सहविचरण परिणाम मिलेगा।
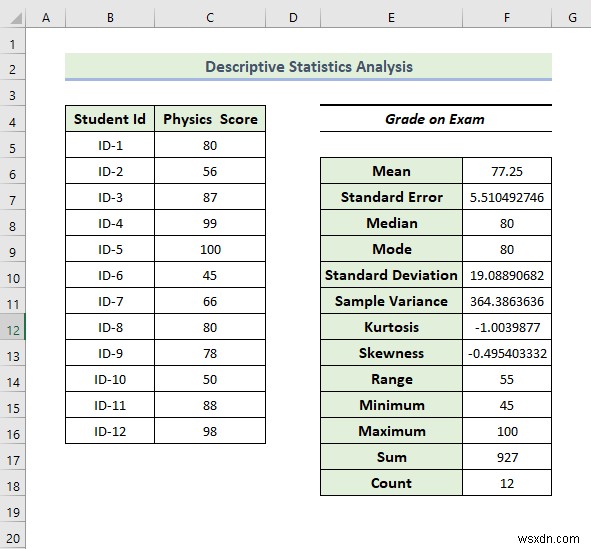
- उपरोक्त परिणाम हमें दो चरों की विशेषताएं देता है, यानी माध्य, माध्यिका, मानक विचलन, और डेटासेट का अधिकतम और न्यूनतम मान, जो क्रमशः 77.25, 80, 19.088, 45, और 100 हैं।
और पढ़ें: एक्सेल में डेटा विश्लेषण का उपयोग कैसे करें (5 आसान तरीके)
5. घातीय स्मूथिंग विश्लेषण
अब, हम घातीय स्मूथिंग विश्लेषण कैसे करें, यह दिखाने जा रहे हैं। एक्सेल डेटा विश्लेषण टूलपैक हमें व्यावसायिक मात्रा के संबंध में उचित निर्णय लेने के लिए घातीय स्मूथिंग करने की अनुमति देता है। यहां, हमारे पास एक निर्माण कंपनी द्वारा विभिन्न हफ्तों में बेची गई वस्तुओं की संख्या वाला एक डेटासेट है। आइए घातीय स्मूथिंग डेटा विश्लेषण करने के चरणों के माध्यम से चलते हैं।
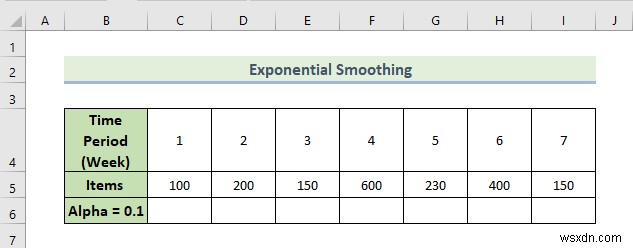
📌 चरण:
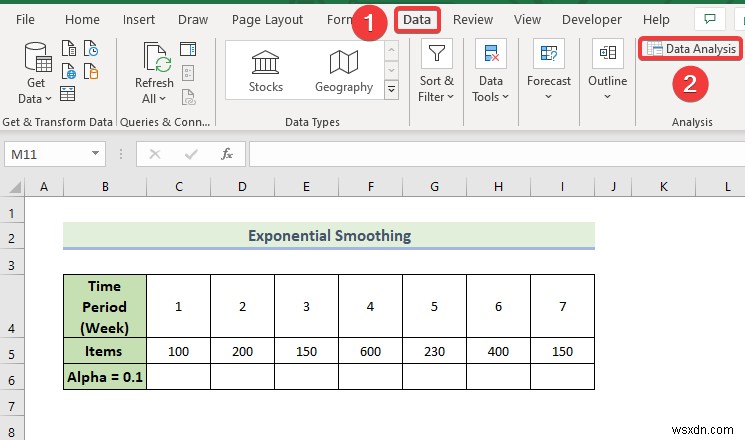
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
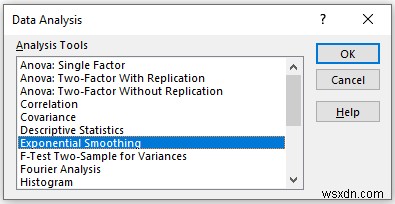
- जब डेटा विश्लेषण विंडो दिखाई दे, तो घातीय स्मूथिंग विकल्प चुनें.
- फिर, ओके पर क्लिक करें।
- अब, एक नई विंडो दिखाई देगी।
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर घातीय स्मूथिंग की गणना करना चाहते हैं।
- अब, आपको डैम्पिंग कारक बॉक्स में 0.9 दर्ज करना होगा। यहां, हम डैम्पिंग 1-अल्फा कर रहे हैं
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो लेबल चेक करना होगा।
- फिर, चार्ट आउटपुट चेक करें।
- फिर, ओके पर क्लिक करें।
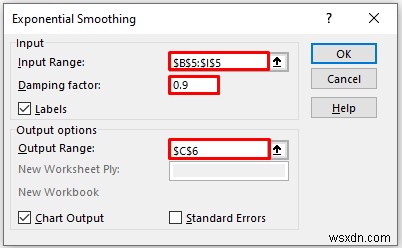
- परिणामस्वरूप, आपको 0.1 अल्फा के लिए निम्न घातीय स्मूथिंग परिणाम और चार्ट मिलेगा।
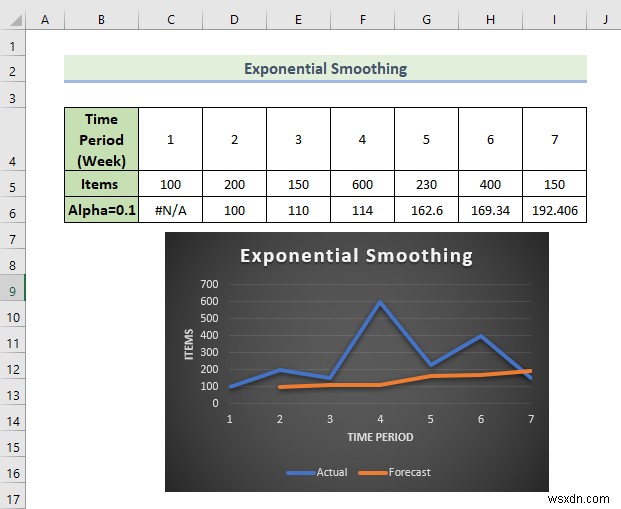
यहां, उपरोक्त परिणाम से, हम कह सकते हैं कि एक्सेल इस विधि में पहले मान के लिए डेटा प्रदान नहीं कर सकता। यदि हम एक बड़ा डैम्पिंग कारक उपयोग करते हैं, तो हमें अधिक चिकनी चोटियां और घाटियां मिलेंगी।
6. विचरण के लिए F-परीक्षण दो-नमूना विश्लेषण
अब, हम दो नमूना विचरण के लिए F-परीक्षण करने जा रहे हैं। दो चरों के विचरण का उपयोग करके, F-परीक्षण एक्सेल में सांख्यिकीय विश्लेषण प्रदान करता है। यहां, हमारे पास एक निर्माण कंपनी द्वारा विभिन्न हफ्तों में दो वस्तुओं की बिक्री कीमतों वाला एक डेटासेट है। आइए दो नमूना विचरण के लिए f-परीक्षण करने के चरणों के माध्यम से चलते हैं।
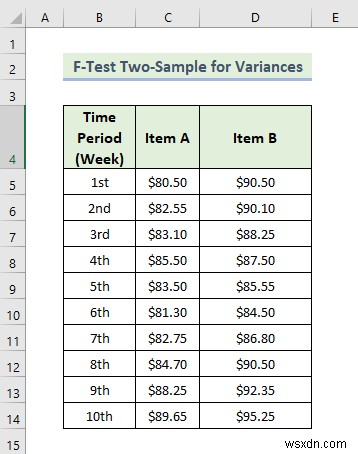
📌 चरण:
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
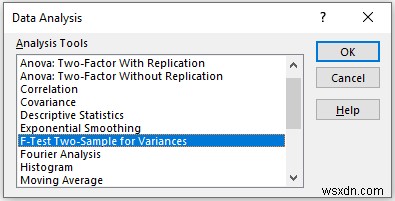
- फिर, डेटा विश्लेषण टूल चुनें।
- जब डेटा विश्लेषण विंडो दिखाई दे, तो विचरण के लिए F-परीक्षण दो-नमूना विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
- अब, एक नई विंडो दिखाई देगी।
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर F-परीक्षण की गणना करना चाहते हैं।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
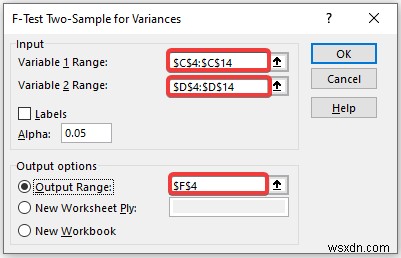
- परिणामस्वरूप, आपको दो नमूना विचरण के लिए F-परीक्षण का निम्न परिणाम मिलेगा।
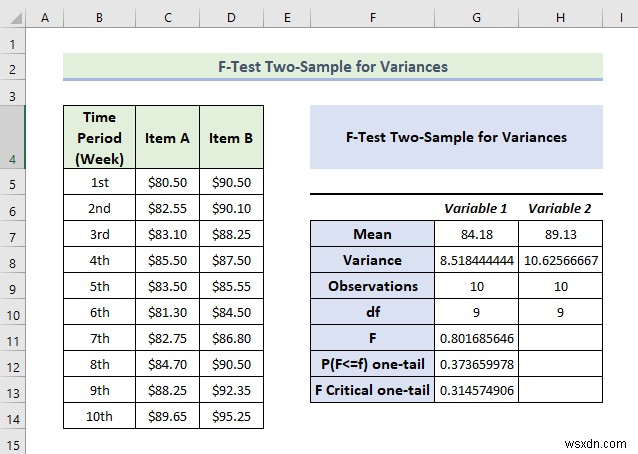
परिणाम की व्याख्या:
- उपरोक्त डेटा से, हम देख सकते हैं कि चर 2 का माध्य मान चर 1 से अधिक है।
- हम यह भी जानते हैं कि यदि F का मान F क्रिटिकल एक-पूंछ मान से अधिक है, तो इस मामले में हम कह सकते हैं कि यह शून्य परिकल्पना का पालन नहीं करता। उपरोक्त डेटा में, F का मान .8016 है और F क्रिटिकल एक-पूंछ का मान 0.3145 है जो इंगित करता है कि F, F क्रिटिकल एक-पूंछ से बहुत अधिक है। दूसरे शब्दों में, दो चरों के बीच विचरण मेल नहीं खाते।
7. मूविंग एवरेज विश्लेषण
अब, हम मूविंग एवरेज विश्लेषण करने जा रहे हैं जो एक्सेल डेटा विश्लेषण टूलपैक की सर्वोत्तम विशेषताओं में से एक है। मूविंग एवरेज का मतलब है कि औसत की समय अवधि समान होती है लेकिन जब नया डेटा जोड़ा जाता है तो यह चलती रहती है। मूविंग एवरेज डेटा से किसी भी अनियमितता (चोटियों और घाटियों) को सुचारू करता है ताकि रुझानों को आसानी से पहचाना जा सके। अंतराल अवधि जितनी बड़ी होगी, मूविंग एवरेज की गणना करने के लिए, उतना ही अधिक उतार-चढ़ाव सुचारू होता है। जैसे-जैसे प्रत्येक गणना किए गए औसत में अधिक डेटा बिंदु शामिल होते हैं। यहां, हमारे पास एक निर्माण कंपनी द्वारा विभिन्न हफ्तों में बेची गई वस्तुओं की संख्या वाला एक डेटासेट है। आइए मूविंग एवरेज विश्लेषण करने के चरणों के माध्यम से चलते हैं।
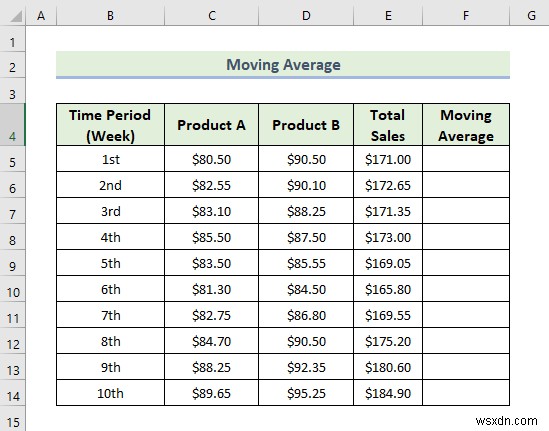
📌 चरण:
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
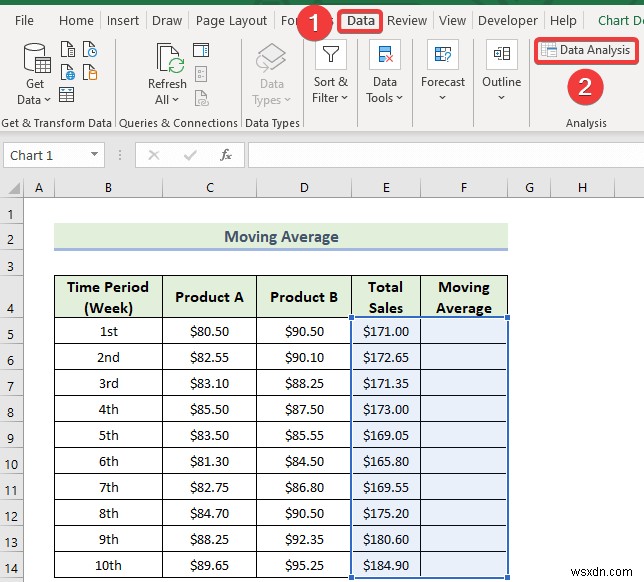
- जब डेटा विश्लेषण विंडो दिखाई दे, तो मूविंग एवरेज विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
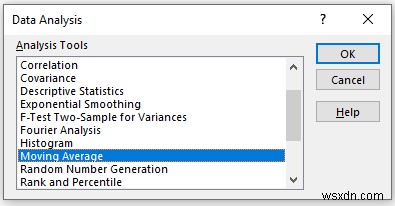
मूविंग एवरेज पॉप-अप बॉक्स में,
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर मूविंग एवरेज की गणना करना चाहते हैं।
- अंतराल में अंतराल की संख्या लिखें।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- यदि आप अपने डेटा की ट्रेंडलाइन को चार्ट के साथ देखना चाहते हैं तो चार्ट आउटपुट चेक करें अन्यथा छोड़ दें।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो पहली पंक्ति में लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
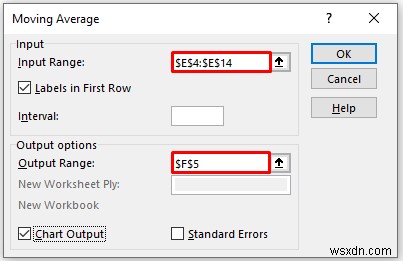
- परिणामस्वरूप, आपको एक्सेल ट्रेंडलाइन के साथ डेटा का मूविंग एवरेज मिलेगा जो मूल डेटा और सुचारू उतार-चढ़ाव के साथ मूविंग एवरेज मान दोनों दिखाता है।
समान पठन
- एक्सेल में मात्रात्मक डेटा का विश्लेषण कैसे करें (आसान चरणों के साथ)
- एक्सेल में बड़े डेटा सेट का विश्लेषण (6 प्रभावी तरीके)
- एक्सेल में लिकर्ट स्केल डेटा का विश्लेषण कैसे करें (त्वरित चरणों के साथ)
- एक्सेल में प्रश्नावली से गुणात्मक डेटा का विश्लेषण
8. यादृच्छिक संख्या उत्पन्न करना
अब, हम एक यादृच्छिक संख्या उत्पन्न करने जा रहे हैं। एक्सेल डेटा विश्लेषण टूलपैक हमें विभिन्न मानदंडों के साथ यादृच्छिक संख्या उत्पन्न करने की अनुमति देता है। आइए मूविंग एवरेज विश्लेषण करने के चरणों के माध्यम से चलते हैं।
📌 चरण:
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
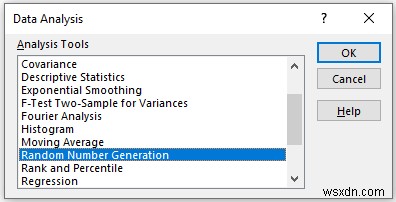
- फिर, डेटा विश्लेषण टूल चुनें।
- जब डेटा विश्लेषण विंडो दिखाई दे, तो वर्णनात्मक सांख्यिकी विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
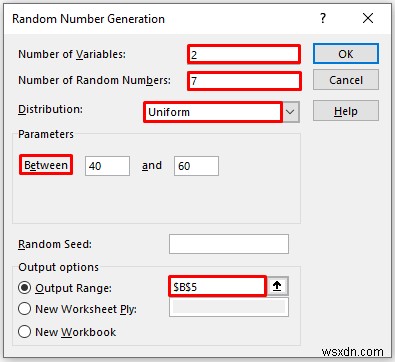
यादृच्छिक संख्या उत्पन्न करना पॉप-अप बॉक्स में,
- चरों की संख्या पर डेटा प्रदान करें जो आपके वर्कशीट में यादृच्छिक संख्याओं के कॉलम की संख्या को इंगित करता है। यहां, हम 2 दर्ज करते हैं क्योंकि हम 2 कॉलम चाहते हैं।
- अगला, आपको यादृच्छिक संख्याओं की संख्या में डेटा प्रदान करना होगा जो आपके वर्कशीट में आपके द्वारा चाही जाने वाली पंक्तियों की संख्या को संदर्भित करता है। यहां, 7 दर्ज करें जिसका अर्थ है हम अपने वर्कशीट में 7 पंक्तियाँ चाहते हैं।
- फिर, वितरण में समान चुनें। यहां, वितरण का अर्थ है कि आप किस प्रकार की यादृच्छिक संख्याओं का वितरण चाहते हैं।
- यहां, पैरामीटर आपके वितरण की सीमाओं को इंगित करते हैं। इस उदाहरण में, हम 40 से 60 तक।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- फिर, ओके पर क्लिक करें।
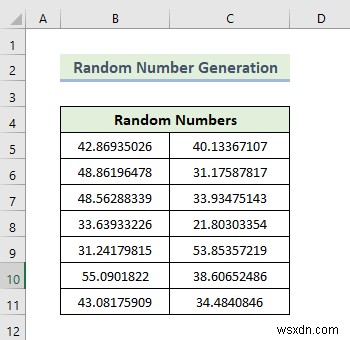
- परिणामस्वरूप, आप नीचे दिखाए अनुसार कुछ निर्दिष्ट मानदंडों के साथ यादृच्छिक संख्या उत्पन्न करने में सक्षम होंगे।
9. रैंक और पर्सेंटाइल विश्लेषण
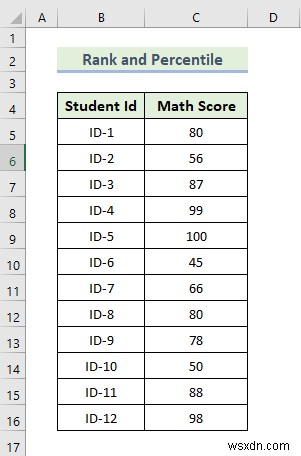
अब, हम रैंक और पर्सेंटाइल विश्लेषण करने जा रहे हैं। यहां, हमारे पास छात्रों की आईडी और उनके गणित परीक्षा स्कोर वाला एक डेटासेट है। हम प्रत्येक छात्र के गणित परीक्षा स्कोर की रैंक और पर्सेंटाइल की गणना करने जा रहे हैं। आइए रैंक और पर्सेंटाइल विश्लेषण करने के चरणों के माध्यम से चलते हैं।
📌 चरण:
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
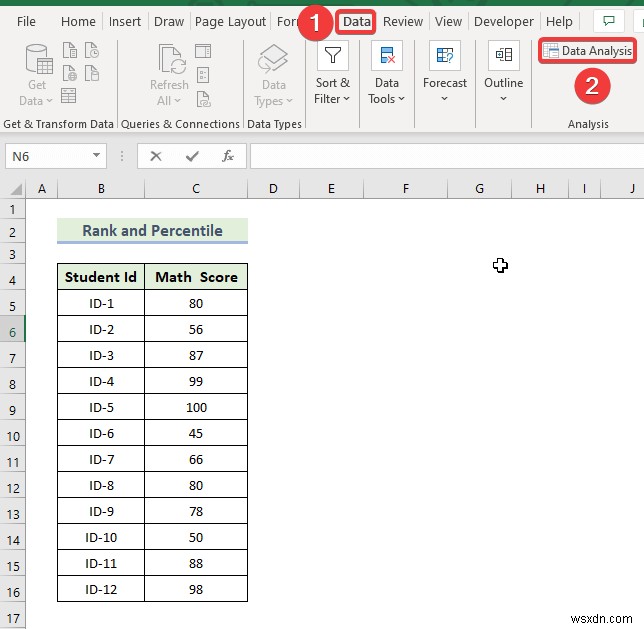
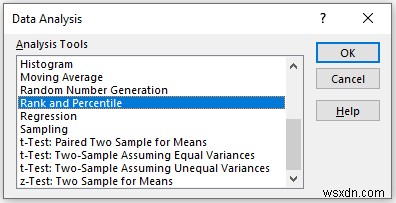
- जब डेटा विश्लेषण विंडो दिखाई दे, तो रैंक और पर्सेंटाइल विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
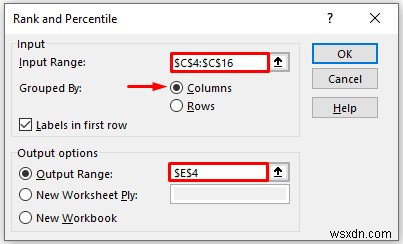
रैंक और पर्सेंटाइल पॉप-अप बॉक्स में,
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर मूविंग एवरेज की गणना करना चाहते हैं।
- अब, आपको समूहीकृत द्वारा अनुभाग में स्तंभ विकल्प को चेक करना होगा।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो पहली पंक्ति में लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
- परिणामस्वरूप, आपको नीचे दिखाए अनुसार प्रत्येक छात्र के परीक्षा स्कोर की रैंक और पर्सेंटाइल मिलेगी।
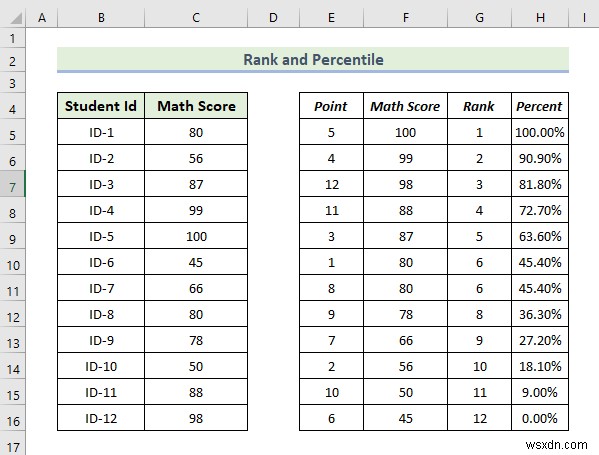
उपरोक्त परिणाम से, हम देख सकते हैं कि हम प्रत्येक छात्र के अंक की रैंक और पर्सेंटाइल की गणना करने में सक्षम हैं। यहां, रैंक 1 का अंक 100 है जो आईडी-5 का गणित स्कोर है, और अंतिम रैंक का अंक 45 है जो आईडी-6 का गणित स्कोर है।
10. प्रतिगमन विश्लेषण
अब, हम प्रतिगमन विश्लेषण करने जा रहे हैं। प्रतिगमन विश्लेषण सांख्यिकी का एक हिस्सा है जो दो या अधिक चरों के आधार पर मूल्यों की भविष्यवाणी करने में मदद करता है। यहां, हमारे पास खिलाड़ी का नाम, प्रत्येक खिलाड़ी द्वारा खेले गए मैचों की संख्या, और प्रत्येक खिलाड़ी द्वारा दिए गए गोलों की संख्या वाला एक डेटासेट है। आइए प्रतिगमन विश्लेषण करने के चरणों के माध्यम से चलते हैं।
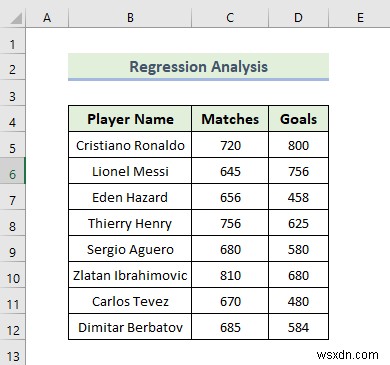
📌 चरण:
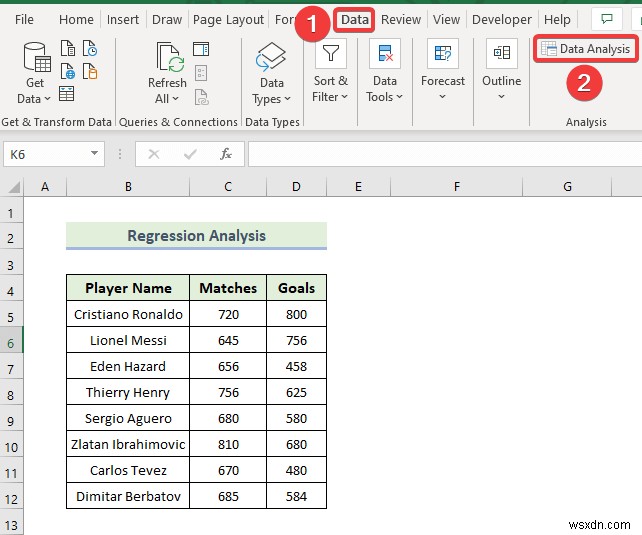
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
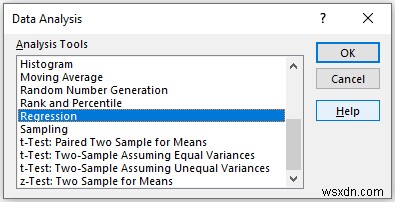
- जब डेटा विश्लेषण विंडो दिखाई दे, तो प्रतिगमन विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
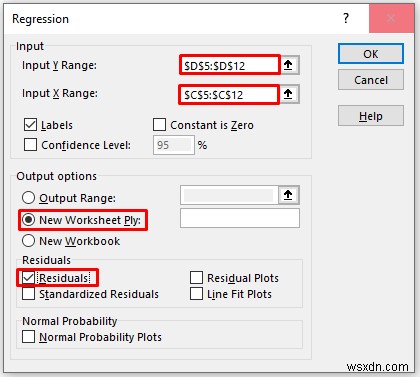
प्रतिगमन पॉप-अप बॉक्स में,
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, और इनपुट X रेंज और इनपुट Y रेंज बॉक्स में डेटा रेंज प्रदान करें।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो लेबल चेक करना होगा।
- आपको आउटपुट मान प्राप्त करने के लिए अवशेष विकल्प को भी चेक करना होगा।
- फिर, ओके पर क्लिक करें।
- परिणामस्वरूप, आपको प्रतिगमन विश्लेषण का निम्न परिणाम मिलेगा।
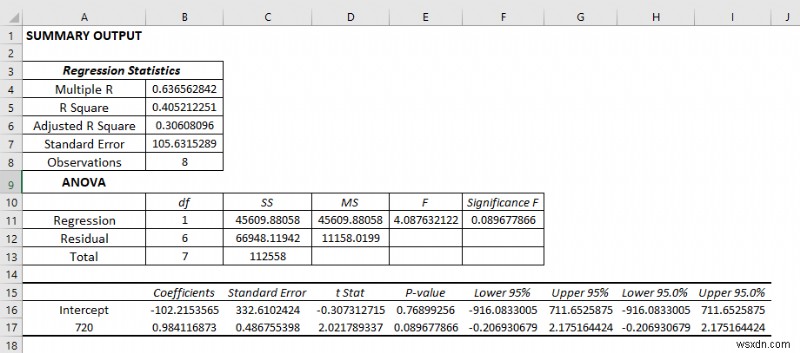
प्रतिगमन विश्लेषण परिणाम की व्याख्या:
प्रतिगमन सांख्यिकी:
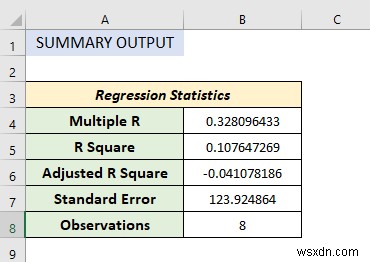
प्रतिगमन सांख्यिकी विभिन्न पैरामीटर्स की एक सरणी है जो बताती है कि मापा गया रैखिक प्रतिगमन कितना अच्छा है।
- एकाधिक R एक सहसंबंध गुणांक पैरामीटर है जो चरों के बीच सहसंबंध को इंगित करता है। इसका मान -1 से +1 तक होता है। मान जितना बड़ा होगा, सहसंबंध संबंध उतने ही मजबूत होंगे।
- R वर्ग दृढ़ संकल्प के गुणांक को दर्शाता है। यह उस पैमाने को इंगित करता है जिससे डेटा मॉडल प्रतिगमन विश्लेषण में फिट बैठता है।
- समायोजित R वर्ग का उपयोग प्रतिगमन विश्लेषण में कई चरों में किया जाता है।
- मानक त्रुटि एक और पैरामीटर है जो किसी भी प्रतिगमन विश्लेषण के स्वस्थ फिट को दिखाता है। मानक त्रुटि जितनी छोटी होगी, रैखिक प्रतिगमन समीकरण उतना ही सटीक होगा। यह रैखिक समीकरण से डेटा बिंदुओं की औसत दूरी दिखाता है।
एनोवा:
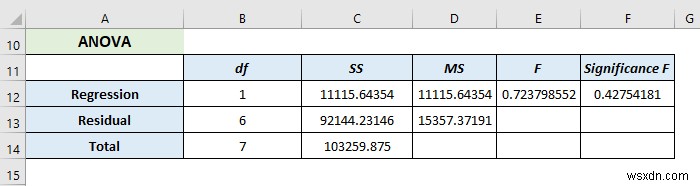
यह डेटा मॉडल के विचरण का विश्लेषण करता है।
- यहां, df स्वतंत्रता की डिग्री को दर्शाता है।
- SS (वर्गों का योग) फिटनेस पैरामीटर को दर्शाता है।
- MS का अर्थ है माध्य वर्ग।
- F शून्य परिकल्पना को संदर्भित करता है। यह प्रतिगमन मॉडल के समग्र महत्व का परीक्षण करता है
- F का महत्व F के P-मान का अर्थ है।
गुणांक परिणाम:
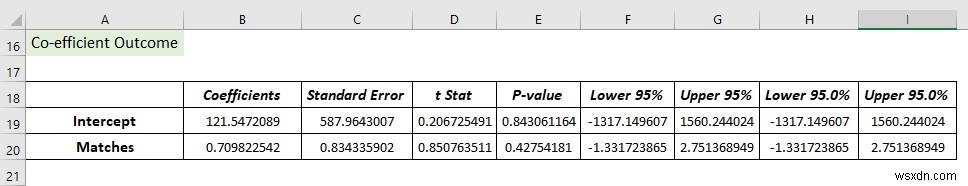
यह Y मानों को आसानी से निर्धारित करने में मदद करता है।
अवशिष्ट आउटपुट:
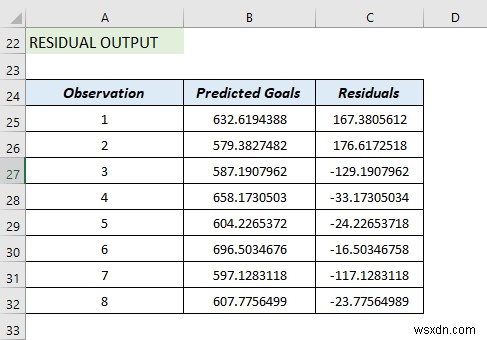
तो, यह अनुमानित मान की गणना किए गए मान के साथ तुलना करता है।
11. टी-परीक्षण विश्लेषण
अब, हम डेटासेट का टी-परीक्षण विश्लेषण करने जा रहे हैं। टी-परीक्षण तीन प्रकार का होता है:
- माध्य के लिए युग्मित दो नमूने
- समान विचरण मानकर दो नमूने
- असमान विचरण का उपयोग करके दो नमूने
यह खंड टी-परीक्षण विश्लेषण के तीन प्रकारों पर विस्तृत विवरण प्रदान करता है। आप अपने उद्देश्य के लिए उनमें से किसी एक का उपयोग कर सकते हैं, उनके पास अनुकूलन के मामले में लचीलेपन की एक विस्तृत श्रृंखला है।
11.1 टी-परीक्षण: माध्य के लिए युग्मित दो नमूना
अब, हम टी-परीक्षण: माध्य के लिए युग्मित दो नमूना करने जा रहे हैं। यहां, हमारे पास छात्रों की आईडी और प्रत्येक छात्र के गणित और भौतिकी स्कोर वाला एक डेटासेट है। आइए टी-परीक्षण: माध्य के लिए युग्मित दो नमूना विश्लेषण करने के चरणों के माध्यम से चलते हैं।
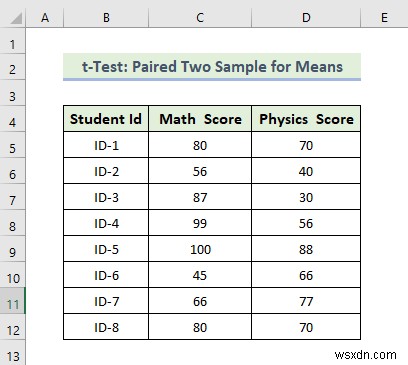
📌 चरण:
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
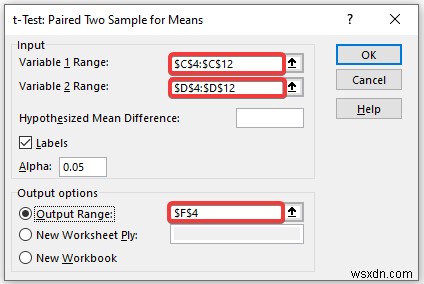
- जब डेटा विश्लेषण विंडो दिखाई दे, तो टी-परीक्षण: माध्य के लिए युग्मित दो नमूना विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
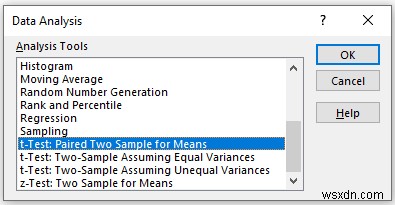
टी-परीक्षण: माध्य के लिए युग्मित दो नमूना पॉप-अप बॉक्स में,
- इनपुट बॉक्स में डेटा प्रदान करें, और चर 1 रेंज और चर 2 रेंज बॉक्स में डेटा रेंज प्रदान करें।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
- परिणामस्वरूप, आपको टी-परीक्षण: माध्य के लिए युग्मित दो नमूना का निम्न परिणाम मिलेगा।
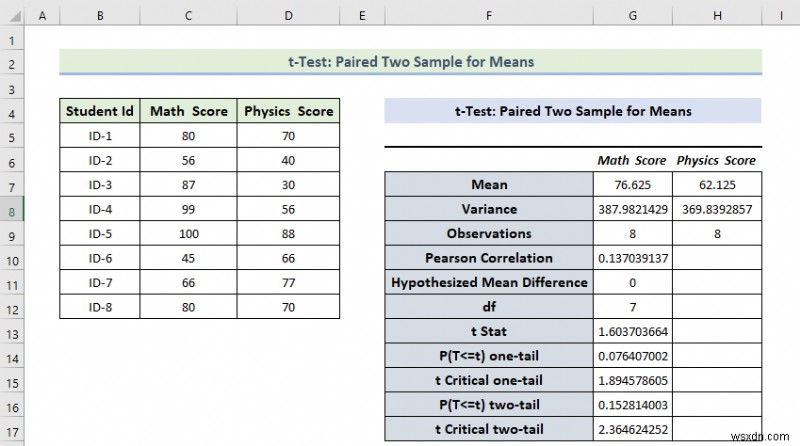
परिणाम की व्याख्या:
- यहां, हम देख सकते हैं कि गणित स्कोर का माध्य मान भौतिकी स्कोर के माध्य मान से अधिक है।
- गणित स्कोर का विचरण भौतिकी स्कोर के विचरण से भी अधिक है।
- यदि t Stat, t क्रिटिकल दो-पूंछ से अधिक है, तो इस स्थिति में हम शून्य परिकल्पना को समाप्त नहीं कर सकते। उपरोक्त गणना में, हम देख सकते हैं कि t Stat और t क्रिटिकल दो-पूंछ मान क्रमशः 1.603 और 2.36464 हैं। इसका मतलब 1.603 < 2.36464, यह शून्य परिकल्पना से मेल नहीं खाता। दूसरे शब्दों में, दो चरों के बीच विचरण मेल नहीं खाते।
11.2 टी-परीक्षण दो-नमूना समान विचरण मानकर
अब, हम टी-परीक्षण: दो-नमूना समान विचरण करने जा रहे हैं। यहां, हमारे पास छात्रों की आईडी और प्रत्येक छात्र के गणित और भौतिकी स्कोर वाला एक डेटासेट है। यहां, समान विचरण का अर्थ है कि हमने अपना डेटा नियमित वितरण आबादी से लिया है। आइए टी-परीक्षण: दो-नमूना समान विचरण विश्लेषण करने के चरणों के माध्यम से चलते हैं।
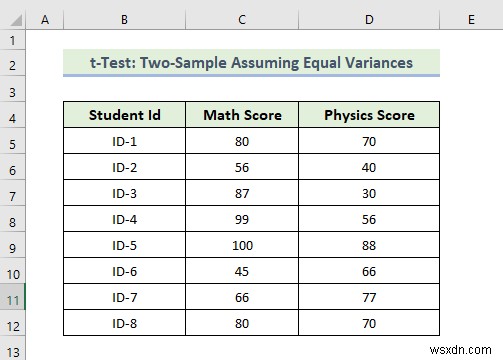
📌 चरण:
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
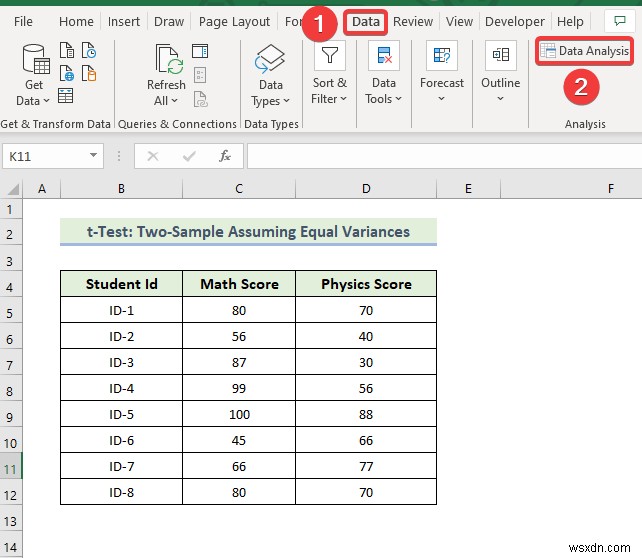
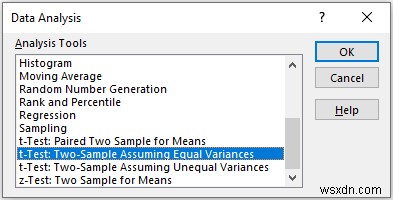
- जब डेटा विश्लेषण विंडो दिखाई दे, तो टी-परीक्षण: दो-नमूना समान विचरण विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
टी-परीक्षण: युग्मित दो नमूना समान विचरण पॉप-अप बॉक्स में,
- इनपुट बॉक्स में डेटा प्रदान करें, और चर 1 रेंज और चर 2 रेंज बॉक्स में डेटा रेंज प्रदान करें।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
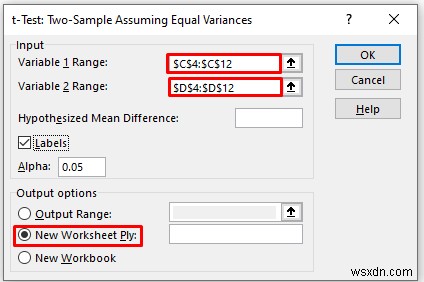
- परिणामस्वरूप, आपको टी-परीक्षण: दो-नमूना समान विचरण का निम्न परिणाम मिलेगा।
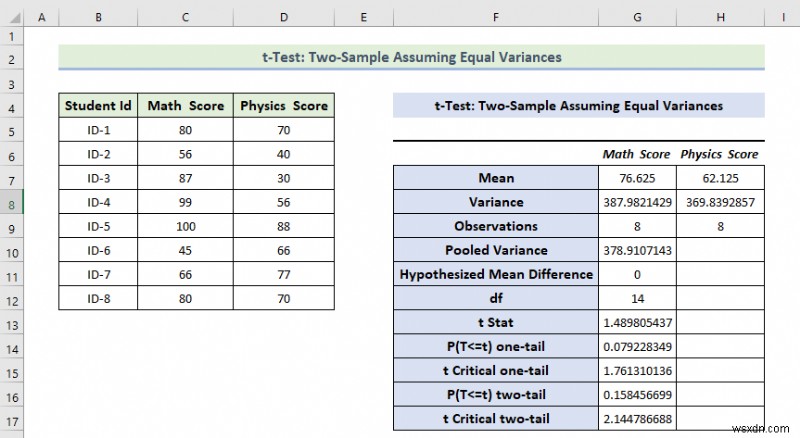
परिणाम की व्याख्या:
- यहां, हम देख सकते हैं कि गणित स्कोर का माध्य मान भौतिकी स्कोर के माध्य मान से अधिक है।
- गणित स्कोर का विचरण भौतिकी स्कोर के विचरण से भी अधिक है।
- यदि t Stat, t क्रिटिकल दो-पूंछ से अधिक है, तो इस स्थिति में हम शून्य परिकल्पना को समाप्त नहीं कर सकते। उपरोक्त गणना में, हम देख सकते हैं कि t Stat और t क्रिटिकल दो-पूंछ मान क्रमशः 1.48 और 2.144 हैं। इसका मतलब 1.48 < 2.144, यह शून्य परिकल्पना से मेल नहीं खाता। दूसरे शब्दों में, दो चरों के बीच विचरण मेल नहीं खाते।
11.3 टी-परीक्षण: दो-नमूना असमान विचरण मानकर
अब, हम टी-परीक्षण: दो-नमूना असमान विचरण करने जा रहे हैं। यहां, हमारे पास छात्रों की आईडी और प्रत्येक छात्र के गणित और भौतिकी स्कोर वाला एक डेटासेट है। यहां, असमान विचरण का अर्थ है कि हमने अपना डेटा अनियमित वितरण आबादी से लिया है। आइए टी-परीक्षण: दो-नमूना असमान विचरण विश्लेषण करने के चरणों के माध्यम से चलते हैं।
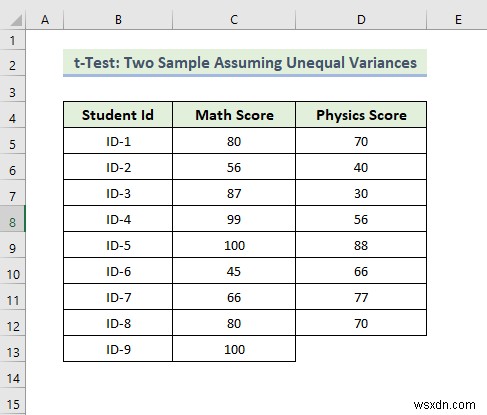
📌 चरण:
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
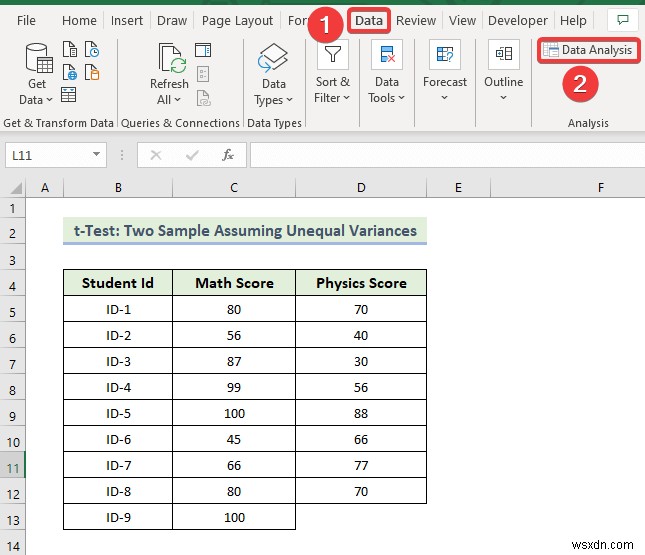
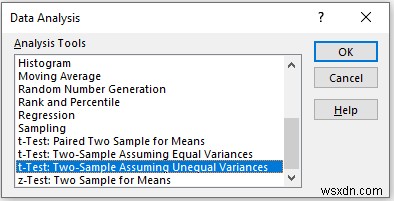
- जब डेटा विश्लेषण विंडो दिखाई दे, तो टी-परीक्षण: दो-नमूना असमान विचरण विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
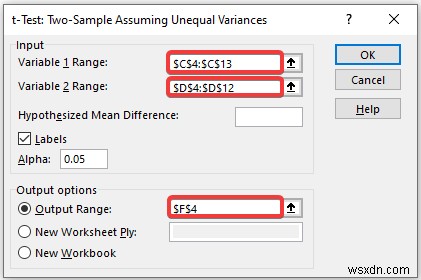
टी-परीक्षण: युग्मित दो नमूना असमान विचरण पॉप-अप बॉक्स में,
- इनपुट बॉक्स में डेटा प्रदान करें, और चर 1 रेंज और चर 2 रेंज बॉक्स में डेटा रेंज प्रदान करें।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
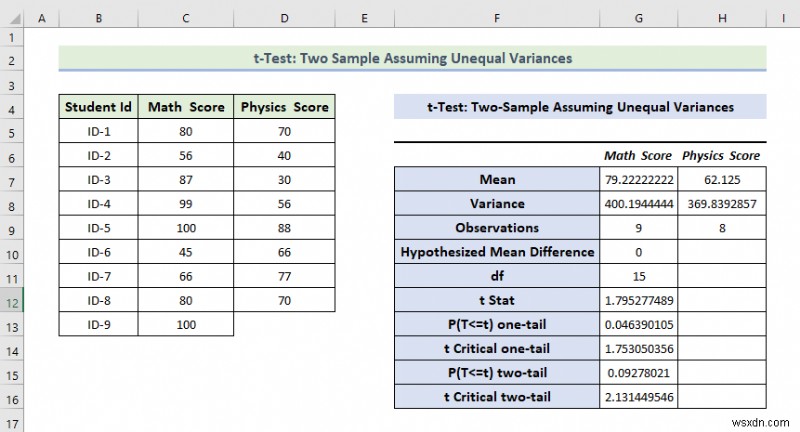
- परिणामस्वरूप, आपको टी-परीक्षण: दो-नमूना असमान विचरण का निम्न परिणाम मिलेगा।
परिणाम की व्याख्या:
- यहां, हम देख सकते हैं कि गणित स्कोर का माध्य मान भौतिकी स्कोर के माध्य मान से अधिक है।
- उपरोक्त परिणाम से, हम देख सकते हैं कि गणित स्कोर का विचरण भौतिकी स्कोर के विचरण से भी अधिक है।
- यदि t Stat, t क्रिटिकल दो-पूंछ से अधिक है, तो इस स्थिति में हम शून्य परिकल्पना को समाप्त नहीं कर सकते। उपरोक्त गणना में, हम देख सकते हैं कि t Stat और t क्रिटिकल दो-पूंछ मान क्रमशः 1.79 और 2.131 हैं। इसका मतलब 1.79 < 2.131, यह शून्य परिकल्पना से मेल नहीं खाता। दूसरे शब्दों में, दो चरों के बीच विचरण मेल नहीं खाते।
12. z-परीक्षण: दो नमूना माध्य के लिए
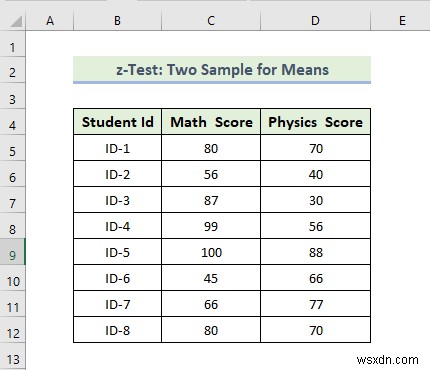
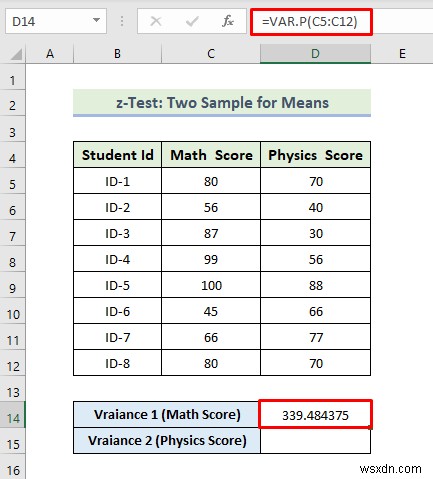
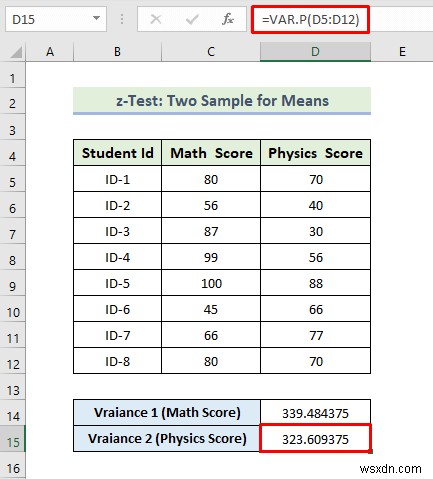
अब, हम z-परीक्षण: दो-नमूना माध्य करने जा रहे हैं। यहां, हमारे पास छात्रों की आईडी और प्रत्येक छात्र के गणित और भौतिकी स्कोर वाला एक डेटासेट है। यहां हम VAR.P फ़ंक्शन का उपयोग दोनों चरों के विचरण की गणना के लिए करेंगे। आइए z-परीक्षण: दो-नमूना माध्य विश्लेषण करने के चरणों के माध्यम से चलते हैं।
📌 चरण:
- सबसे पहले, गणित स्कोर के विचरण की गणना करने के लिए, हम सेल D14 में निम्न सूत्र का उपयोग करेंगे:
=VAR.P(C5:C12)
- फिर, एंटर दबाएं।
- परिणामस्वरूप, आपको गणित स्कोर का निम्न विचरण मिलेगा।
- अगला, भौतिकी स्कोर के विचरण की गणना करने के लिए, हम सेल D15 में निम्न सूत्र का उपयोग करेंगे:
=VAR.P(D5:D12)
- फिर, एंटर दबाएं।
- परिणामस्वरूप, आपको भौतिकी स्कोर का निम्न विचरण मिलेगा।
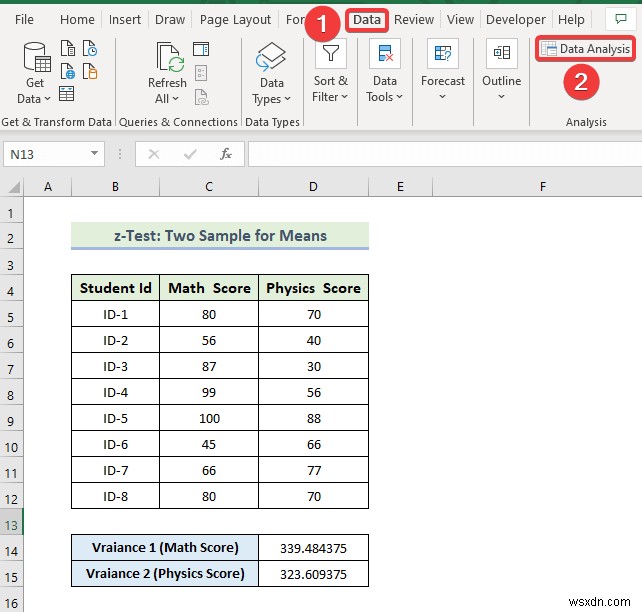
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
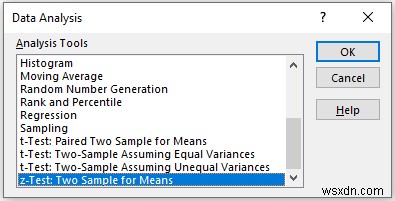
- जब डेटा विश्लेषण विंडो दिखाई दे, तो z-परीक्षण: दो-नमूना माध्य विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
z-परीक्षण: दो-नमूना माध्य पॉप-अप बॉक्स में,
- इनपुट बॉक्स में डेटा प्रदान करें, और चर 1 रेंज और चर 2 रेंज बॉक्स में डेटा रेंज प्रदान करें।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- आपको क्रमशः गणित और भौतिकी स्कोर के विचरण का मान चर 1 विचरण (ज्ञात) और चर 2 विचरण (ज्ञात) में दर्ज करना होगा
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
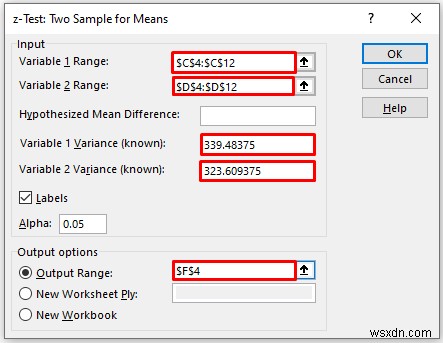
- परिणामस्वरूप, आपको z-परीक्षण: दो-नमूना माध्य विकल्प का निम्न परिणाम मिलेगा।
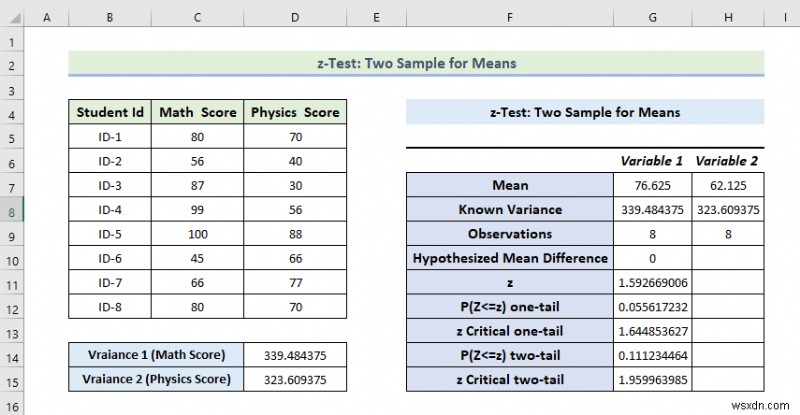
परिणाम की व्याख्या:
- यहां, हम देख सकते हैं कि गणित स्कोर का माध्य मान भौतिकी स्कोर के माध्य मान से अधिक है।
- उपरोक्त परिणाम से, हम देख सकते हैं कि गणित स्कोर का विचरण भौतिकी स्कोर के विचरण से भी अधिक है।
- यदि Z, Z क्रिटिकल दो-पूंछ से कम है, तो इस स्थिति में हम शून्य परिकल्पना को समाप्त नहीं कर सकते। उपरोक्त गणना में, हम देख सकते हैं कि z और z क्रिटिकल दो-पूंछ मान क्रमशः 1.52 और 1.95 हैं। इसका मतलब 1.52 < 1.95, जो शून्य परिकल्पना से मेल खाता है। दूसरे शब्दों में, दो चरों के बीच विचरण मेल खाते हैं।
और पढ़ें: एक्सेल डेटा विश्लेषण का उपयोग करके केस स्टडी कैसे करें
13. नमूनाकरण विश्लेषण
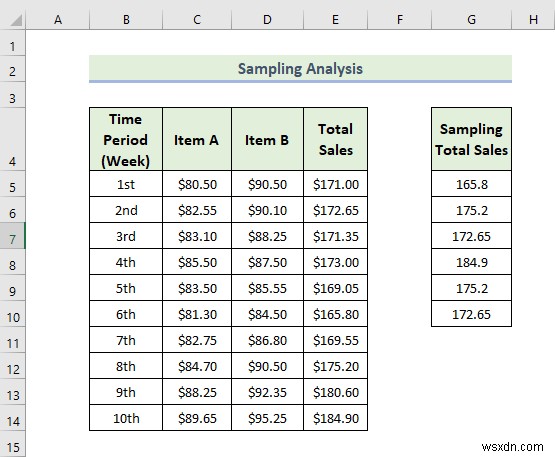
अब, हम नमूनाकरण विश्लेषण करने जा रहे हैं जो एक्सेल डेटा विश्लेषण टूलपैक की सर्वोत्तम विशेषताओं में से एक है। यहां, हमारे पास अलग-अलग समय अवधि के लिए दो वस्तुओं की व्यक्तिगत बिक्री और कुल बिक्री मूल्य वाला एक डेटासेट है। आइए नमूनाकरण विश्लेषण करने के चरणों के माध्यम से चलते हैं।
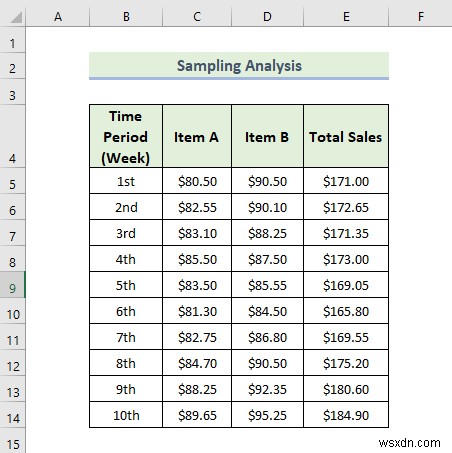
📌 चरण:
- सबसे पहले, शीर्ष रिबन में डेटा टैब पर जाएं।
- फिर, डेटा विश्लेषण टूल चुनें।
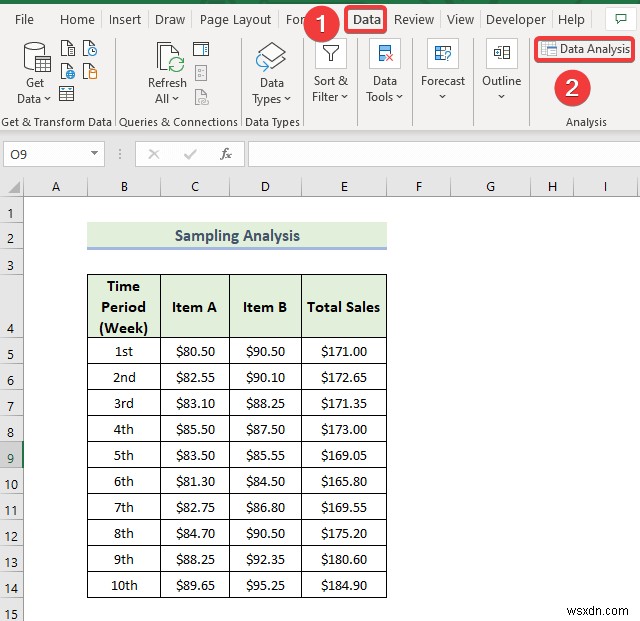
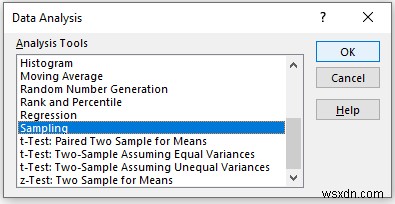
- जब डेटा विश्लेषण विंडो दिखाई दे, तो नमूनाकरण विकल्प चुनें।
- फिर, ओके पर क्लिक करें।
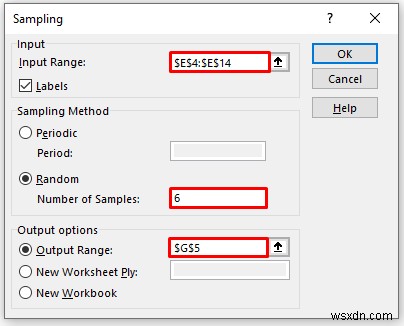
नमूनाकरण पॉप-अप बॉक्स में,
- इनपुट रेंज बॉक्स में डेटा प्रदान करें, जिसे आप कॉलम या पंक्ति के माध्यम से खींचकर मूविंग एवरेज की गणना करना चाहते हैं।
- आउटपुट रेंज बॉक्स में, कॉलम या पंक्ति के माध्यम से खींचकर उस डेटा रेंज को प्रदान करें जहां आप अपने गणना किए गए डेटा को स्टोर करना चाहते हैं। या आप नई वर्कशीट प्लाई चुनकर आउटपुट को नई वर्कशीट में दिखा सकते हैं और आप नई वर्कबुक चुनकर आउटपुट को नई वर्कबुक में भी देख सकते हैं।
- आपको नमूनों की संख्या विकल्प में डेटा दर्ज करना होगा।
- अगला, यदि इनपुट डेटा रेंज लेबल के साथ है तो लेबल चेक करना होगा।
- फिर, ओके पर क्लिक करें।
- परिणामस्वरूप, आपको नमूनाकरण विश्लेषण का निम्न परिणाम मिलेगा। निम्न चित्र में, हम कुल बिक्री कॉलम से छह नमूने चुनने में सक्षम हैं। यदि आप इस कॉलम से अधिक नमूना डेटा चुनना चाहते हैं, तो जब नमूनाकरण विंडो दिखाई दे तो नमूनों की संख्या बॉक्स में अधिक संख्या दर्ज करनी होगी।
और पढ़ें: एक्सेल में बिक्री डेटा का विश्लेषण कैसे करें (10 आसान तरीके)
निष्कर्ष
आज के सत्र का अंत यहीं होता है। यहां, हमने डेटा विश्लेषण टूलपैक का उपयोग करने के तेरह उपयुक्त उदाहरणों का प्रदर्शन किया। मुझे दृढ़ता से विश्वास है कि अब से, आप एक्सेल में डेटा विश्लेषण टूलपैक का उपयोग करने में सक्षम हो सकते हैं। यदि आपके कोई प्रश्न या सिफारिशें हैं, तो कृपया उन्हें नीचे टिप्पणी अनुभाग में साझा करें।
विभिन्न एक्सेल-संबंधी समस्याओं और समाधानों के लिए हमारी वेबसाइट एक्सेलडेमो.कॉम देखना न भूलें। नई विधियाँ सीखते रहें और बढ़ते रहें!
संबंधित लेख
- पिवट टेबल का उपयोग करके एक्सेल में डेटा का विश्लेषण (9 उपयुक्त उदाहरण)
- एक्सेल में टाइम-स्केल्ड डेटा का विश्लेषण (आसान चरणों के साथ)
- एक्सेल में गुणात्मक डेटा का विश्लेषण कैसे करें (आसान चरणों के साथ)
- एक्सेल में qPCR डेटा का विश्लेषण (2 आसान तरीके)
- एक्सेल में टेक्स्ट डेटा का विश्लेषण कैसे करें (5 उपयुक्त तरीके)