TensorFlow, Google द्वारा प्रदान किया गया एक मशीन लर्निंग फ्रेमवर्क है। यह एक ओपन-सोर्स फ्रेमवर्क है जिसे Python के साथ मिलकर एल्गोरिदम, डीप लर्निंग एप्लिकेशन और बहुत कुछ लागू करने के लिए उपयोग किया जाता है। इसका उपयोग अनुसंधान और उत्पादन उद्देश्यों के लिए किया जाता है।
इंस्टॉलेशन
Windows पर 'tensorflow' पैकेज इंस्टॉल करने के लिए:
pip install tensorflow
टेंसर क्या है?
टेंसर, TensorFlow में उपयोग की जाने वाली एक डेटा संरचना है। यह फ्लो डायग्राम में एज को जोड़ने में मदद करता है। इस फ्लो डायग्राम को 'डेटा फ्लो ग्राफ' के नाम से जाना जाता है। टेंसर बहुआयामी सरणी या सूची के अलावा कुछ नहीं हैं।
रिग्रेशन समस्या और डेटासेट
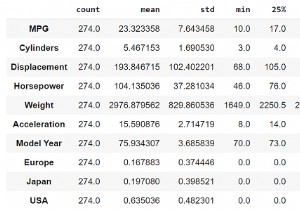
रिग्रेशन समस्या के पीछे का उद्देश्य एक सतत या असतत चर के आउटपुट की भविष्यवाणी करना है, जैसे कि कीमत, संभावना, बारिश होगी या नहीं, आदि। हम जिस डेटासेट का उपयोग करते हैं उसे 'Auto MPG' डेटासेट कहा जाता है। इसमें 1970 और 1980 के दशक के ऑटोमोबाइल की ईंधन दक्षता शामिल है। इसमें वजन, हॉर्सपावर, डिस्प्लेसमेंट आदि जैसे गुण शामिल हैं। इसके साथ, हमें विशिष्ट वाहनों की ईंधन दक्षता की भविष्यवाणी करने की आवश्यकता है।
Google Colaboratory का उपयोग
हम नीचे दिए गए कोड को चलाने के लिए Google Colaboratory का उपयोग कर रहे हैं। Google Colab या Colaboratory ब्राउज़र पर Python कोड चलाने में मदद करता है और इसके लिए शून्य कॉन्फ़िगरेशन की आवश्यकता होती है और GPUs (ग्राफिकल प्रोसेसिंग यूनिट्स) तक मुफ्त पहुंच प्रदान करता है। Colaboratory को Jupyter Notebook के शीर्ष पर बनाया गया है।
उदाहरण
print("प्रशिक्षण डेटा को मॉडल में फिट किया जा रहा है")
history = hrspwr_model.fit(
    train_features['Horsepower'], train_labels,
    epochs=150, verbose=0, validation_split=0.3)
hist = pd.DataFrame(history.history)
hist['epoch'] = history.epoch
hist.tail()
कोड क्रेडिट - TensorFlow ट्यूटोरियल
आउटपुट
व्याख्या
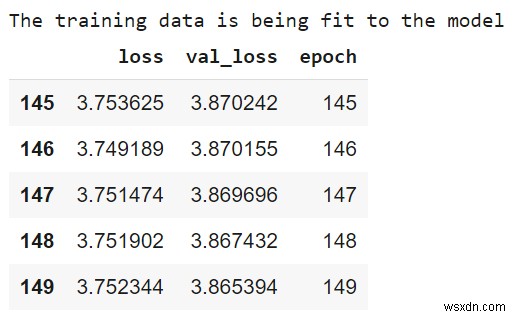
- 'fit' फ़ंक्शन का उपयोग करके डेटा को मॉडल में फिट किया जाता है।
- 'epochs' विशेषता का उपयोग करके चरणों की संख्या निर्धारित की जाती है।
- 'history' ऑब्जेक्ट इनपुट डेटा से जुड़े आंकड़ों की प्रगति को संग्रहीत करता है।
- इसे डेटाफ्रेम में परिवर्तित किया जाता है।
- डेटा का एक नमूना कंसोल पर प्रदर्शित किया जाता है।
- डेटा को विज़ुअलाइज़ भी किया जाता है।