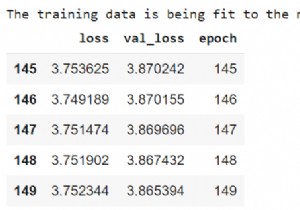
फ्लावर डेटासेट को क्रमशः compile और fit मेथड्स का उपयोग करके कंपाइल और मॉडल पर फिट किया जा सकता है। fit मेथड को ट्रेनिंग डेटासेट के साथ-साथ वैलिडेशन डेटासेट को पैरामीटर्स के रूप में पास किया जाता है। Epoch की संख्या भी fit मेथड में परिभाषित की जाती है।
और पढ़ें: TensorFlow क्या है और Keras, TensorFlow के साथ मिलकर न्यूरल नेटवर्क कैसे बनाता है?
हम फ्लावर्स डेटासेट का उपयोग करेंगे, जिसमें कई हजारों फूलों की छवियां होती हैं। इसमें 5 सब-डायरेक्टरीज हैं, और प्रत्येक क्लास के लिए एक सब-डायरेक्टरी है।
हम नीचे दिए गए कोड को चलाने के लिए Google Colaboratory का उपयोग कर रहे हैं। Google Colab या Colaboratory ब्राउज़र पर Python कोड चलाने में मदद करता है और इसके लिए शून्य कॉन्फ़िगरेशन और GPUs (ग्राफ़िकल प्रोसेसिंग यूनिट्स) तक मुफ्त पहुंच की आवश्यकता होती है। Colaboratory को Jupyter Notebook के ऊपर बनाया गया है।
print("मॉडल को कंपाइल किया जा रहा है")
model.compile(
    optimizer='adam',
    loss=tf.losses.SparseCategoricalCrossentropy(from_logits=True),
    metrics=['accuracy'])
print("मॉडल को डेटा पर फिट किया जा रहा है")
model.fit(
    train_ds,
    validation_data=val_ds,
    epochs=3
)
कोड क्रेडिट: https://www.tensorflow.org/tutorials/load_data/images
आउटपुट
मॉडल को कंपाइल किया जा रहा है
मॉडल को डेटा पर फिट किया जा रहा है
Epoch 1/3 92/92 [==============================] - 107s 1s/step - loss: 1.3570 - accuracy: 0.4183 - val_loss: 1.0730 - val_accuracy: 0.5913
Epoch 2/3 92/92 [==============================] - 101s 1s/step - loss: 1.0185 - accuracy: 0.5927 - val_loss: 1.0041 - val_accuracy: 0.6199
Epoch 3/3 92/92 [==============================] - 95s 1s/step - loss: 0.8691 - accuracy: 0.6529 - val_loss: 0.9985 - val_accuracy: 0.6281
<tensorflow.python.keras.callbacks.History at 0x7f2cdcbbba90>
व्याख्या
- एक बार लेयर्स बन जाने और डेटा ट्रेन हो जाने के बाद, अगला कदम बनाए गए मॉडल को कंपाइल करना है।
- एक बार कंपाइलिंग हो जाने के बाद, मॉडल को इनपुट डेटासेट पर फिट किया जाता है।
- वैलिडेशन सटीकता ट्रेनिंग सटीकता मान की तुलना में कम मान है।
- इसका मतलब है कि हमारा मॉडल ओवरफिट हो रहा है।