फूल डेटासेट को केरस प्रीप्रोसेसिंग API का उपयोग करके प्रशिक्षण और सत्यापन सेट में विभाजित किया जा सकता है, 'image_dataset_from_directory' की मदद से जो वैलिडेशन सेट के लिए प्रतिशत विभाजन पूछता है।
और पढ़ें: TensorFlow क्या है और केरस TensorFlow के साथ न्यूरल नेटवर्क बनाने के लिए कैसे काम करता है?
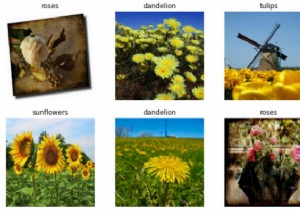
एक छवि वर्गीकरणकर्ता keras.Sequential मॉडल का उपयोग करके बनाया जाता है, और डेटा preprocessing.image_dataset_from_directory का उपयोग करके लोड किया जाता है। डेटा डिस्क से कुशलतापूर्वक लोड होता है। ओवरफिटिंग की पहचान की जाती है और इसे कम करने के लिए तकनीकें लागू की जाती हैं। इन तकनीकों में डेटा ऑग्मेंटेशन और ड्रॉपआउट शामिल हैं। 3700 फूलों की छवियां हैं। इस डेटासेट में 5 सब डायरेक्टरी हैं, और प्रति क्लास एक सब डायरेक्टरी है। वे हैं: डेज़ी, डैंडेलियन, गुलाब, सूरजमुखी, और ट्यूलिप।
हम नीचे दिए गए कोड को चलाने के लिए Google Colaboratory का उपयोग कर रहे हैं। Google Colab या Colaboratory ब्राउज़र पर पायथन कोड चलाने में मदद करता है और इसके लिए शून्य कॉन्फ़िगरेशन और GPU (ग्राफिकल प्रोसेसिंग यूनिट्स) तक मुफ्त पहुंच की आवश्यकता होती है। Colaboratory को Jupyter Notebook के शीर्ष पर बनाया गया है।
batch_size = 32
img_height = 180
img_width = 180
print("The data is being split into training and validation set")
train_ds = tf.keras.preprocessing.image_dataset_from_directory(
    data_dir,
    validation_split=0.2,
    subset="training",
    seed=123,
    image_size=(img_height, img_width),
    batch_size=batch_size)
कोड क्रेडिट: https://www.tensorflow.org/tutorials/images/classification
आउटपुट
The data is being split into training and validation set
Found 3670 files belonging to 5 classes.
Using 2936 files for training.
व्याख्या
- ये छवियां image_dataset_from_directory यूटिलिटी का उपयोग करके डिस्क से लोड की जाती हैं।
- यह डिस्क पर छवियों की डायरेक्टरी से tf.data.Dataset तक जाएगा।
- एक बार डेटा डाउनलोड हो जाने पर, लोडर के लिए कुछ पैरामीटर परिभाषित किए जाते हैं।
- डेटा को प्रशिक्षण और सत्यापन सेट में विभाजित किया जाता है।