TensorFlow, Google द्वारा प्रदान किया गया एक मशीन लर्निंग फ्रेमवर्क है। यह एक ओपन-सोर्स फ्रेमवर्क है जिसे Python के साथ मिलकर एल्गोरिदम, डीप लर्निंग एप्लिकेशन और बहुत कुछ लागू करने के लिए उपयोग किया जाता है।
इंस्टॉलेशन
Windows पर 'tensorflow' पैकेज इंस्टॉल करने के लिए:
pip install tensorflow
टेंसर क्या है?
टेंसर, TensorFlow में उपयोग की जाने वाली एक डेटा संरचना है। यह फ्लो डायग्राम में एज को जोड़ने में मदद करता है। इस फ्लो डायग्राम को 'डेटा फ्लो ग्राफ' के नाम से जाना जाता है। टेंसर बहुआयामी सरणी या सूची के अलावा कुछ नहीं हैं।
रिग्रेशन समस्या और डेटासेट
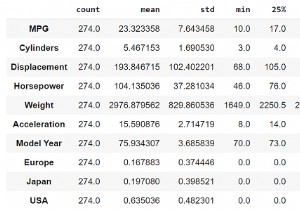
रिग्रेशन समस्या के पीछे का उद्देश्य एक सतत या असतत चर के आउटपुट की भविष्यवाणी करना है, जैसे कि कीमत, संभावना, बारिश होगी या नहीं, आदि। हम जिस डेटासेट का उपयोग करते हैं उसे 'Auto MPG' डेटासेट कहा जाता है। इसमें 1970 और 1980 के दशक के ऑटोमोबाइल की ईंधन दक्षता शामिल है। इसमें वजन, हॉर्सपावर, डिस्प्लेसमेंट आदि जैसे गुण शामिल हैं। इसके साथ, हमें विशिष्ट वाहनों की ईंधन दक्षता की भविष्यवाणी करने की आवश्यकता है।
Google Colaboratory का उपयोग
हम नीचे दिए गए कोड को चलाने के लिए Google Colaboratory का उपयोग कर रहे हैं। Google Colab या Colaboratory ब्राउज़र पर Python कोड चलाने में मदद करता है और इसके लिए शून्य कॉन्फ़िगरेशन की आवश्यकता होती है और GPUs (ग्राफिकल प्रोसेसिंग यूनिट्स) तक मुफ्त पहुंच प्रदान करता है। Colaboratory को Jupyter Notebook के शीर्ष पर बनाया गया है।
निम्न कोड स्निपेट में हम देखेंगे कि TensorFlow का उपयोग करके Auto MPG डेटासेट का उपयोग करके ईंधन दक्षता की भविष्यवाणी के लिए डेटा को कैसे साफ किया जा सकता है:
उदाहरण
print("डेटा सफाई शुरू हुई")
dataset.isna().sum()
dataset = dataset.dropna()
dataset['Origin'] = dataset['Origin'].map({1: 'USA', 2: 'Europe', 3: 'Japan'})
print("डेटा सफाई पूर्ण!")
dataset = pd.get_dummies(dataset, prefix='', prefix_sep='')
print("डेटा सफाई के बाद डेटासेट का एक नमूना:")
dataset.head(4)
कोड क्रेडिट - TensorFlow ट्यूटोरियल
आउटपुट
डेटा सफाई शुरू हुई
डेटा सफाई पूर्ण!
डेटा सफाई के बाद डेटासेट का एक नमूना -
| MPG | Cylinders | Displacement | horsepower | weight | Acceleration | Model Year | Europe | Japan | USA | |
|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 18.0 | 8 | 307.0 | 130.0 | 3504.0 | 12.0 | 70 | 0 | 0 | 1 |
| 1 | 15.0 | 8 | 350.0 | 165.0 | 3693.0 | 11.5 | 70 | 0 | 0 | 1 |
| 2 | 18.0 | 8 | 318.0 | 150.0 | 3436.0 | 11.0 | 70 | 0 | 0 | 1 |
| 3 | 16.0 | 8 | 304.0 | 150.0 | 3433.0 | 12.0 | 70 | 0 | 0 | 1 |
व्याख्या
- डेटा सफाई डेटासेट में मौजूद 'nan' को हटाकर शुरू होती है।
- 'map' फ़ंक्शन का उपयोग लेबल को कॉलम नामों पर मैप करने के लिए किया जाता है।
- डेटा सफाई के बाद डेटासेट का एक नमूना कंसोल पर प्रदर्शित किया जाता है।