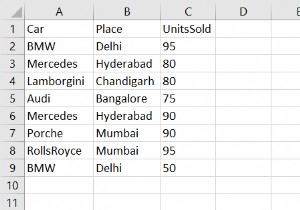
Pandas में कॉलम को groupby करके प्रत्येक संयोजन की घटनाओं की गिनती करने के लिए, हम DataFrame.groupby() के साथ size() का उपयोग करते हैं। groupby() विधि DataFrame को समूहों में अलग करती है।
सबसे पहले, pandas लाइब्रेरी को pd उपनाम के साथ आयात करें:
import pandas as pd
सूचियों का डेटा आरंभ करें:
# डेटा आरंभ करना
mylist = {'Car': ['BMW', 'Mercedes', 'Lamborgini', 'Audi', 'Mercedes', 'Porche', 'RollsRoyce', 'BMW'],
          'Place': ['Delhi', 'Hyderabad', 'Chandigarh', 'Bangalore', 'Hyderabad', 'Mumbai', 'Mumbai', 'Delhi'],
          'Sold': [95, 80, 80, 75, 90, 90, 95, 50]}
अब, हम एक DataFrame बनाएंगे:
# DataFrame
dataFrame = pd.DataFrame(mylist, columns=['Car', 'Place', 'Sold'])
अब, घटनाओं की गिनती के लिए size() के साथ groupby() का उपयोग करें:
print("Counting the occurrences...")
res = dataFrame.groupby(['Car', 'Place']).size()
प्रत्येक संयोजन की घटनाओं की गिनती करने का कोड निम्नलिखित है:
उदाहरण
# लाइब्रेरी आयात करना
import pandas as pd
# डेटा आरंभ करना
mylist = {'Car': ['BMW', 'Mercedes', 'Lamborgini', 'Audi', 'Mercedes', 'Porsche', 'RollsRoyce', 'BMW'],
          'Place': ['Delhi', 'Hyderabad', 'Chandigarh', 'Bangalore', 'Hyderabad', 'Mumbai', 'Mumbai', 'Delhi'],
          'Sold': [95, 80, 80, 75, 90, 90, 95, 50]}
# DataFrame
dataFrame = pd.DataFrame(mylist, columns=['Car', 'Place', 'Sold'])
print(dataFrame)
print("Counting the occurrences...")
res = dataFrame.groupby(['Car', 'Place']).size()
# घटनाओं को प्रदर्शित करना
print(res)
आउटपुट
यह निम्नलिखित आउटपुट देगा:
   Car        Place         Sold
0  BMW        Delhi         95
1  Mercedes   Hyderabad     80
2  Lamborgini Chandigarh    80
3  Audi       Bangalore     75
4  Mercedes   Hyderabad     90
5  Porsche    Mumbai        90
6  RollsRoyce Mumbai        95
7  BMW        Delhi         50
Counting the occurrences...
Car        Place
Audi       Bangalore     1
BMW        Delhi         2
Lamborgini Chandigarh    1
Mercedes   Hyderabad     2
Porsche    Mumbai        1
RollsRoyce Mumbai        1
dtype: int64