मूल रूप से ट्राइकोर द्वारा प्रकाशित: 10 जुलाई, 2017
अपाचे™ हडूप® एक ओपन-सोर्स, जावा-आधारित फ्रेमवर्क है जिसे वितरित कंप्यूटिंग वातावरण में बड़ी मात्रा में डेटा प्रोसेस करने के लिए डिज़ाइन किया गया है। डग कटिंग और माइक कैफरेला ने हडूप विकसित किया, जिसे 2005 में जारी किया गया था।
कमोडिटी हार्डवेयर पर निर्मित, हडूप इस मूल धारणा पर काम करता है कि हार्डवेयर विफलताएं आम हैं। हडूप फ्रेमवर्क इन विफलताओं को संबोधित करता है।
इस दो-भाग वाली ब्लॉग श्रृंखला के भाग 1 में, हम बिग डेटा, हडूप इकोसिस्टम और हडूप फ्रेमवर्क के कुछ प्रमुख घटकों को कवर करेंगे।
डेटा पहले से कहीं बड़ा है
डेटा सभी संगठनों के लिए महत्वपूर्ण है, और बिग डेटा उन विश्लेषणों के लिए नए अवसर खोल रहा है जो मूल्यवान व्यावसायिक अंतर्दृष्टि प्रदान कर सकते हैं। बिग डेटा उस डेटा को संदर्भित करता है जो किसी संगठन की भंडारण क्षमता और प्रोसेसिंग पावर से परे होता है।
बिग डेटा सोशल नेटवर्क, क्लोज्ड कैप्शन टेलीविजन (CCTV) कैमरे, सेंसर, ऑनलाइन शॉपिंग पोर्टल, हॉस्पिटैलिटी डेटा, ग्लोबल पोजिशनिंग सिस्टम (GPS), ऑटोमोबाइल उद्योग और अन्य स्रोतों से उत्पन्न हो सकता है जो भारी मात्रा में जानकारी उत्पन्न करते हैं।
बिग डेटा के तीन मुख्य पहलू हैं, जो सभी तीव्र गति से प्रगति कर रहे हैं:
-
वॉल्यूम (मात्रा): बिग डेटा का वॉल्यूम गीगाबाइट्स से टेराबाइट्स और पेटाबाइट्स तक तेजी से बढ़ रहा है। इसे स्टोर करने के लिए भारी मात्रा में डिस्क स्पेस की आवश्यकता होती है।
-
वेलोसिटी (गति): बिग डेटा आमतौर पर डेटा सेंटर में स्टोर किया जाता है। स्थानीय वर्कस्टेशन तक डेटा पहुंचाने के लिए हाई-स्पीड डेटा प्रोसेसर की आवश्यकता होती है।
-
वेरायटी (विविधता): डेटा को मोटे तौर पर संरचित, असंरचित या अर्ध-संरचित के रूप में वर्गीकृत किया जा सकता है।
हम बिग डेटा को निम्न समीकरण से संक्षेप में प्रस्तुत कर सकते हैं:
बिग डेटा = डेटा का (वॉल्यूम + वेलोसिटी + वेरायटी)
निम्न छवि इन अवधारणाओं का विज़ुअलाइज़ेशन प्रदान करती है।
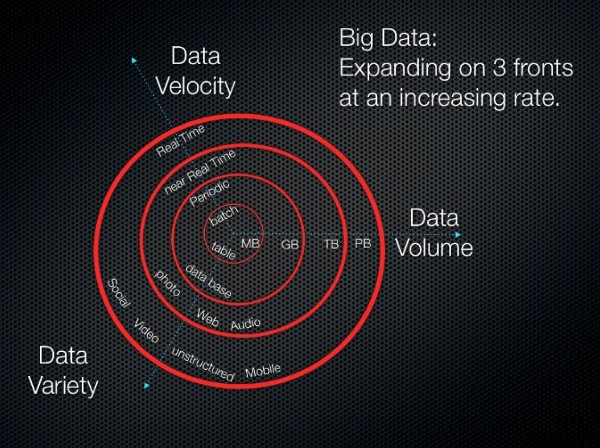
छवि स्रोत: 3Vs (वॉल्यूम, वेरायटी और वेलोसिटी)
हडूप इकोसिस्टम
हडूप इकोसिस्टम शब्द अपाचे हडूप सॉफ्टवेयर लाइब्रेरी के विभिन्न घटकों को संदर्भित करता है। यह इकोसिस्टम विभिन्न मॉड्यूल के एक सेट से बना है जो एक-दूसरे के साथ इंटरैक्ट करते हैं। ये मॉड्यूल टूल्स और एक्सेसरीज़ का एक सेट प्रदान करते हैं जो बिग डेटा प्रोसेसिंग में शामिल विशिष्ट आवश्यकताओं को पूरा करने के लिए डिज़ाइन किए गए हैं। इकोसिस्टम में हडूप के सभी मॉड्यूल शामिल हैं, जिनमें हडूप फ्रेमवर्क के मुख्य घटक शामिल हैं जिनकी हम नीचे चर्चा करते हैं, साथ ही ऐड-ऑन मॉड्यूल भी।
हडूप फ्रेमवर्क के घटक
हडूप फ्रेमवर्क में निम्नलिखित मुख्य घटक शामिल हैं।
वितरित भंडारण
हडूप में वितरित भंडारण को सक्षम करने के लिए कई अलग-अलग टुकड़े एक साथ आते हैं।
हडूप डिस्ट्रिब्यूटेड फाइल सिस्टम (HDFS)
हडूप में, वितरित भंडारण को हडूप डिस्ट्रिब्यूटेड फाइल सिस्टम (HDFS) कहा जाता है। यह सिस्टम अनावश्यक भंडारण प्रदान करता है और इसकी निम्नलिखित विशेषताएं हैं:
-
यह कमोडिटी हार्डवेयर पर डेटा को मज़बूती से स्टोर करने के लिए डिज़ाइन किया गया है।
-
यह हार्डवेयर विफलताओं की अपेक्षा करके बनाया गया है।
-
यह बड़ी फ़ाइलों और बैच इंसर्ट के लिए अभिप्रेत है। (एक बार लिखें, कई बार पढ़ें।)
HBase
HBase एक वितरित, कॉलम-उन्मुख NoSQL डेटाबेस है। HBase अपने अंतर्निहित भंडारण के लिए HDFS का उपयोग करता है और मैपरिड्यूस का उपयोग करके बैच-शैली गणना और पॉइंट क्वेरी (यादृच्छिक पढ़ने) दोनों का समर्थन करता है।
HBase निम्नलिखित कार्य भी करता है:
-
कमोडिटी हार्डवेयर के क्लस्टर पर बड़े डेटा वॉल्यूम (अरबों पंक्तियों तक) स्टोर करता है।
-
लॉग, दस्तावेज़, रीयल-टाइम एक्टिविटी फीड और कच्चे आयातित डेटा को बल्क में स्टोर करता है।
-
हडूप एप्लिकेशन द्वारा उपयोग किए जाने वाले डेटा पर लगातार रीड और राइट करता है।
-
मैपरिड्यूस कार्यक्षमता का उपयोग करके डेटा स्टोर को एकत्रित या प्रोसेस करने में सक्षम बनाता है।
-
एनालिटिक्स और मशीन लर्निंग के लिए एक डेटा प्लेटफॉर्म प्रदान करता है।
HCatalog
HCatalog हडूप के लिए एक टेबल और स्टोरेज मैनेजमेंट लेयर है जो हडूप एप्लिकेशन जैसे Pig™, मैपरिड्यूस, और Hive™ को फ़ाइलों के विपरीत टेबुलर फॉर्मेट में डेटा पढ़ने और लिखने में सक्षम बनाता है।
यह निम्नलिखित सुविधाएं भी प्रदान करता है:
-
हडूप एप्लिकेशन द्वारा उपयोग किए जाने वाले डेटा को स्टोर करने के लिए एक केंद्रीकृत स्थान।
-
अनुक्रमित और पुनरावृत्त हडूप प्रक्रियाओं के लिए एक पुन: प्रयोज्य डेटा स्टोर।
-
रिलेशनल एब्सट्रैक्शन में डेटा स्टोरेज।
-
मेटाडेटा प्रबंधन।
वितरित प्रोसेसिंग
हडूप वितरित प्रोसेसिंग को सक्षम करने के लिए मैपरिड्यूस और येट अनदर रिसोर्स नेगोशिएटर (YARN) पर निर्भर करता है।
मैपरिड्यूस
मैपरिड्यूस एक वितरित डेटा प्रोसेसिंग मॉडल और निष्पादन वातावरण है जो कमोडिटी मशीनों के बड़े क्लस्टर पर चलता है। मैपरिड्यूस आपको आपके द्वारा संग्रहीत डेटा से अंतर्दृष्टि बनाने में सक्षम बनाता है। यह सभी ऑपरेशंस को मैप या रिड्यूस फ़ंक्शन में तोड़ने के लिए मैपरिड्यूस एल्गोरिदम का उपयोग करता है।
मैपरिड्यूस निम्नलिखित लाभ प्रदान करता है:
-
बड़े और असमान डेटा सेट पर एकत्रीकरण (गिनती, सॉर्टिंग और फ़िल्टरिंग)।
-
मैप या रिड्यूस कार्यों का स्केलेबल समानांतरता।
-
वितरित कार्य निष्पादन।
YARN
YARN अपाचे हडूप इकोसिस्टम के लिए क्लस्टर और रिसोर्स मैनेजमेंट लेयर है। यह हडूप फ्रेमवर्क की दूसरी पीढ़ी की मुख्य विशेषताओं में से एक है।
YARN निम्नलिखित कार्यक्षमता प्रदान करता है:
-
यह कार्यों को प्राथमिकता देने के लिए एप्लिकेशन शेड्यूल करता है और बिग डेटा एनालिटिक्स सिस्टम को बनाए रखता है।
-
एक बड़ी आर्किटेक्चर के एक भाग के रूप में, YARN विशिष्ट क्वेरी के लिए डेटा पुनर्प्राप्ति के लिए डेटा को एकत्र और सॉर्ट करता है।
-
यह विशेष एप्लिकेशन को संसाधन आवंटित करने में मदद करता है और अन्य प्रकार के संसाधन निगरानी कार्यों का प्रबंधन करता है।
मशीन लर्निंग
हडूप अपाचे महआउट के माध्यम से मशीन लर्निंग का समर्थन करता है, एक ओपन-सोर्स प्रोजेक्ट जिसका उपयोग मुख्य रूप से स्केलेबल मशीन लर्निंग एल्गोरिदम बनाने के लिए किया जाता है। महआउट एक डेटा माइनिंग फ्रेमवर्क है जो आमतौर पर बड़ी मात्रा में डेटा प्रबंधित करने के लिए पृष्ठभूमि में हडूप इंफ्रास्ट्रक्चर के साथ चलता है।
महआउट निम्नलिखित क्षमताएं प्रदान करता है:
-
बड़े डेटा वॉल्यूम पर डेटा माइनिंग कार्य करने के लिए एक तैयार फ्रेमवर्क।
-
हडूप के शीर्ष पर लिखे गए एल्गोरिदम, जो महआउट को वितरित वातावरण में अच्छी तरह से काम करने में सक्षम बनाते हैं।
-
बड़े डेटा सेट का त्वरित विश्लेषण।
-
विकासवादी प्रोग्रामिंग के लिए वितरित फिटनेस फ़ंक्शन क्षमताएं। इसमें मैट्रिक्स और वेक्टर लाइब्रेरी भी शामिल हैं।
वर्कफ़्लो मॉनिटरिंग और शेड्यूलिंग
Oozie हडूप की नौकरियों के प्रबंधन की प्रणाली है। यह वर्कफ़्लो शेड्यूलर निर्भर नौकरियों के लिए वर्कफ़्लो चलाता है। यह उपयोगकर्ताओं को वर्कफ़्लो के निर्देशित चक्रीय ग्राफ (DAGs) बनाने में सक्षम बनाता है जो हडूप में समानांतर और अनुक्रमिक नौकरियां चलाते हैं।
Oozie बहुत लचीला है। आप आसानी से नौकरियों को शुरू, रोक, निलंबित और पुनः चला सकते हैं। Oozie असफल वर्कफ़्लो को फिर से चलाना भी बहुत आसान बनाता है।
Oozie स्केलेबल है और एक हडूप क्लस्टर में हजारों वर्कफ़्लो (प्रत्येक में दर्जनों नौकरियां) के समय पर निष्पादन का प्रबंधन कर सकता है।
स्क्रिप्टिंग
डेवलपर हडूप में स्क्रिप्टिंग के लिए अपाचे पिग का उपयोग कर सकते हैं। स्क्रिप्टिंग जटिल मैपरिड्यूस ट्रांसफॉर्मेशन बनाने के लिए एक SQL-आधारित भाषा और निष्पादन वातावरण का उपयोग करती है। हालांकि पिग पिग लैटिन कोडिंग भाषा में लिखी गई है, लेकिन इसे निष्पादन योग्य मैपरिड्यूस नौकरियों में अनुवादित किया जाता है। पिग उपयोगकर्ताओं को जावा का उपयोग करके विस्तारित या उपयोगकर्ता-परिभाषित फ़ंक्शन (UDF) बनाने में भी सक्षम बनाता है।
पिग निम्नलिखित भी प्रदान करता है:
-
HDFS में कच्चे डेटा पर एक्सट्रैक्ट-ट्रांसफॉर्म-लोड (ETL) कार्यों और प्रक्रियाओं को निष्पादित करने के लिए एक स्क्रिप्टिंग वातावरण।
-
जटिल मैप रिड्यूस फ़ंक्शन बनाने और चलाने के लिए एक SQL-आधारित भाषा।
-
बड़े और असमान डेटा सेट पर डेटा प्रोसेसिंग, स्टिचिंग और स्कीमैटाइज़िंग।
-
एक हाई-लेवल डेटा फ्लो भाषा।
-
एक एब्सट्रैक्शन लेयर जो आपको डेटा प्रोसेसिंग पर ध्यान केंद्रित करने में सक्षम बनाती है।
निष्कर्ष
हडूप और मैपरिड्यूस फ्रेमवर्क का पहले से ही बायोइनफॉरमैटिक्स समुदाय में एक बड़ा उपयोगकर्ता आधार है, विशेष रूप से अगली पीढ़ी के अनुक्रमण विश्लेषण के क्षेत्र में। इस क्षेत्र में इसकी लोकप्रियता आंशिक रूप से इसके मजबूत, फॉल्ट-टॉलरेंट HDFS के कारण है।
HBase एक वितरित, फॉल्ट-टॉलरेंट, स्केलेबल डेटाबेस जोड़ता है जो HDFS फाइल सिस्टम के शीर्ष पर बनाया गया है, जिसमें डेटा के लिए रैंडम रीयल-टाइम रीड और राइट एक्सेस है। आप स्केलेबल मशीन लर्निंग लाइब्रेरी बनाने के लिए महआउट, या बैच प्रोसेसिंग डेटा के लिए पिग को भी देखना चाह सकते हैं।
इस श्रृंखला के भाग 2 में, हम हडूप इकोसिस्टम के अधिक घटकों को कवर करेंगे।
कोई टिप्पणी करने या प्रश्न पूछने के लिए फीडबैक टैब का उपयोग करें।