स्थानिक खोज संरचनाएं (Spatial Search Structures) उन्हीं विचारों पर आधारित हैं जिनका आविष्कार कंप्यूटर साइंस में 60 और 70 के दशक में बड़ी संख्या में प्रतीकात्मक डेटा (Symbolic Data) को जल्दी से संसाधित करने की समस्या को हल करने के लिए किया गया था, ज्यामितीय डेटा (Geometric Data) के विपरीत, उदाहरण के लिए लोगों के नामों की सूची। यह आविष्कार किया गया था कि नामों की सूची को वर्णमाला के अनुसार सॉर्ट करके, और सॉर्ट की गई सूची को एक एरे में संग्रहीत करके, कोई नया नाम पहले से सूची में है या नहीं, इसकी गणना बाइनरी सर्च एल्गोरिदम का उपयोग करके log₂n ऑपरेशन्स में की जा सकती है, बजाय अनुक्रमिक खोज (Sequential Search) के साथ अपेक्षित n/2 ऑपरेशन्स के। यह नामों की सूची में मौजूद संरचना (वर्णमाला क्रम) को निकालने और बाद के ऑपरेशन्स (नाम खोजना) में उस संरचना का फायदा उठाकर गणना को कम करने का एक अच्छा उदाहरण है।
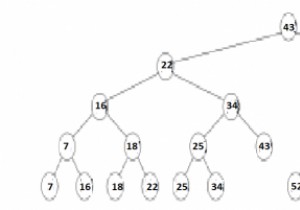
हालांकि, यदि कोई नामों को जोड़ने और हटाने की अनुमति देना चाहता है जबकि सॉर्ट की गई सूची को बनाए रखता है, तो एक डायनामिक डेटा स्ट्रक्चर की आवश्यकता होती है, यानी पॉइंटर्स (Pointers) लागू करने वाला। ऐसे डेटा स्ट्रक्चर का सबसे आम उदाहरण बाइनरी सर्च ट्री (Binary Search Tree) है।
बाइनरी सर्च ट्री के मामले में, जहां इसका उपयोग पूर्णांकों (Integers) के एक सेट को दर्शाने के लिए किया जाता है जैसे A = {1, 2, 5, 6, 7, 9} वास्तविक रेखा (Real Line) पर स्थित। यह गणना करने के लिए कि कोई संख्या/बिंदु पहले से ट्री में है या नहीं, कोई बिंदु को ट्री में सम्मिलित कर सकता है और नेस्टेड अंतराल (Nested Intervals) के अनुक्रम का पालन कर सकता है जिसमें बिंदु होता है। एक संतुलित ट्री (Balanced Tree) के लिए, इस प्रक्रिया में O(log n) से अधिक चरण नहीं लगेंगे; वास्तव में, हमने बाइनरी सर्च किया है, लेकिन एक एरे के बजाय ट्री का उपयोग करके। अब, ट्री स्वयं खोज एल्गोरिदम के एक हिस्से को एन्कोड करने में सक्षम है क्योंकि यह तय करता है कि खोज किस क्रम में आगे बढ़ती है।
यह अब हमें पार्टीशनिंग ट्रीज़ (Partitioning Trees) पर वापस लाता है, उन्हें बाइनरी सर्च ट्रीज़ के आयाम > 1 यानी बहुआयामी (Multi-dimensional) (1D में, वे अनिवार्य रूप से समान हैं) के सामान्यीकरण (Generalization) के रूप में माना जाता है। वास्तव में, पार्टीशनिंग ट्री बनाना क्विक सॉर्ट (Quick Sort) के ज्यामितीय संस्करण के रूप में माना जा सकता है।
परिवर्तन (डिलीशन और इंसर्शन) ट्रीज़ को मर्ज करके प्राप्त किए जाते हैं, मर्ज सॉर्ट (Merge Sort) में सॉर्ट की गई सूचियों को मर्ज करने के समान।
हालांकि, चूंकि बिंदु किसी भी आयाम > 1 के लिए स्थान को विभाजित नहीं करते, हमें उप-विभाजित (Subdivide) करने के लिए हाइपरप्लेन्स (Hyperplanes) का उपयोग करना चाहिए न कि बिंदुओं का।
हाइपरप्लेन्स हमेशा आयाम की परवाह किए बिना एक क्षेत्र को दो आधे स्थानों (Half Spaces) में विभाजित या पार्टीशन करते हैं।